所謂 Gemini 4 benchmark leak,目前只有一張標示「PREDICTED」的預測表;Google 在 2026 年 7 月 21 日確認的是預訓練已啟動,尚未公開模型 ID、評測方法或 scorecard。 這 7 組百分比只反映市場期待。它們不是 Gemini 4 的測試結果,也不該進入模型採購評分。
這張表很會借可信度。它沿用 GPT-6 Astra 發表資料裡的 benchmark 名稱,也抄進幾組已公開的競品分數,再把 Gemini 4 放在最左邊、全部塗成紫色。只看一眼,很像 Google 的發表投影片。細看表頭,那個「PREDICTED」已經把證據等級說完了。
7 組數字都有小數點,卻沒有一次可追查的測試
流傳表格替 Gemini 4 填上 7 個預測值:Terminal-Bench Science 0.1 為 72.8%、AutomationBench 為 48.7%、FrontierMath Tier 4(v2)為 99.1%、Terminal-Bench 4.0 為 62.3%、HealthBench Professional 為 70.2%、BenchCAD 為 98.6%,ARC-AGI-3 則超過 99.9%。
小數點會讓人誤以為這些結果來自實測。表格沒有交代 Gemini 4 的 checkpoint、推理檔位、agent harness、工具權限、測試 split、樣本數、重複次數、信賴區間或執行紀錄。連可呼叫的 Gemini 4 API model ID 都不存在。缺少這些欄位,72.8% 跟「大概很強」的證據力相同。
| 流傳表格的 Gemini 4 欄位 | 預測值 | 目前缺少的驗證材料 |
|---|---|---|
| Terminal-Bench Science 0.1 | 72.8% | evaluator、agent、tokens、cost、run logs |
| AutomationBench | 48.7% | 私有測試集版本、工具設定、重複執行結果 |
| FrontierMath Tier 4(v2) | 99.1% | 題目版本、holdout 範圍、logs、信賴區間 |
| Terminal-Bench 4.0 | 62.3% | harness、reasoning effort、task-level results |
| HealthBench Professional | 70.2% | length adjustment、grader、rubric 與 run details |
| BenchCAD | 98.6% | task subset、Python sandbox、execution rate、IoU 設定 |
| ARC-AGI-3 | >99.9% | Standard 或 Provider Adapter、公開或半私有集、replays |
Google 確認的是訓練,不是成績
Google 在 7 月 21 日發布 Gemini 3.6 Flash、3.5 Flash-Lite 與 3.5 Flash Cyber 時,第一次明確寫出 Gemini 4:團隊已啟動公司最具企圖心的預訓練,並對進度感到振奮。Alphabet 2026 年第 2 季財報談話也重複同一件事。
那是一項研發進度,不是產品發布。Google 的 Gemini API 模型頁在 9 月 3 日更新後,最新穩定通用模型仍是 gemini-3.8-flash;清單裡沒有 Gemini 4 endpoint、定價、context window 或 system card。Google 也沒有公布上述 7 項成績。
預訓練完成後,模型通常還要經過 post-training、安全測試、產品化與基礎設施調整。即使流傳數字碰巧接近最終結果,也無法證明預測表來自 Google,更無法推知正式服務的速度、成本與可用工具。
這張表的右半邊,幾乎是現成的發表素材
表格之所以像真的,原因不神祕。OpenAI 在 9 月 3 日發布 GPT-6 Astra 時,公開了相同一批 benchmark。當中的 Astra、Claude Fable 5.1 與 GPT-5.6 Sol 欄位,和流傳表格大量重合。
例如 OpenAI 頁面列出的 Terminal-Bench Science 0.1 分數依序是 64.6%、52.6% 與 22.4%;AutomationBench 是 41.4%、31.4% 與 18.1%;FrontierMath Tier 4(v2)是 97.6%、87.8% 與 83.0%。Terminal-Bench 4.0、HealthBench Professional 與 BenchCAD 的數字也能逐項對上。有人只要保留右側現成欄位,再插入一欄預測,就能做出極像發表會比較表的圖片。
右側數字仍不能直接橫比。OpenAI 的表格混合自家執行、第三方公開結果與其他供應商回報值,個別註腳才會交代工具和設定。把註腳裁掉,數字就少了一半的意義。
GPT-6 Astra 的 62.7% 與 99.9%,示範了 harness 能改變什麼
ARC Prize 對 GPT-6 Astra 的測試提供一個難得的對照。同一個模型在 Standard harness 的 ARC-AGI-3 Semi-Private 得到 62.7%;改用 Provider Adapter harness 後,最高觀察值升到 99.9%。後者會保留供應商的 opaque reasoning state,也使用較長任務所需的 context compaction。
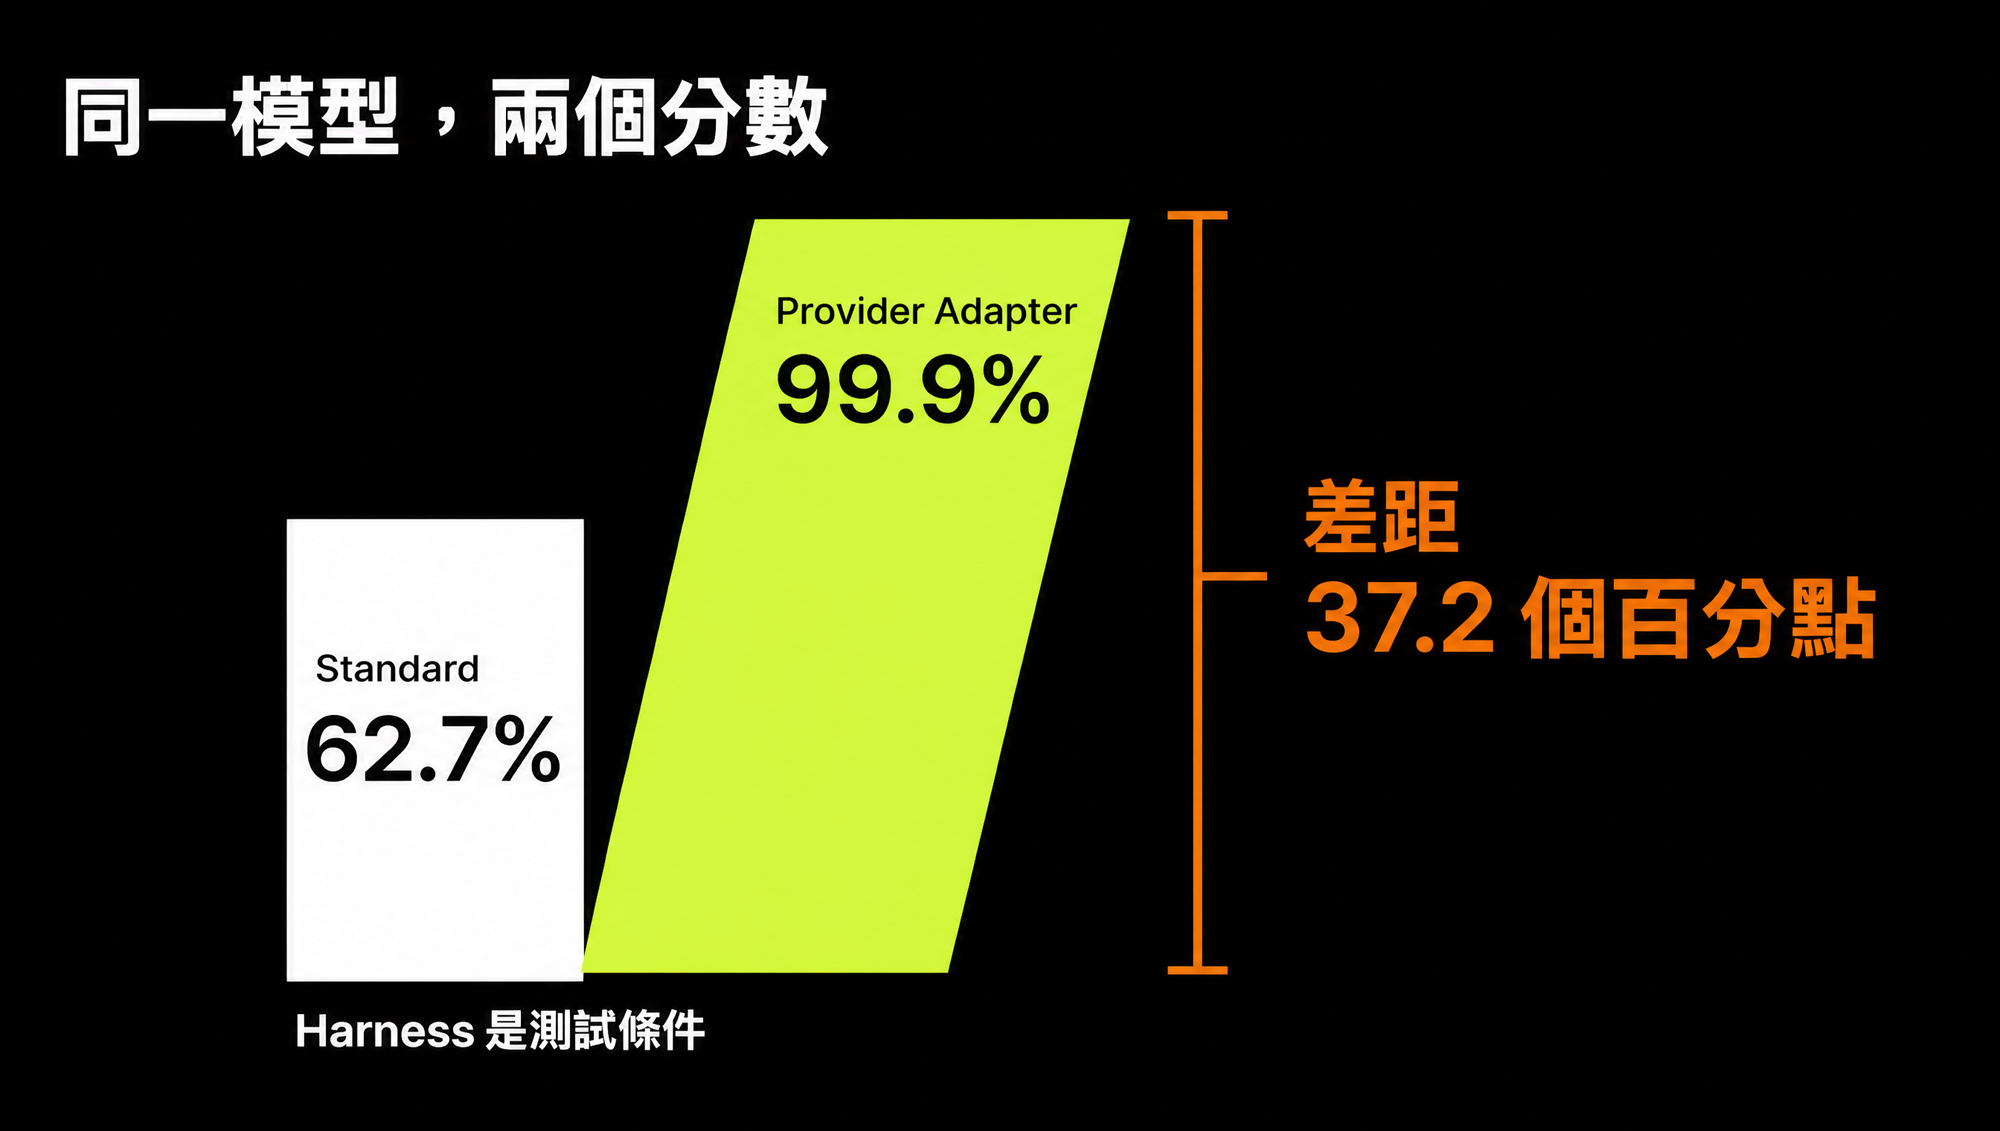
差距是 37.2 個百分點。模型權重沒有因此換掉,系統條件換了。
ARC-AGI-3 的分數也不是一般問答正確率。它衡量 agent 是否完成互動式環境,並以相對人類行動效率計分。100% 代表 agent 完成所有關卡,行動效率達到或超過人類基準;ARC Prize 明確表示,跑滿這個 benchmark 不等於證明 AGI。
同樣的系統效應也出現在 BenchCAD。該 benchmark 的官方頁面顯示,Claude Fable 5.1 加入 Python sandbox 後,Vision2Code 分數從 0.437 升到 0.843;GPT-5.6 Sol 則從 0.706 升到 0.834。流傳表格只留一個 98.6%,卻沒說 Gemini 4 可以使用什麼工具。那不是小註腳,是測試定義。
Benchmark 本身也會改版,版本號不能只當裝飾
Epoch AI 在 6 月 12 日更新 FrontierMath v2,修正了 42% 的題目。新版共有 338 題,其中 Tier 4 從原有集合調整為 43 題;截至 9 月 5 日,Epoch 公開頁面的 Tier 4 最高分是 Claude Fable 5(max)的 87.8% ±5.2%。預測表的 99.1% 沒有信賴區間,也沒有說測了多少 private holdout 題。
Terminal-Bench Science 0.1 的官方榜單則同時列出模型、agent、token 使用量和成本。Claude Opus 5 搭配 Claude Code 的 resolution rate 是 30.0% ±3.2%,花費約 $6,990;GPT-5.6 Sol 搭配 Codex 是 22.4% ±2.9%,花費約 $4,220。OpenAI 自行執行 Astra 時報出 64.6%,這可能是有效結果,但若沒有相同 evaluator 與完整 run artifact,就不能把兩張表的名次直接接起來。
AutomationBench 更直接提醒讀者:公開 repository 有 600 個跨 6 個業務領域的任務,官方 leaderboard 使用另一組保留的 private task set。模型在公開資料重跑出的分數,不必然等於官方榜單。預測表沒有標明使用哪一組,這會直接改變比較基準。
團隊可以用四層證據,把傳聞擋在採購表外
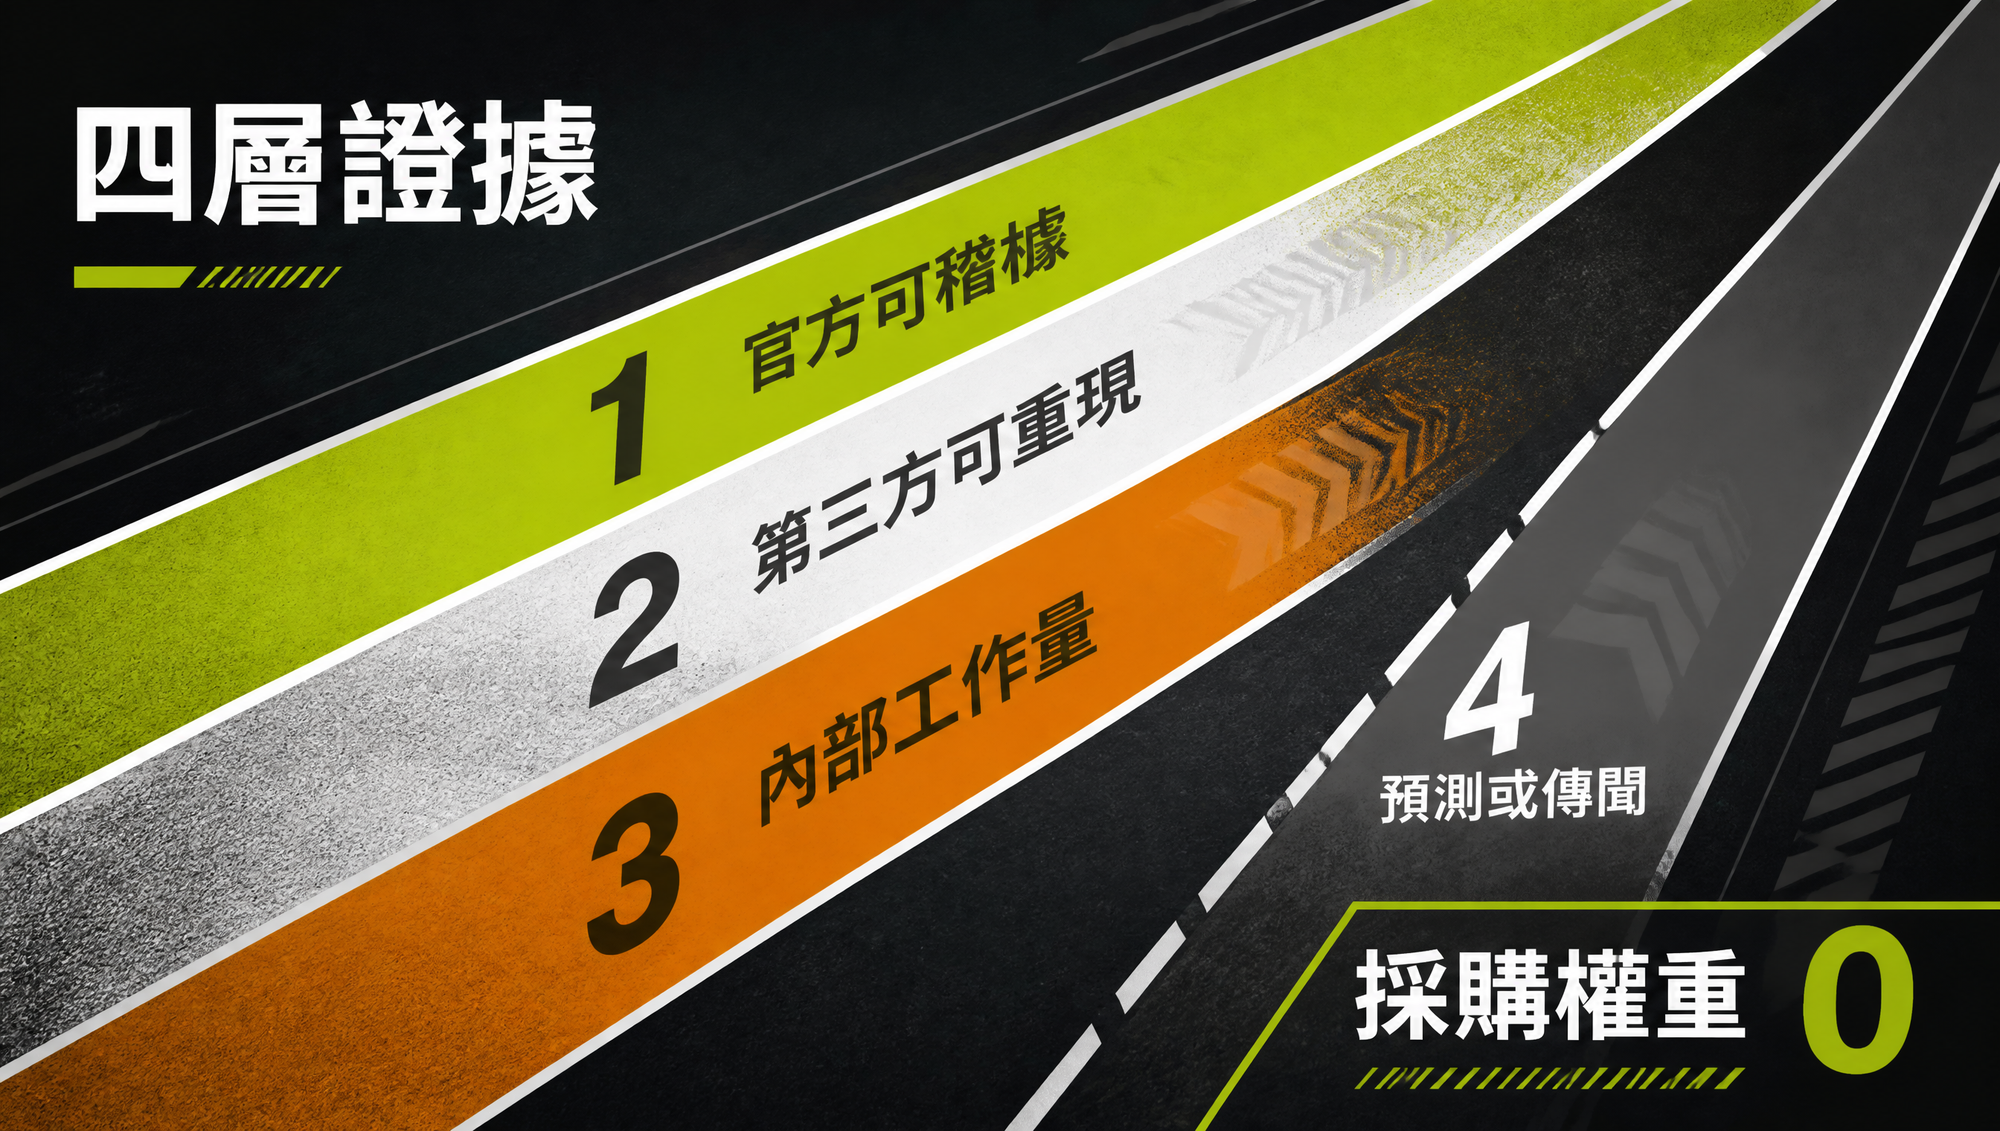
模型評估很容易被一張漂亮表格帶著走。我建議先替每個數字標出證據層級,再決定是否列入採購或模型遷移評分:
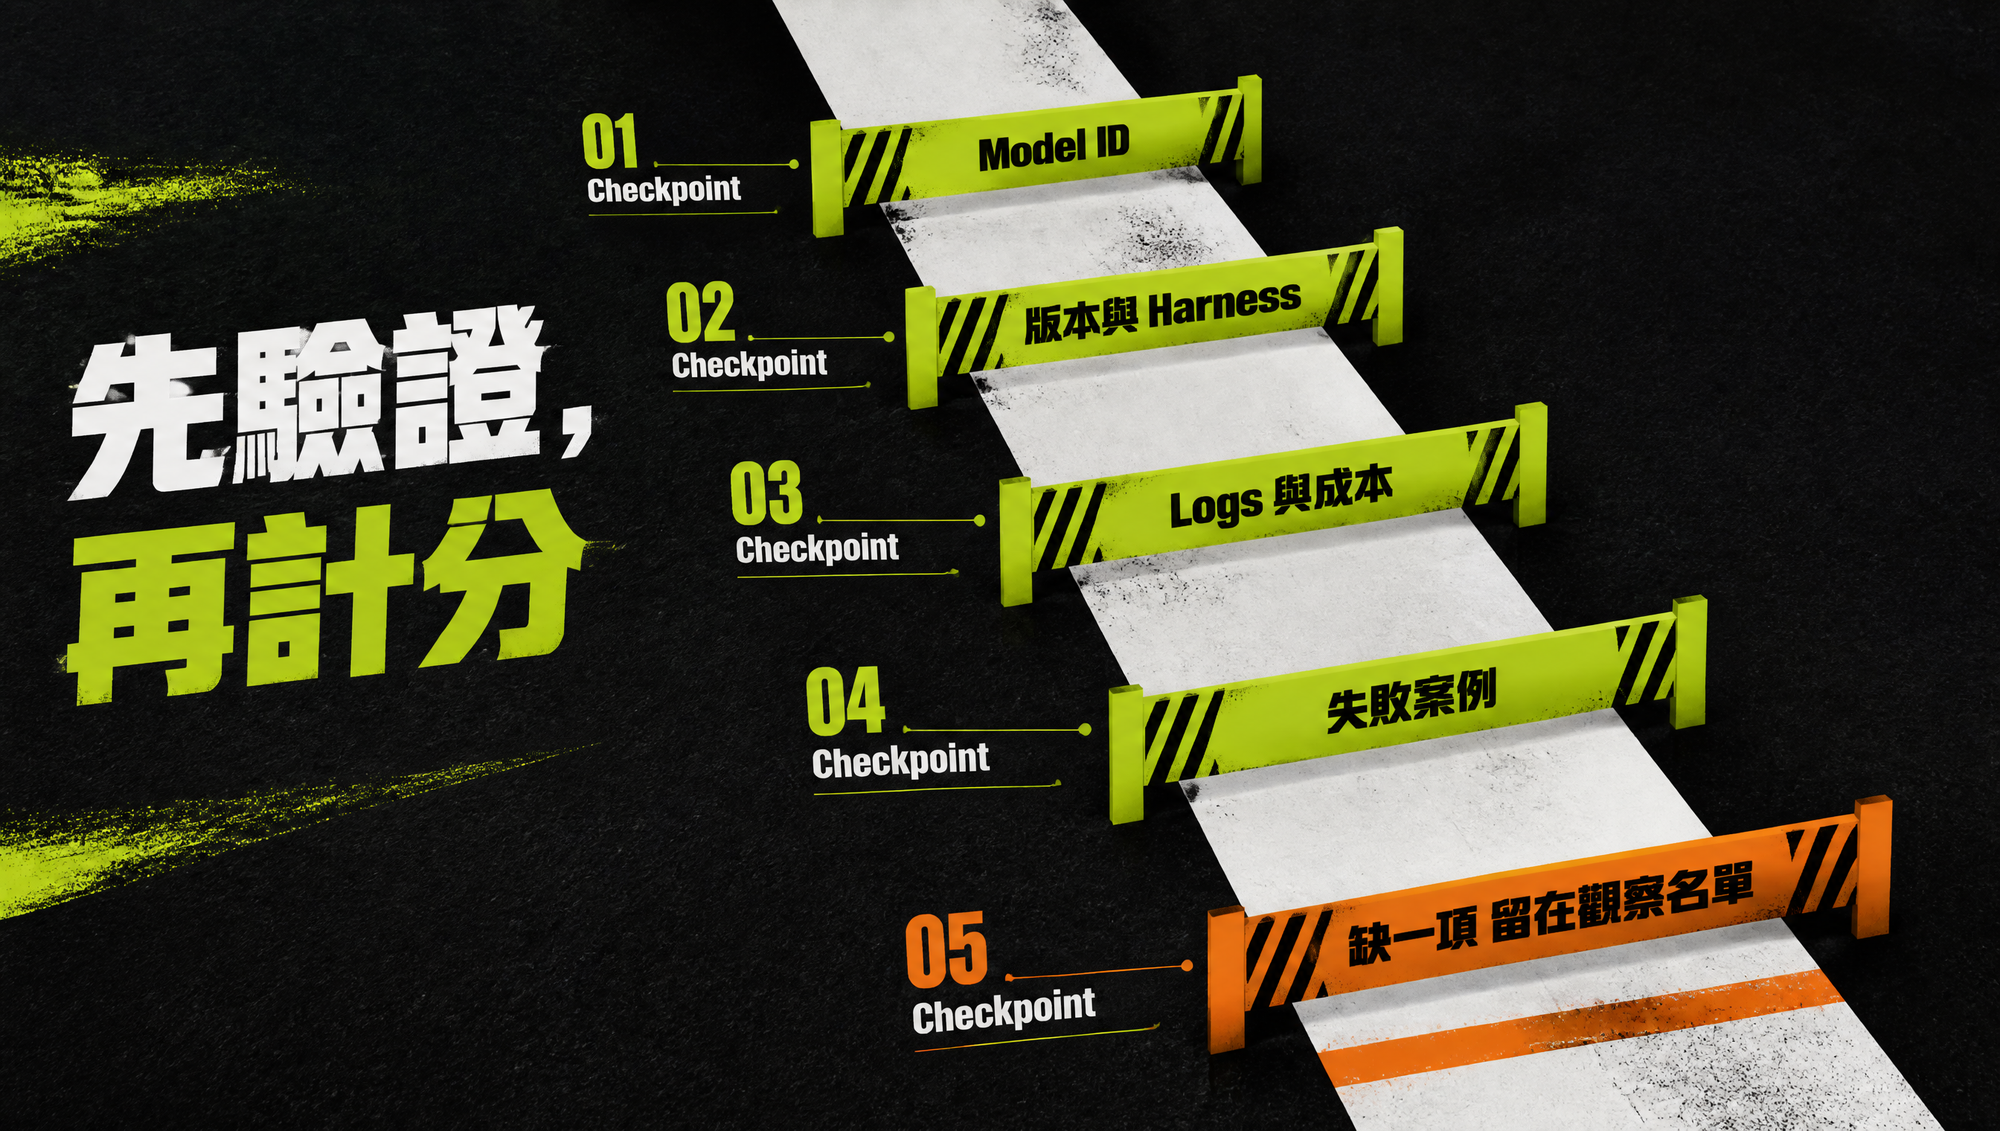
- 官方可稽核結果:模型供應商公布 checkpoint、benchmark 版本、設定與 task-level artifact。可以進候選清單,仍要標註 vendor-run。
- 第三方可重現結果:benchmark 維護者或獨立團隊提供 scorecard、logs、replays 與不確定範圍。可以用來校正供應商數字。
- 內部 workload 結果:團隊固定 prompt、工具、容器、預算和驗收測試,記錄成功率、P50/P95 latency、token、人工返工與 cost per accepted task。這一層才適合決定 migration。
- 預測或傳聞:沒有 model ID 和執行 artifact。可以觀察,評分權重設為 0。
不要把 7 個百分比平均成一個總分。FrontierMath 在測研究級數學,AutomationBench 在測跨應用程式的商業流程,BenchCAD 則把圖像轉成可執行的 CadQuery。三者的樣本、工具與失敗成本都不同。企業真正需要的加權方式,應該從自己的工作量和風險倒推。
常見問題
Gemini 4 已經發布了嗎?
還沒有。Google 已在 2026 年 7 月 21 日確認 Gemini 4 預訓練進行中,但截至 9 月 5 日,Gemini API 公開模型清單沒有 Gemini 4 model ID、價格或 system card。
流傳的 Gemini 4 benchmark 分數是真的嗎?
目前沒有足夠證據把它們稱為測試結果。表格本身標示「PREDICTED」,也沒有附 run logs、scorecard、checkpoint、測試設定或 Google 官方來源。
為什麼預測表裡的競品分數看起來都對?
多數比較欄位可在 GPT-6 Astra 的官方發表資料找到。沿用真實 benchmark 名稱與已公開競品數字,再插入一欄預測,會讓圖片看起來很像正式評測。
ARC-AGI-3 的 99.9% 能證明模型接近 AGI 嗎?
不能。ARC Prize 把 100% 定義為在該互動式 benchmark 內完成所有關卡,並達到人類基準的行動效率;官方也明說,飽和 ARC-AGI-3 不等於證明 AGI。Harness 還能讓同一模型的分數從 62.7% 變成 99.9%。
企業現在該怎麼處理 Gemini 4?
把它列入觀察名單,不要列入採購排名。等 Google 公布可呼叫的 model ID、價格、system card 與可追查的 benchmark artifact,再用固定的內部工作量做 head-to-head 測試。
權威來源
- Google:Introducing Gemini 3.6 Flash, 3.5 Flash-Lite, and 3.5 Flash Cyber
- Google AI for Developers:Gemini API Models
- OpenAI:GPT-6 Astra — A New Generation of Intelligence
- ARC Prize:OpenAI's GPT-6 Astra on ARC-AGI-3
- Epoch AI:FrontierMath Tier 4 (v2)
- Terminal-Bench Science:0.1 Leaderboard
- Zapier:AutomationBench
- BenchCAD:A Benchmark for Programmatic CAD
Author Insight
我不反對有人看好 Gemini 4。讓我不放心的是,預測表把不確定性縮成表頭下一個小字。Benchmark 會把精確度演得很好:小數點、品牌欄位、整齊配色都在說「這已經測過」。真正的證據通常比較難看,散在 logs、註腳、版本差異與失敗案例裡。採購決策應該相信後者。
術語表
- Checkpoint:特定訓練階段保存的模型權重版本,用來確認測試對象是否一致。
- Agent harness:包住模型的執行系統,包含工具、記憶、context 管理、重試與權限設定。
- Scorecard:記錄 benchmark 執行條件、分數與可追查 artifact 的結果頁。
- Private holdout:不公開給參測者的測試資料,用來降低針對題庫過度調整的風險。
- Cost per accepted task:總模型與工具成本除以通過驗收的任務數。