Meta 於 2026 年 9 月 2 日發布 Muse Spark 1.3,官方比較表列出的 DeepSWE v1.1 成績是 75.4%,但截至 9 月 4 日,DeepSWE 公開榜仍未收錄這筆結果。 這不矛盾:Meta 的新模型在長程軟體工程上明顯進步;這個 75.4% 也還不是第三方榜單已獨立驗證的名次。開發團隊若只記得「第一名」,就會漏掉模型、推理檔位、Agent harness 與成績來源四個採用條件。
編輯註:本文已於 2026 年 9 月 4 日依 Meta 官方發布頁、評測方法文件與各基準公開榜重寫。初版曾引用失效網址,並把 Meta 自行評測寫成第三方榜單結論;相關敘述均已更正。
這次更新先處理 Agent 的工作方式
Muse Spark 1.3 已開始在 Muse Code 與 Meta Model API 推出。Meta 表示,既有的推理檔位已可使用,max 則要等額外安全測試完成後才會開放。官方比較表把 Muse Spark 1.3 標為 max,使用者在正式環境當下能取得的版本,未必與表中的最高檔位完全相同。
相較 1.2,Meta 把這次改進集中在長時間、多工具的工作流程。模型會在資訊混亂或互相衝突時補齊脈絡、修正計畫,也更知道何時向使用者求助、何時在不可逆動作前確認。Meta 工程師的內部比較顯示,1.3 約少用 20% 工具呼叫與 25% Token,同時減少不必要的回合與冗長輸出。
這些數字把改版效益指向可量測的成本,但仍是供應商自己的比較。它們適合提出一個可測的假設:如果相同任務真的少走四分之一的 Token,模型即使單價不變,也可能降低每個完成任務的成本。它們不等於任何程式庫、工具組合或權限政策下都會自動省下 25%。
75.4% 是真的,成績來源也必須寫在同一行
Meta 的評測方法文件說得很清楚:Muse Spark 1.3 的結果由 Meta 透過 Meta Model API 產生;比較表中的其他模型成績,可能來自 Meta 自行執行、官方榜單或模型供應商自報,並取「可比較的最高主要指標」。對第三方模型的測試則是盡力而為,提示、工具與執行環境不一定針對那些模型最佳化。
DeepSWE v1.1 一欄的做法更具體。這套基準包含 113 個任務,橫跨 91 個程式庫與五種語言,功能與回歸測試都要通過才算成功。Meta 使用 mini-swe-agent 搭配 Muse Spark 1.3 max 自行跑出 75.4%,其餘模型則取自 Datacurve 的公開榜單。
截至 9 月 4 日,DeepSWE 公開榜列出的頂端成績是 Gemini 3.8 Flash high 與 Claude Opus 5 max 的 74%,接著是 GPT-5.6 Sol max 的 73%;榜上仍沒有 Muse Spark 1.3。公開榜也明載所有模型統一使用 mini-swe-agent,並顯示多次執行後的誤差範圍。Meta 的單一比較值沒有附上同樣的信賴區間。
因此,75.4% 可以寫成「Meta 自行評測高於當前公開榜最高值」,不能直接改寫成「DeepSWE 已驗證 Muse Spark 1.3 奪冠」。差別不在咬文嚼字,而在能否重現。
同一張表混合了三種不同的比較
完整表格至少能看出 1.3 對 1.2 的改善,也揭露每一列其實在回答不同問題。
| 評測 | Muse Spark 1.3 | 這個分數能說明什麼 | 還不能說明什麼 |
|---|---|---|---|
| DeepSWE v1.1 | 75.4% | Meta 以 mini-swe-agent、max 檔位自行執行,長程修補任務表現強 |
尚未成為 DeepSWE 公開榜的獨立收錄結果 |
| SWE-Atlas Codebase QnA | 59.4% | 在 124 題程式庫理解任務上,1.3 比 1.2 的 46.2% 高 | 不能與使用 Claude Code、Codex 等原生 scaffold 的列忽略條件直接互換 |
| Terminal-Bench 2.1 | 88.8% | 在 Meta 的內部 Agent 評測框架中,1.3 與 GPT-5.6 Sol 同分 | 並非 Terminal-Bench 官方驗證榜已接納的提交,也不是單獨模型能力 |
| MRCR 512K–1M | 98.1% | 在指定長脈絡檢索設定中,1.3 能準確找回目標字串 | 不能推論百萬 Token 的任意程式庫都能被完整理解 |
SWE-Atlas 特別能說明 harness 的影響。Scale 的公開頁面同時列出 mini-swe-agent 與原生 Claude Code、Codex CLI 等組合,並明確指出原生 scaffold 往往會提高成績。Terminal-Bench 更是直接把 Agent、模型與推理檔位分成不同欄位。把這類成績縮成「模型 A 比模型 B 強」會刪掉系統設計本身。
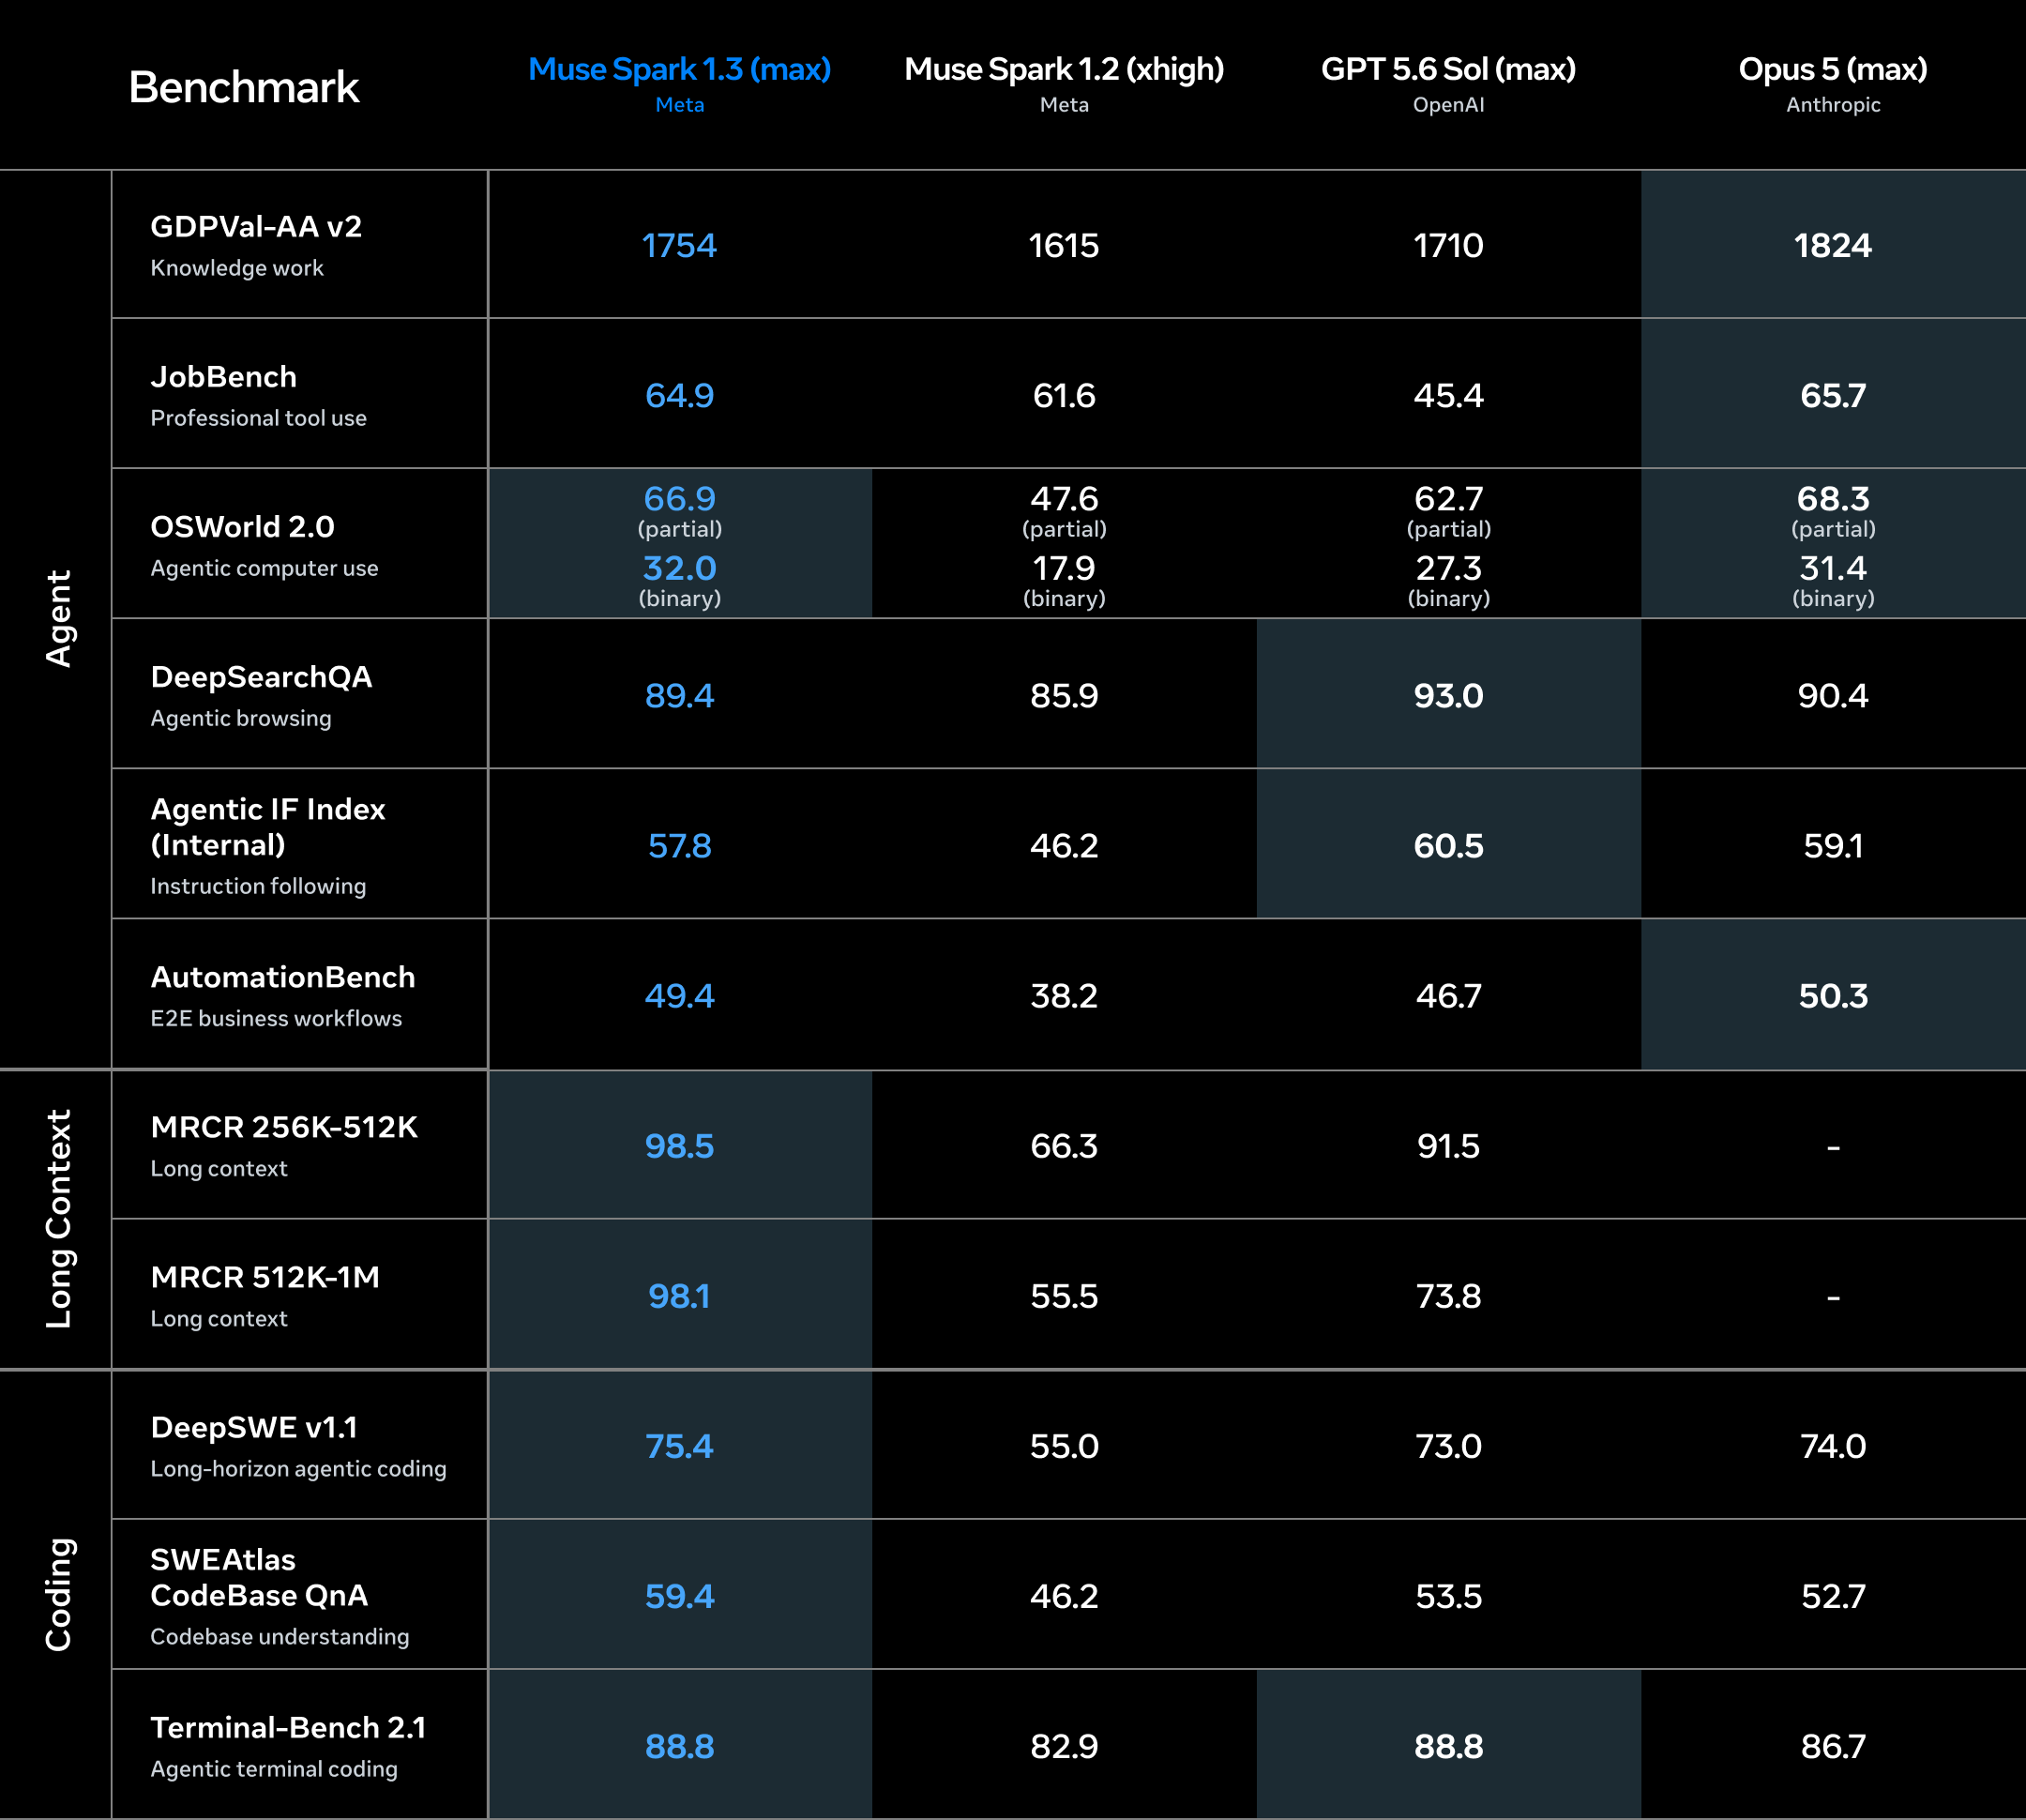
官方表還修正了舊稿的一個關鍵誤讀:Muse Spark 1.3 在 Terminal-Bench 2.1 是 88.8%,與 GPT-5.6 Sol 同分,不是單獨奪冠;AutomationBench 則是 49.4%,並非 47.2%。表中 Opus 5 在 GDPVal-AA v2、JobBench、OSWorld 2.0 與 AutomationBench 仍然較高,GPT-5.6 Sol 在 DeepSearchQA 與 Agentic IF Index 較高。勝負分散在不同欄位,不能拿來證明「全面反超」。
導入前,把四個變數鎖住
開發團隊若想知道 Muse Spark 1.3 是否適合自己的程式庫,先建立一張最小評測卡。每筆結果都要同時記錄四件事:
- 模型版本:固定到
muse-spark-1.3,不要把持續更新的產品名稱當成可重現版本。 - 推理檔位:分開測目前可用的檔位;
max尚未全面開放時,不要拿供應商的max成績當成現況。 - Agent harness:記錄 Muse Code、mini-swe-agent 或自家工具層,以及工具、權限、逾時與重試設定。
- 成績來源:標成供應商自測、公開榜收錄、第三方重現或自家回歸測試,不要混在同一欄。
接著從正式工作挑 30 至 100 個任務,固定容器、提示、工具與驗收測試。除了通過率,也要量測平均工具呼叫、輸入與輸出 Token、P50/P95 延遲、重試次數、人工返工時間,以及每個通過任務的總成本。
每個通過任務成本 = 模型與工具總費用 ÷ 通過驗收的任務數
如果 Muse Spark 1.3 的 20% 工具呼叫與 25% Token 降幅能在這組資料上重現,才是它比 1.2 或其他模型更值得採用的證據。若只是公開榜高出一、兩個百分點,卻增加延遲、拒答或返工,名次就沒有部署價值。
誰該先測,誰可以等
最值得先測的是已經使用 Muse Code 或 Meta Model API,而且工作包含跨檔案修改、長時間規劃、多工具操作與複雜指令的團隊。1.3 的訓練方向正對準這些情境,從 1.2 升級也能用相同工作負載做成對比較。
只需要短回合補字、摘要或單檔修改的服務,不必因 75.4% 就立刻搬遷。正在等待可重現公開成績、max 正式開放或開放權重的團隊,也可以先保留現有模型。Meta 只說未來會推出 Muse Spark 開放權重版本,尚未在本次發布中交代日期或具體版本。
常見問題
Muse Spark 1.3 已經可以使用嗎?
可以。Meta 表示模型已開始在 Muse Code 與 Meta Model API 推出;既有推理檔位可用,max 要等額外安全測試完成後才會開放。
Muse Spark 1.3 是 DeepSWE 第一名嗎?
Meta 的比較表列出 75.4%,高於 9 月 4 日 DeepSWE 公開榜的 74% 頂端成績。但公開榜尚未收錄 Muse Spark 1.3,因此較精確的說法是「Meta 自行評測高於當前公開榜最高值」,不是「DeepSWE 已驗證第一名」。
75.4% 與公開榜成績可以直接比較嗎?
兩邊都使用 mini-swe-agent,因此比不同 harness 的比較更接近。不過 Meta 自行執行 1.3,其他模型取自公開榜;Meta 表格也沒有列出 1.3 的誤差範圍。採用前仍應等待公開收錄或自行重現。
Muse Spark 1.3 可以下載權重嗎?
目前官方提供的存取管道是 Muse Code 與 Meta Model API。Meta 預告未來會推出 Muse Spark 開放權重版本,但沒有在 1.3 發布文中給出日期,也沒有確認就是同一個 1.3 checkpoint。
權威引用
- Meta AI Research — Introducing Muse Spark 1.3
- Meta AI Research — Muse Spark 1.3 Evaluation Methodology
- Datacurve — DeepSWE v1.1 公開榜
- Scale Labs — SWE-Atlas Codebase QnA
- Terminal-Bench — 2.1 官方驗證榜
Author Insight
Muse Spark 1.3 最有價值的訊號,是供應商開始把模型、推理檔位與 Agent 系統綁在一起競爭。75.4 比 74 多出的 1.4 分反而沒那麼關鍵。真實開發選的是一套可重現、可控成本、能通過自家驗收的工作系統;只問「最佳模型」少了一半條件。
術語表
- Agent harness:把模型接到檔案、終端機、瀏覽器與測試器的執行框架。
- 推理檔位:控制模型在回答前投入多少推理計算的設定,例如
high、xhigh、max。 - 公開榜收錄:由基準維護方接納並顯示的成績,通常包含固定設定、重複執行與驗證規則。
- 供應商自測:由模型提供者自行執行並公布的結果;可以是有效證據,但來源必須與第三方驗證分開標示。