AI UI 自動修正要交付通過驗收的歷史最佳版本,不能直接拿最後一輪當答案。 截至 2026 年 9 月 14 日,Playwright 的截圖斷言會先等連續 2 張截圖一致,再與基準比較。但畫面穩定,只能排除一部分干擾;按鈕消失、文字被遮住,仍需要另外檢查。
把設計截圖交給視覺模型,產出第一版網頁,再讓模型看渲染結果繼續修,確實能省掉一部分來回描述。問題在於,每次修改都可能碰到原本正確的地方。卡片寬度對了,文字卻換行;陰影接近了,按鈕卻被擠出容器。
開始迭代前,就要寫清楚接受修改的條件。模型可以提案,測試決定哪些版本有資格留下。若只記錄最後生成的 HTML,前面已經做好的工作便可能被下一輪覆蓋。
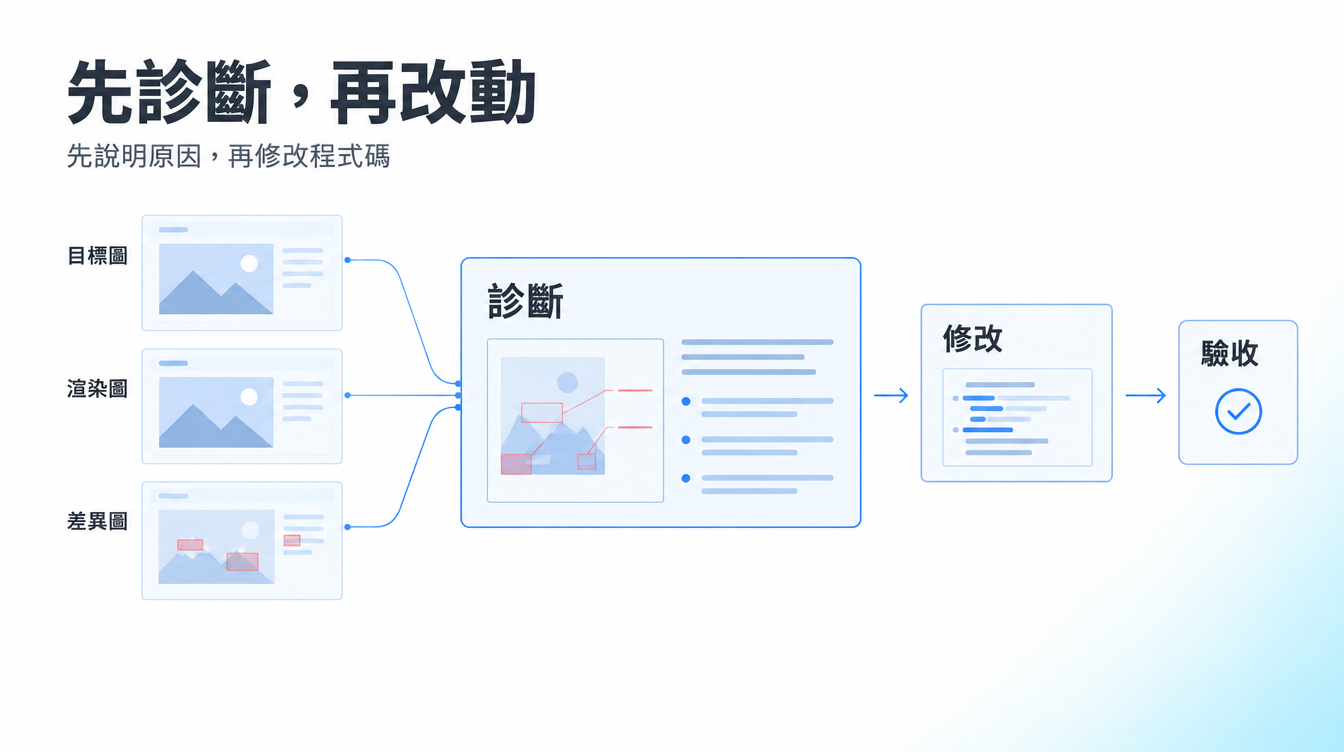
先讓模型診斷,再讓它改 CSS
UI 是使用者介面;Screenshot-to-Code 則是由畫面產生介面程式碼。把它延伸成自動修正流程,可以保留以下順序:
目標截圖 → 模型撰寫 HTML → 瀏覽器以 1:1 渲染並截圖 → 逐像素比較,產生 Diff
                                                               ↓
保留歷史最佳 ← 重新渲染與驗收 ← 模型先寫診斷再改程式碼 ← 原圖+渲染圖+Diff
Diff 是差異圖,用來標出兩張影像在哪些位置不同。它沒有說明偏差由哪個 CSS 屬性造成,也不會判斷畫面是否符合產品需求。整片紅色可能來自卡片位移,也可能只是兩次截圖使用不同字型。
每次修改之前,讓模型依序回答:
- 最大的問題在哪裡?
- 可能是哪個元素、哪個 CSS 屬性造成?
- 準備怎麼改?
診斷完成後才動程式碼。若模型判斷卡片太寬,修改應對應容器寬度、內距或盒模型。一次同時更換字型、圓角與配色,會讓下一次比較難以解釋:分數變好,究竟是哪項修改有效?
可以先用兩種小型元件檢查流程。亮色卡片適合看邊框、硬陰影與留白;深色定價卡片則能暴露漸層、文字對比與功能列表問題。它們有助於找出流程缺陷,但兩個示例不足以證明模型的普遍能力。
修正輪數增加,結果仍可能退步
同一個流程可能出現兩種走勢:某個元件持續接近目標,另一個元件卻在後續修改中退步。後者不必等到頁面完全壞掉才處理。只要候選版本沒有通過原先的接受條件,就讓歷史最佳繼續保留。
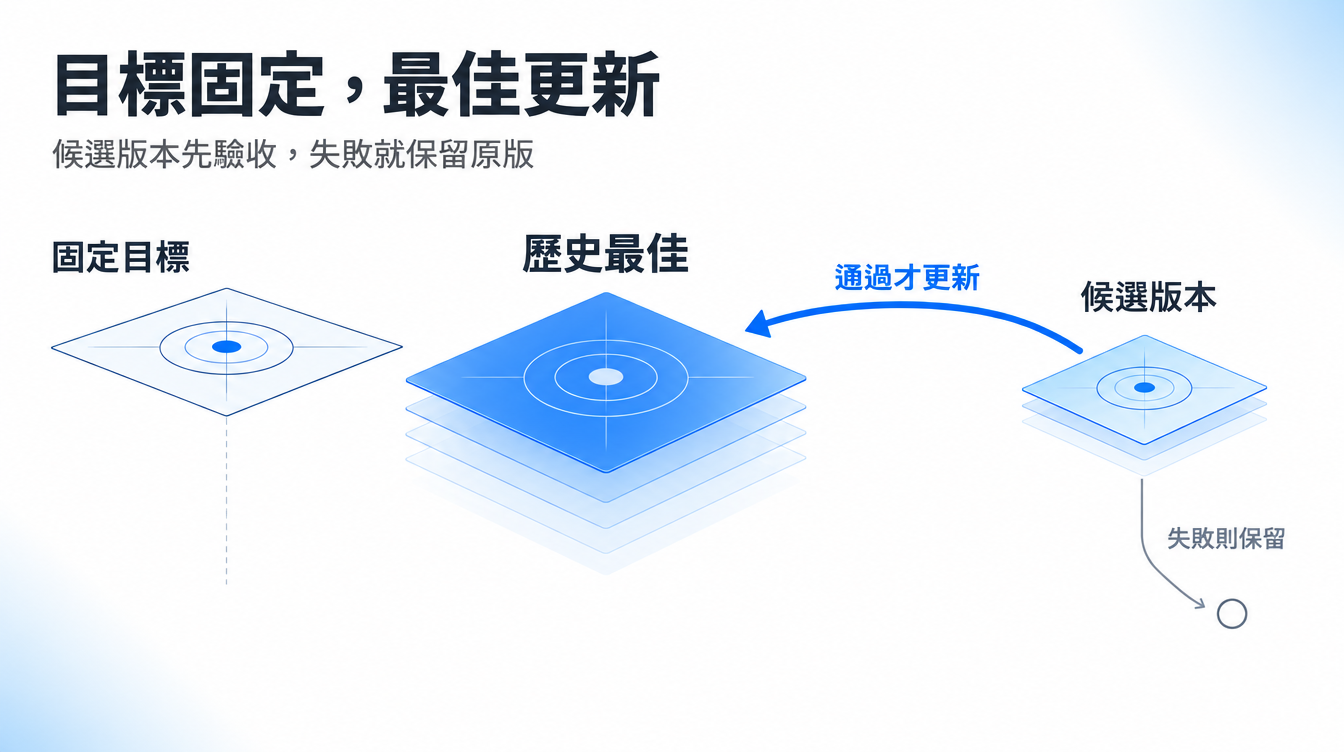
流程中有三份用途不同的資料。reference 是固定的目標畫面;best 是目前通過驗收的最佳實作;candidate 是本輪新產生的版本。best 可以改善,reference 不應跟著模型輸出移動。
如果每次測試失敗就更新基準截圖,相當於把新錯誤寫進答案。Playwright 提供更新截圖功能,適合產品已確認改版後維護測試;它不應成為 AI 修正失敗時的自動補救。Playwright 視覺比較文件
保留版本也要保留測量條件。程式碼版本、截圖及驗收紀錄應能互相對應。只存一個漂亮的 PNG,卻無法找回產生它的程式碼,下一輪就沒有可靠起點。
視覺模型能提供診斷,不能保證收斂
inclusionAI 的 Ling-3.0-flash-VL 是可選的視覺模型之一。官方模型卡列出 124B 總參數、每個 token 啟用 5.5B 參數,支援圖片與影片輸入,最長上下文為 256K tokens。這些規格說明它能接收什麼資訊,沒有保證 UI 修正會逐輪改善。官方模型卡
選模型時,可以讓它先做診斷,不立刻執行修改。檢查它能否把偏差指向實際元素,提出可測試的原因,再評估修正結果。能說出「按鈕太小」只是起點;能辨識父容器限制,才有機會避免反覆調錯層級。
即使停在診斷階段,也能產生有用的工作清單。工程師可以先修最大偏差,再決定是否值得自動化後續步驟。這比用參數量推估開發效率更接近實際成本。
1. 尺寸沒有對齊,Diff 就失去比較基礎
先確認兩張圖片的寬高完全相同。Pixelmatch 是逐像素影像比較函式庫,官方文件明確要求輸入尺寸一致。它的 threshold 範圍為 0 到 1,預設 0.1;這個值控制色彩差異的敏感度,不是允許多少版面錯誤。Pixelmatch 文件
CSS 像素與裝置像素也要分開。假設目標圖片是 600 × 420 像素,截圖策略採每個 CSS 像素輸出一個影像像素,就應在同樣範圍取圖。把較大的截圖事後縮小,會改變文字邊緣與陰影,造成額外干擾。
固定視口還不夠。瀏覽器版本、作業系統與字型都可能改變渲染結果。比較環境改變時,應重新測量既有 best,不能直接拿新分數與舊分數排名。
全頁截圖與元件截圖也不能混用。若目標只有卡片,候選圖卻多了外圍留白,整體誤差可能主要由背景決定。先把比較範圍定清楚,再讓模型解讀顏色。
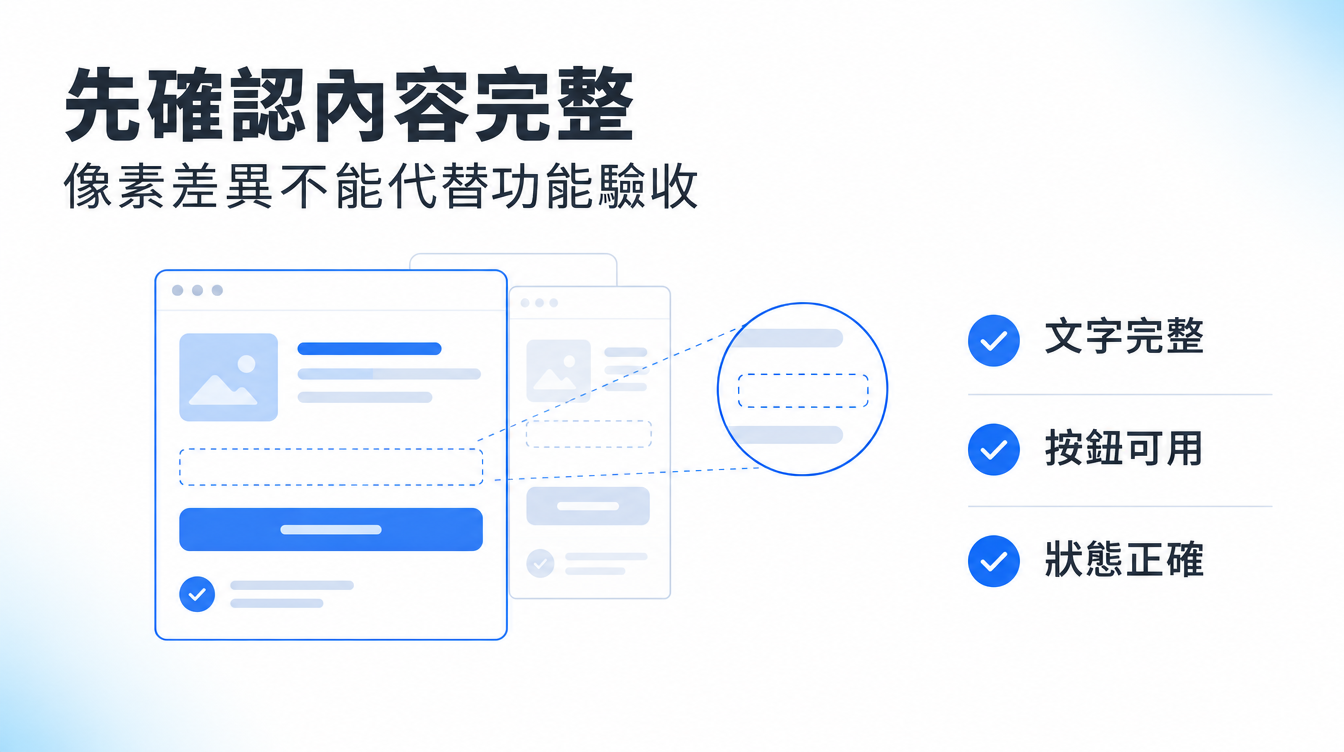
2. 動畫尚未結束,分數可能獎勵缺少內容
假設定價卡片的功能列表正在淡入,截圖時仍接近透明。若背後是大片相近的底色,這個錯誤版本可能比完整顯示文字的版本更容易取得低像素差異。這是評分可能偏離需求的情況,不能靠調高相似度門檻解決。
應先固定要比較的介面狀態。字型載入可等待 document.fonts.ready;MDN 說明,這個 Promise 會在相關字型載入與版面配置完成後解析。它不代表應用程式資料、圖片或每一種動畫都已準備好。MDN 字型就緒文件
Playwright 的 animations: 'disabled' 也有明確語意:有限動畫會快轉到完成,無限動畫則暫停於初始狀態,截圖後再恢復。若產品要驗收的是動畫中段,便要另定可重現的時間點。截圖斷言設定
以下是可放進專案調整的 Playwright 測試範例。它假設已設定 baseURL、頁面具有對應測試識別屬性,且已有人工認可的基準圖。600 × 420、0.2 與 1% 都是示範設定,實際值要由專案驗收標準決定。
import { test, expect } from '@playwright/test';

test.use({
  viewport: { width: 600, height: 420 },
  deviceScaleFactor: 1,
});

test('定價卡片保留內容與版面', async ({ page }) => {
  await page.goto('/pricing-card');
  await page.evaluate(() => document.fonts.ready);

  const card = page.getByTestId('pricing-card');
  const features = card.getByTestId('feature-list');
  const button = card.getByTestId('subscribe-button');

  await expect(features).toBeVisible();
  await expect(features).toHaveCSS('opacity', '1');
  await expect(button).toBeVisible();
  await expect(button).toBeEnabled();

  await expect(page).toHaveScreenshot('pricing-card.png', {
    animations: 'disabled',
    caret: 'hide',
    scale: 'css',
    threshold: 0.2,
    maxDiffPixelRatio: 0.01,
  });
});
threshold 衡量單一像素的色彩差異,maxDiffPixelRatio 才是允許不同像素占整張圖的比例。兩者不能互換。範例中的 0.01 也不代表漏掉 1% 的產品內容可以接受。
上述檢查仍有界線。元素被其他物件遮住,或父層透明,未必會被這組條件完整抓到;按鈕處於啟用狀態,也不代表按下後真的完成正確動作。正式測試還要驗證文字內容、遮擋與預期互動結果。Playwright 元素斷言
3. 從變差的版本續改,會把錯誤帶到下一輪
每輪由 best 建立獨立的 candidate,完成修正後重新渲染。先確認內容與功能檢查通過,再比較視覺結果。候選版本失敗,就保留診斷紀錄,下一輪仍從 best 開始。
功能檢查失敗,就不進入分數比較。若按鈕不能完成預定操作,即使差異像素減少,也不應升級成新的 best。同分時可保留原版本,避免增加沒有可確認收益的變動。
| 驗收情況 | 歷史最佳版本 | 下一步 |
|---|---|---|
| 功能通過,視覺偏差確實減少 | 更新為候選版本 | 記錄改善位置,繼續評估 |
| 分數變好,但必要內容缺少 | 保留既有版本 | 拒絕候選版本,修正診斷 |
| 功能通過,視覺結果沒有改善 | 保留既有版本 | 達停止條件就結束 |
| 截圖尺寸或執行環境改變 | 暫不排名 | 重測既有版本後再比較 |
流程本身也需要測試。可以刻意交給它一個文字消失、像素差異卻下降的候選版本,確認它真的拒絕;再放入一個功能完整、主要偏差減少的版本,確認能被接受。若兩種情況分不開,增加模型呼叫次數沒有幫助。
把停止條件寫進成本預算
每輪支出包含模型呼叫、瀏覽器渲染與驗收。若單次生成很快,重跑字型載入、等資料或人工檢查仍可能佔掉大部分時間。應記錄每輪是否帶來可接受改善,才能判斷自動修正有沒有省下工作。
對固定報價的網站專案,無限制迭代會直接消耗交付毛利。可以事先設定最大輪數、連續未改善的停止條件與人工接手點;數值依元件難度調整,不宣稱存在適用所有頁面的最佳輪數。
執行時守住三條規則:
- 原圖與瀏覽器截圖使用相同尺寸,不再二次縮放。
- 固定視口、字型、動畫狀態與截圖時機。
- 每輪由通過驗收的歷史最佳繼續,拒絕在退步版本上累積修改。
版面修到可接受就停。若剩餘差異涉及字型授權、設計意圖或圖片素材,交給能做決定的人,比再叫模型猜一輪更有效。
常見問題
AI UI 自動修正的分數變好,就能自動交付嗎?
不能。像素分數只反映指定設定下的影像差異。必要內容、互動結果與可用性必須另外通過驗收,才有資格成為歷史最佳版本。
Diff 幾乎整張都是紅色,應該先改 CSS 嗎?
先檢查尺寸、裁切範圍與截圖環境。整體位移或字型不同都可能造成大面積偏差,應排除量測問題後再讓模型修改。
為什麼測試已檢查可見,還要檢查透明度?
可見性斷言不等於完整的人眼可見判斷。透明度、遮擋與父層狀態需要對應檢查,重要操作也要測試實際結果。
一定要使用 Ling-3.0-flash-VL 嗎?
不必。流程可接收其他具備圖片理解與程式碼修改能力的模型。選擇時應在相同截圖及驗收條件下比較有效改善、總耗時與成本。
權威引用
- Playwright:Visual comparisons
- Playwright:PageAssertions,截圖穩定與比較設定
- Pixelmatch:尺寸要求與差異參數
- MDN:FontFaceSet.ready
- Playwright:LocatorAssertions
- inclusionAI:Ling-3.0-flash-VL 官方模型卡
Author Insight
我會先看系統能不能拒絕一個看似高分、實際少了內容的版本。這比展示它連跑多少輪更能說明流程是否可靠。如果拒絕條件仍靠人事後補救,省下的生成時間,很可能只是移到驗收階段。
術語表
| 術語 | 本文用法 |
|---|---|
| Diff | 兩張等尺寸影像的差異圖 |
基準圖 reference |
已確認、固定不隨候選版本改變的目標畫面 |
歷史最佳 best |
通過功能條件、目前視覺結果最佳的實作 |
候選版本 candidate |
本輪待驗收的修改結果 |
| 視口 | 瀏覽器用來配置頁面的可視區域 |
| 收斂 | 修改結果逐步接近既定目標;本文不保證會發生 |