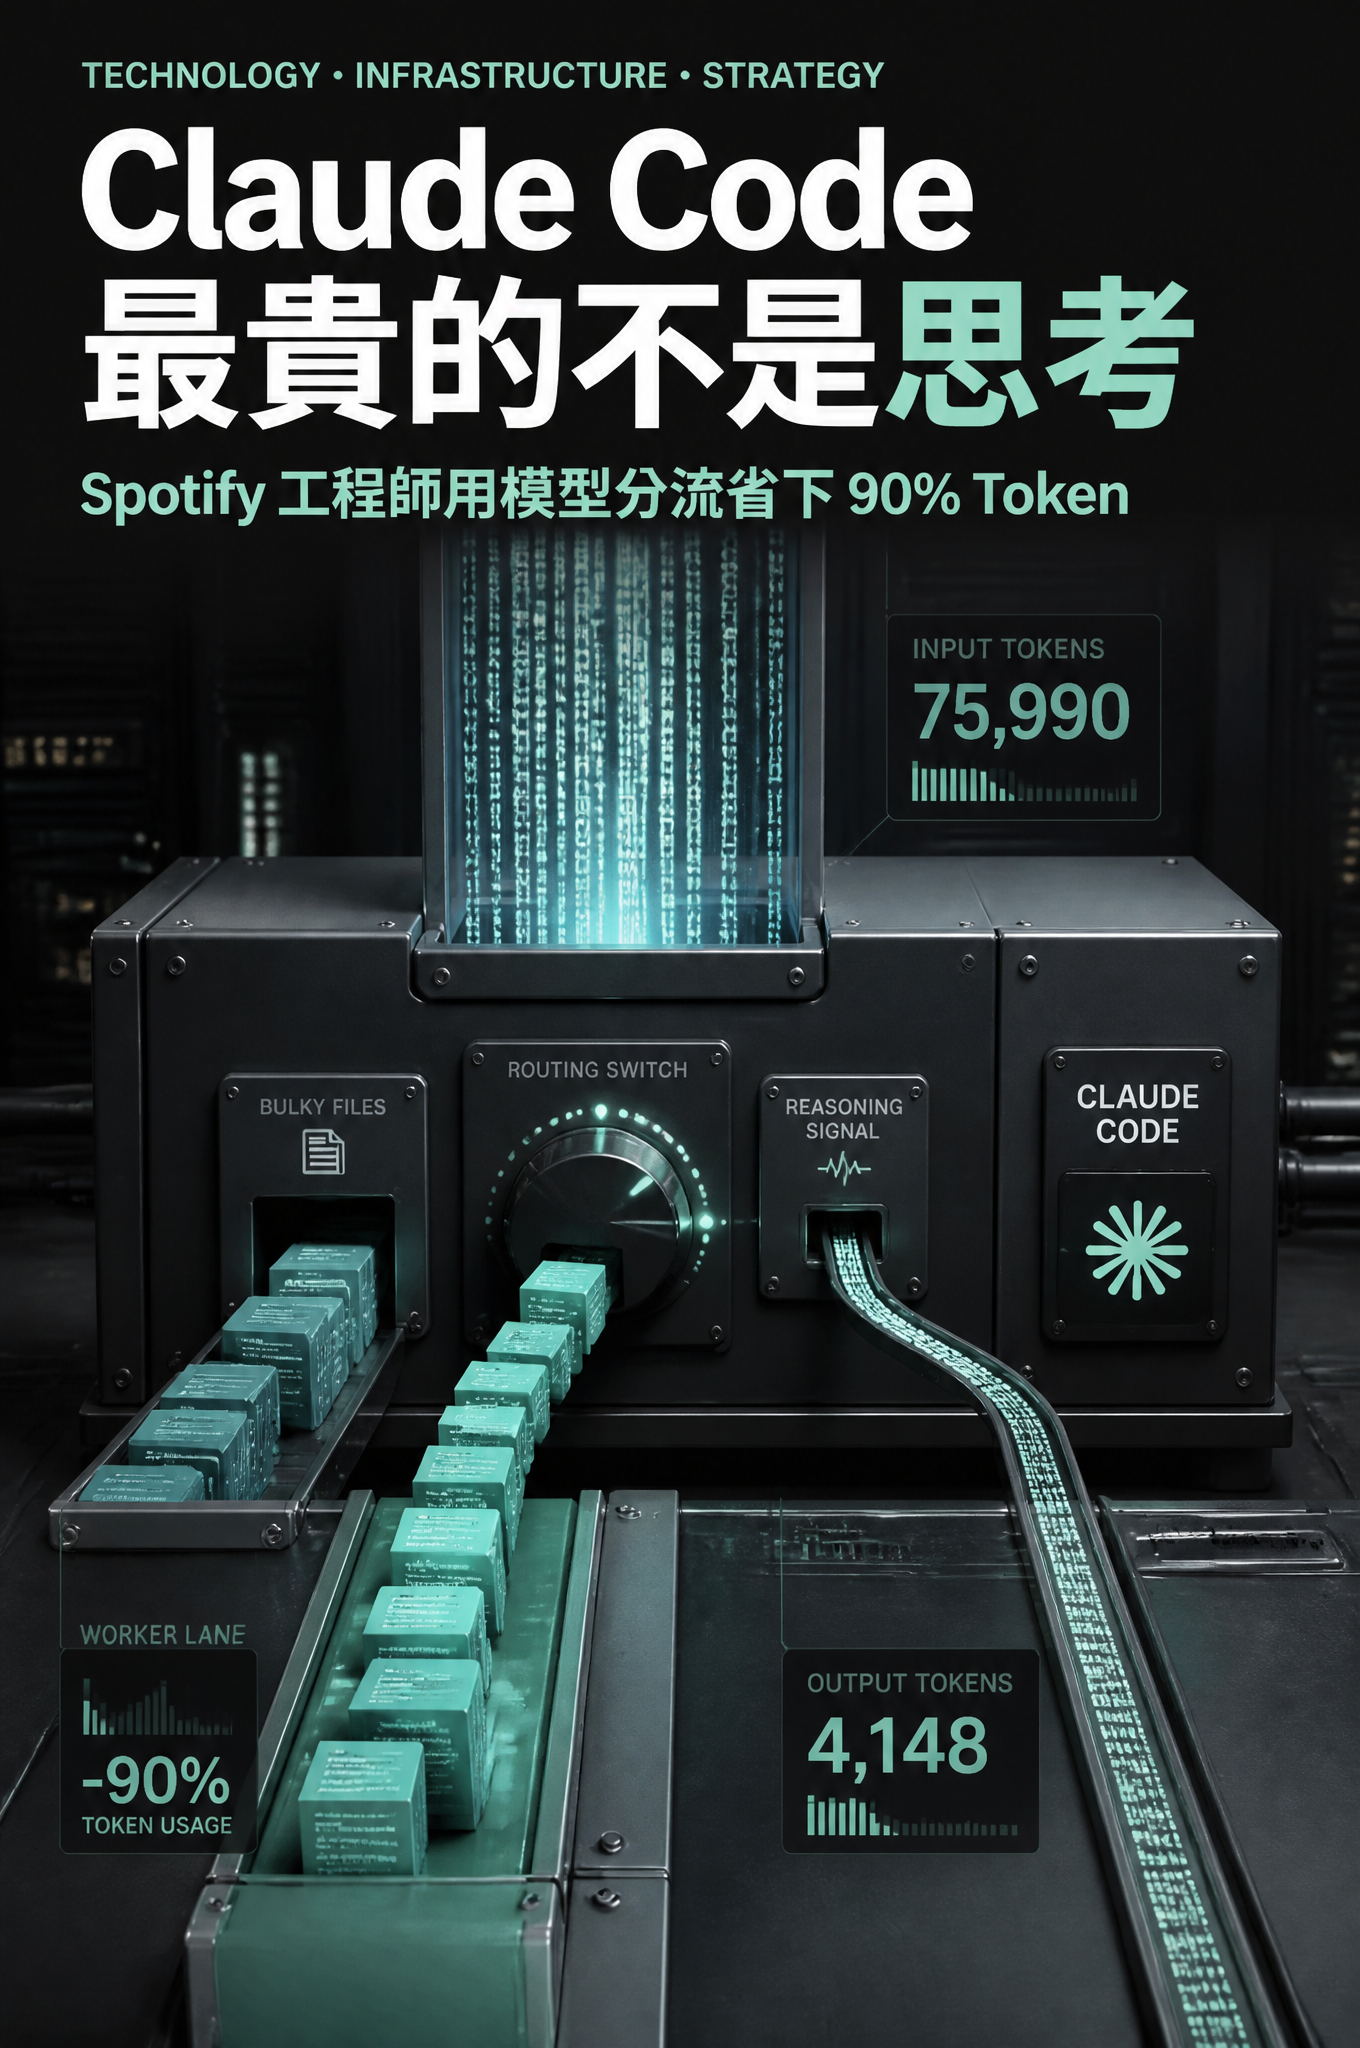
Claude Code 最昂貴的工作,未必是推理。Spotify 工程團隊的 Dimitri Mazmanov 發現,大量 token 耗在讀檔、仿照既有測試與產生樣板程式碼。他用 Portal by Spotify 的 AiKA Modes 加上一個名為 shunt 的 Claude Code plugin,把這些 I/O 工作交給 Gemini 2.5 Flash。四組 Java monorepo 測試中,bulk-read 平均少用約 90% token。
這個結果不是「小模型可以取代前沿模型」。比較值得帶走的結論是:昂貴模型不必親自搬運所有原始內容。讓 hook 判斷何時分流,讓廉價 worker 壓縮或產生可預測內容,再把除錯、架構與安全判斷留給 Claude,才是整套設計的重點。
90% 是怎麼量出來的
Spotify 公開的 shunt README 列出四個情境,測試對象是一個 16.2 萬行的 Java monorepo。前三組是大量讀檔,第四組是樣板程式碼生成。
| 情境 | 讀取行數 | 未使用 shunt | 使用 shunt | 節省 |
|---|---|---|---|---|
| 單一大型檔案 | 4,014 | 33,684 tokens | 5,737 tokens | 82% |
| 原始碼加測試 | 7,408 | 75,990 tokens | 4,148 tokens | 94% |
| 跨服務多檔案 | 1,281 | 16,221 tokens | 821 tokens | 94% |
| code-write | 3,667 | 40,614 tokens,另加生成成本 | 833 行直接寫入磁碟 | 不適合直接比較 |
前三組 bulk-read 的平均節省量約 90%。這是單一工程師、單一程式碼庫與四種情境的測量,不是所有 Claude Code 工作負載都能保證九折。只要任務需要模型看到完整內容、反覆編修或做深度推理,節省幅度就會縮小。
數字仍然很有意思。第二組把 7,408 行原始碼與測試直接交給 Claude 時,用掉 75,990 tokens;先交給 worker 摘要後只進入 4,148 tokens。模型沒有變聰明,真正送進昂貴 context 的資料量與形式變了。
兩個 Mode 把搬運和判斷拆開
AiKA Mode 是 Portal 裡的宣告式 agent。你用設定指定指令、模型、temperature 與 MCP 工具,Portal 提供短暫執行環境、CLI 與 API。Mazmanov 建了兩個 Mode,範例都以 Gemini 2.5 Flash 當 worker。
bulk-reader 接收多個大檔案與一個問題,只回傳結構化重點。提示要求每一點以確切名稱、型別或行號開頭,省掉寒暄、前言和與問題無關的內容。Claude 收到的是壓縮後的證據,不是數千行原始碼。
code-writer 處理測試、設定檔骨架與型別 stub。它一定要收到 reference file,並嚴格仿照現有命名與格式。輸出只能包含程式碼,script 會移除 Markdown fence,也能把結果直接寫入目標檔。Claude 不必先讀完參考檔,再用昂貴的 output tokens 重寫一份可預測內容。
真正有效的是三層路由
把一句「大檔案交給小模型」寫進 CLAUDE.md 不夠。那只是建議,模型可以忽略,每個 repository 也要各放一份。shunt 把路由分成 hook、script 與 skill 三層。
第一層是 PreToolUse hook。check-file-size 會檢查完整 Read,檔案超過預設 350 行就擋下,要求改走 /bulk-reader。帶有 offset 或 limit 的精準讀取會放行。check-bash-read 則攔截用 cat、head、tail、less 或 more 直接吞進大檔案的做法;像 cat file | grep 這種已經縮小範圍的管線仍可通過。
第二層是兩支 shell script。它們負責組裝請求、呼叫 Portal CLI、解包錯誤與回報 token 使用量。bulk-read 用 XML 標籤分隔每個檔案,code-write 接收規格、參考檔與可選的目標路徑。
第三層是 skill。兩份 Markdown 告訴 Claude 什麼時候適合分流,以及 script 的確切呼叫方式。即使模型沒有主動讀懂 skill,hook 仍會攔下昂貴的整檔讀取;skill 讓後續改走 worker 時不必臨場猜指令。
這種設計比「請模型自律」可靠。強制規則放在 hook,可替換的 worker 放在 Mode,使用說明放在 skill。改用另一個廉價模型時,不必重寫攔截邏輯。
安裝與啟用
shunt 已收錄在 Spotify 的 portal-ai-plugins marketplace,程式碼採 Apache 2.0 授權。前提是組織已有啟用 AiKA 的 Portal instance,電腦也要有 jq。
先加入 marketplace 並安裝 Portal 與 shunt:
claude plugin marketplace add spotify/portal-ai-plugins
claude plugin install portal@portal
claude plugin install shunt@portal
開一個新的 Claude Code session,執行:
/portal:setup
這一步會設定 Portal CLI 並完成身分驗證。接著確認 bulk-reader 與 code-writer 是否已經存在:
portal-cli actions aika:list-modes --json --input '{"search": "bulk-reader"}'
很多 Portal instance 已提供公開 Mode。若沒有,可以依官方 README 建立自己的版本。名稱解析會優先選取個人 Mode,再找群組與公開 Mode,因此同名的自訂 bulk-reader 可以覆蓋預設版本,不用改 plugin。
用 350 行當起點,不要當真理
預設門檻是 350 行,可在 .claude/settings.json 調整:
{
  "env": {
    "SHUNT_MIN_LINES": "500"
  }
}
數字該由 latency、worker 價格、檔案結構與摘要品質共同決定。每次委派都多一次網路往返。Spotify 工程文章觀察到通常需要 10 到 30 秒;目前 README 的 SHUNT_TIMEOUT_SECONDS 預設為 180 秒,而非貼文摘要所稱的 30 秒上限。小檔案若幾秒就能讀完,分流反而更慢。
另一個限制是命令列 payload。README 列出的 SHUNT_MAX_PAYLOAD_BYTES 預設在 macOS 為 400,000 bytes、Linux 為 120,000 bytes,因為輸入會經過 argv。超過時 plugin 會主動失敗,避免撞上 E2BIG;大型工作必須拆批。
哪些工作不能交出去
編輯不能只靠摘要。 Worker 回傳的行號未必可靠。Claude 要實際改動時,仍需用 offset 或 limit 精準讀取相關區段。bulk-reader 省的是理解整體的 context,不是把原始碼永遠藏起來。
除錯和架構必須留給強模型。 原作者的測試裡,小模型抓到表面模式,卻漏掉一個細微的 thread-safety bug;Claude 看到正確上下文後很快找出問題。shunt 因此明確排除 debugging、architectural decisions 與 safety-critical code。
code-writer 沒有硬性攔截。 README 明列只有 bulk-reader 由 hook 強制執行;code-writer 仍仰賴 Claude 依 skill 判斷。這表示輸出型工作的節省量,會受到模型是否真的照路由走影響。
先測「決策品質」,再看 token
只看帳單,很容易把最佳化做錯。便宜 worker 若漏掉安全條件,省下的 token 可能換來更貴的事故。導入前至少記錄四個量:frontier input tokens、frontier output tokens、端到端 latency,以及人工返工率。
可以先從純讀取開始。挑一個超過門檻的大檔案,準備五個你已經知道答案的問題,比較 Claude 直接讀取與 bulk-reader 摘要後回答的正確率。只有當答案品質持平,token 才是有效的節省。
再測 code-write。選擇可由既有 pattern 預測的測試檔或設定檔,要求 worker 直接寫入新的目標檔,讓測試套件與 lint 當驗收。若需要 Claude 大量修補,這個任務就不適合委派。
Spotify 這次公開的價值超過一個 90% 數字。它提出一條可以檢查的路由邊界:I/O 與樣板交給便宜 worker,判斷與風險留給前沿模型。當 agent 成本開始被 context 搬運主導,模型選擇不再是一個全域開關,而是每一次工具呼叫之前的決策。
常見問題
這是否代表 Gemini 2.5 Flash 比 Claude 更適合寫程式?
不是。範例只把 Gemini 2.5 Flash 用在大量讀取摘要與可預測的樣板輸出。除錯、架構、安全關鍵程式碼和需要精準編輯的工作仍留給 Claude。
90% 能直接套到我的 repository 嗎?
不能。90% 是一個 16.2 萬行 Java monorepo、三組 bulk-read 情境的平均值。你的檔案大小、問題類型、worker 品質與門檻不同,結果也會不同。
為什麼不用 prompt caching 就好?
Prompt caching 降低重複讀取相同 context 的價格,shunt 則讓大量原始內容一開始就不進入前沿模型 context。兩者可以同時使用,處理的是不同成本來源。
可以只把規則寫在 CLAUDE.md 嗎?
可以,但不具強制性。shunt 用 PreToolUse hook 擋下符合條件的完整讀取,路由行為比較一致,也不必在每個 repository 複製規則。
權威引用
- Spotify Engineering — Portal by Spotify cut my Claude Code token usage by 90%
- GitHub — spotify/portal-ai-plugins shunt
- Spotify for Backstage — Portal
- Spotify for Backstage — AiKA Modes
Author Insight
這套設計最值得抄的不是 Gemini 2.5 Flash,也不是 350 行。真正可移植的是三層責任:hook 執行成本政策,script 封裝傳輸,skill 描述判斷。模型和門檻都能換,責任邊界不必跟著散掉。
我會先只開 bulk-reader,跑一週影子量測,再決定是否讓 code-writer 直接落盤。Token 下降很好看;少返工、沒漏掉風險,才算真的省錢。