Jev 是 TypeSafe AI 的 System One 模型,將文字或結構化資料轉成程式可用的判斷。 它於 2026 年 9 月 15 日開放 early access,每百萬輸入 token 定價 USD 0.042。開發者可以用它分派工單、評分或判斷條件,再由程式決定後續動作。
這項設計省下自由文字轉回程式資料的步驟。型別正確與內容正確仍是兩回事。分類結果即使完全符合格式,也可能把帳務問題分到物流團隊。測試 Jev 時,要看它能否在可接受的錯誤率下,處理足夠多的日常判斷。
Jev 如何運作:先定義答案,再提出問題
TypeSafe AI 創辦人 Diogo Almeida 在發表文章中介紹了專為決策設計的模型架構。它搭配平行取樣,以及 Reinforcement Learning for Calibrated Decisions(RLCD,校準決策強化學習)。這是廠商對訓練方向的說明,不能據此認定模型已通過所有產業的可靠度驗證。
呼叫 Jev 時,state 放待判斷的材料,questions 放問題與允許的答案。客服案例可以把訊息、訂單狀態與適用政策放進同一份資料。每道題目都針對這份資料獨立作答,再由程式組合結果。需要先取得另一題答案才能判斷的問題,仍要安排後續呼叫。
官方目前提供三種問題型別。它們的差別會直接影響程式怎麼讀取回應。
| 型別 | 適合的問題 | 回傳內容 | 實作注意事項 |
|---|---|---|---|
| Choice | 工單應交給哪個團隊 | 選項、各選項機率、confidence |
最多 255 個選項;集合不完整時加入其他類別 |
| Score | 問題落在哪個嚴重程度 | 分數、各等級機率、confidence |
以具體情境定義等級,避免只寫輕微或嚴重 |
| Noul | 訊息是否提出退款要求 | noul,介於 0 與 1 |
表示肯定答案的機率,沒有獨立 confidence 欄位 |
Choice 的選項名稱與描述會影響判斷。Score 則適合描述連續程度,例如介面瑕疵、功能失效但能繞過、工作完全中斷。分數可以位於等級之間,但不能把它當成精密量測值,拿來還原金額或計算天數。
信心分數要用自己的資料驗證
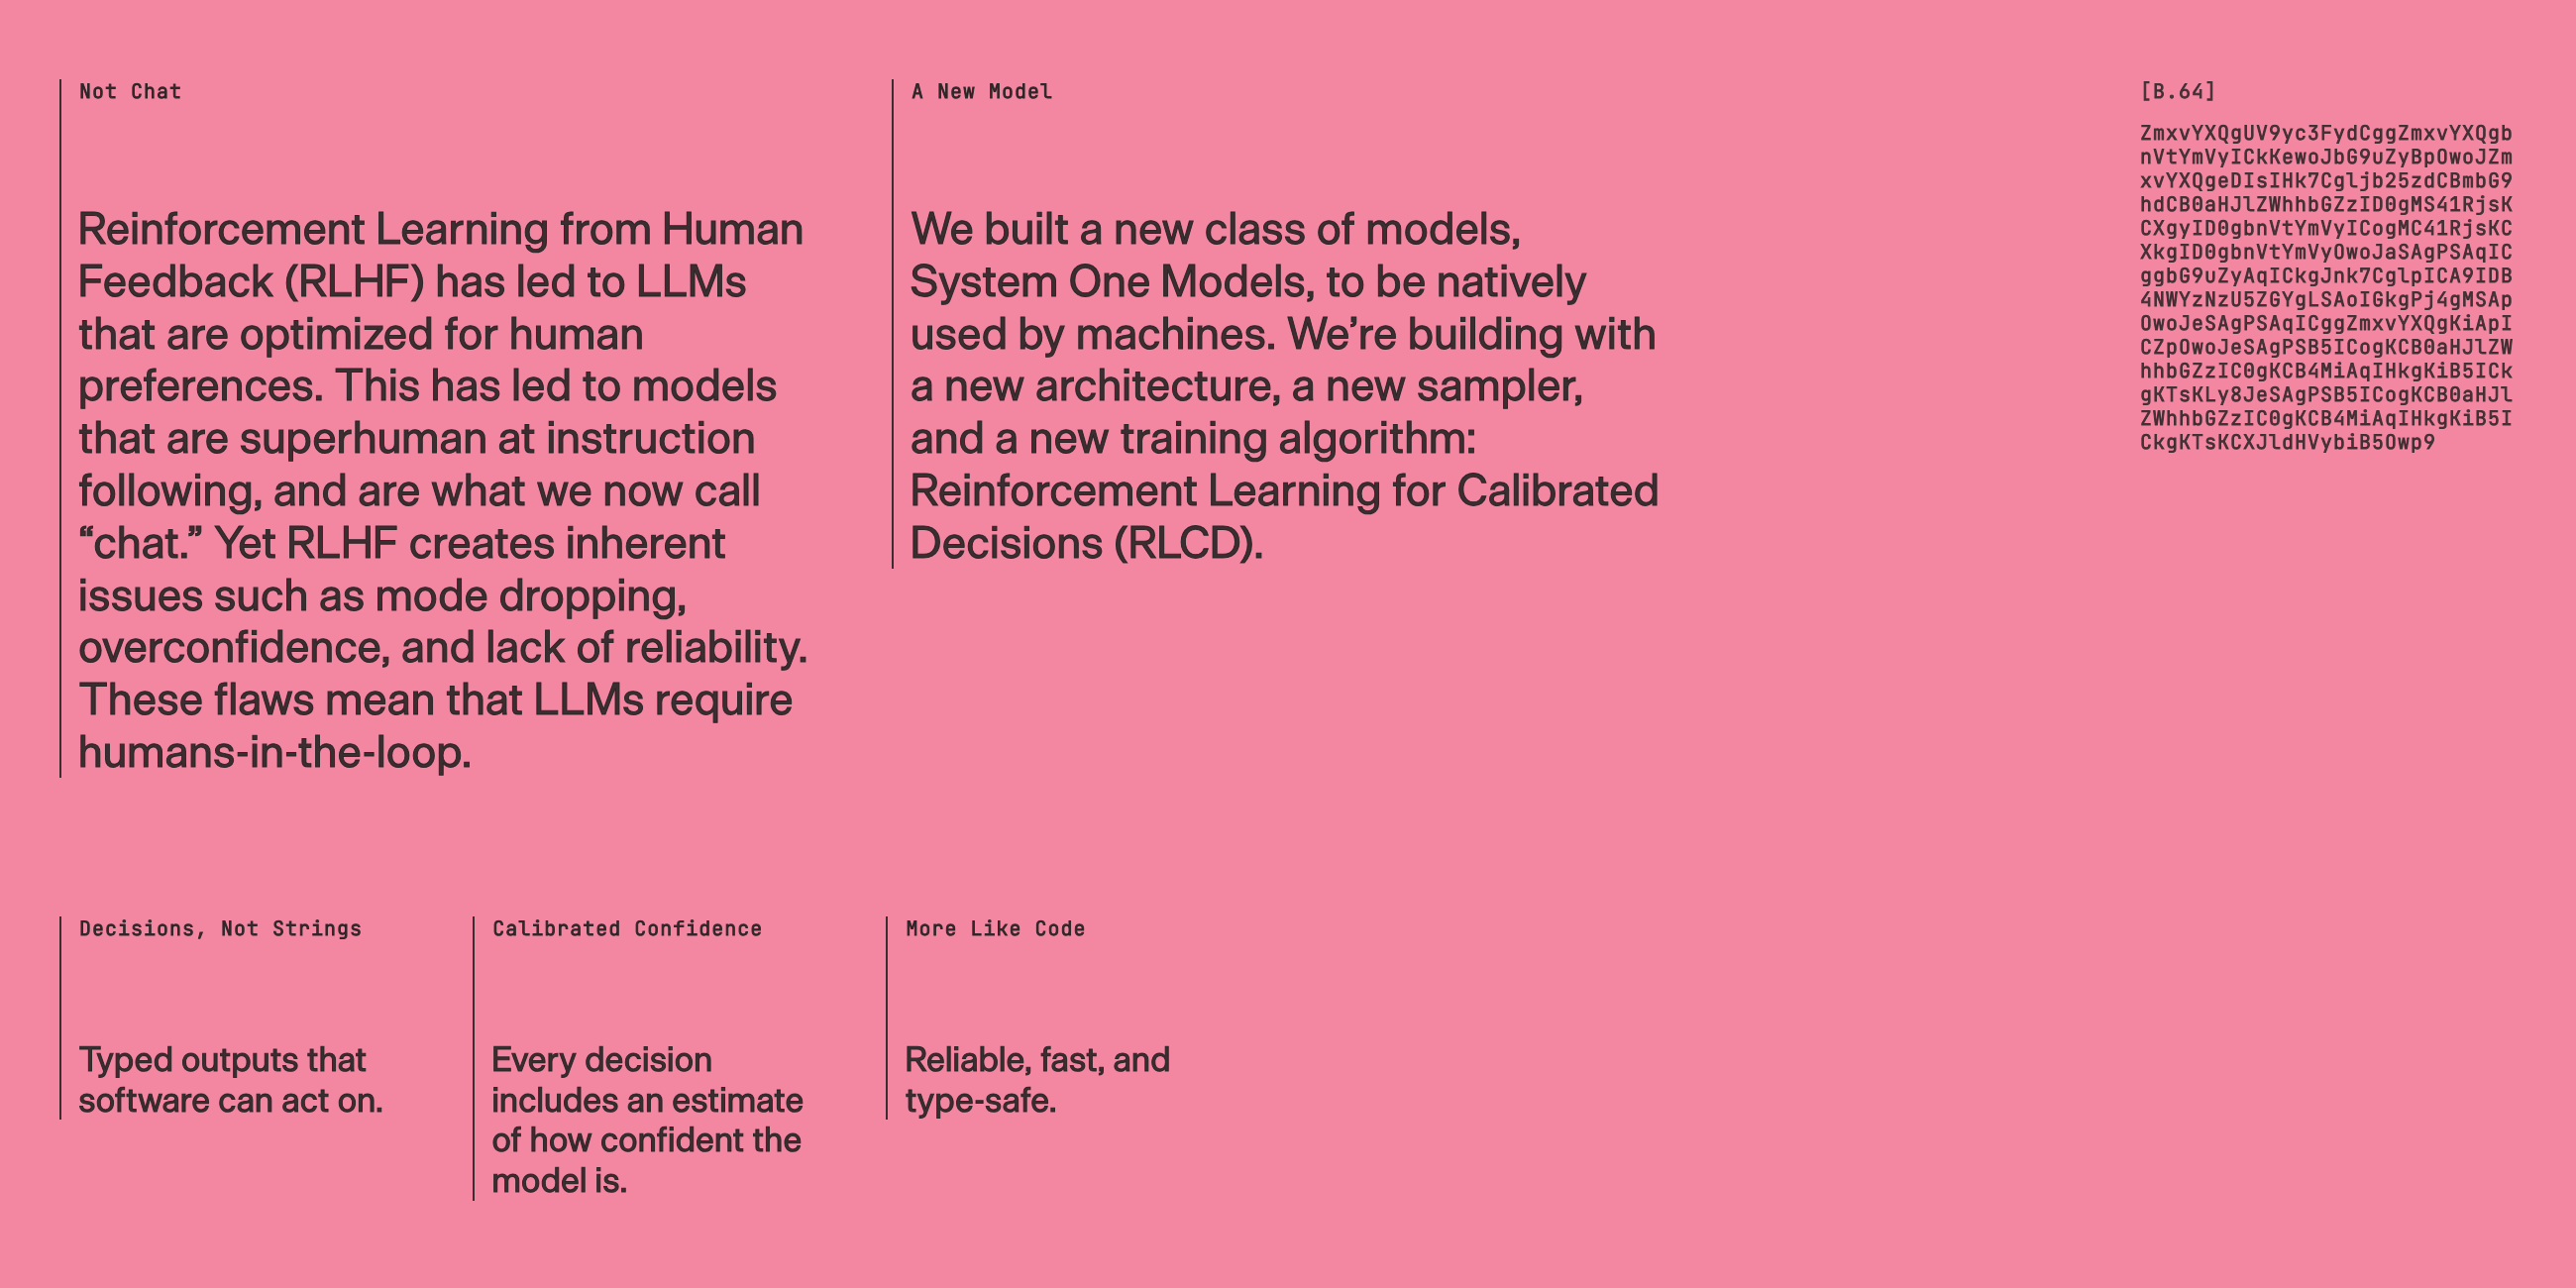
官方文件說明,Choice 與 Score 的 confidence 由機率分布計算而來。機率集中在單一結果時,信心通常較高;分散時則較低。因此,confidence = 0.9 不能直接讀成這筆判斷有 90% 機率正確。
Noul 也需要小心解讀。接近 0 表示偏向否定,接近 1 表示偏向肯定,中間值可以送人工檢查。偏向否定並不等於模型沒把握。若用同一條低分規則處理所有型別,正常的否定答案可能全部遭到退回。
我們建議先用人工標記過的工單,畫出門檻與錯誤率的關係。分派到錯誤資料夾,通常還能補救;直接核准退款則有不同後果。兩種動作不必共用門檻。試跑時先記錄建議結果,讓原流程繼續執行,確認差異後才逐步開放自動處理。
適合放在哪些工作流程
客服分流是容易開始的試點。讓 Choice 判斷負責團隊,另用 Noul 判斷是否要求退款。程式可以保留兩種答案,避免一張同時涉及換貨與重複扣款的工單,只剩單一分類。
內容審核可以把辱罵、疑似詐騙、個資洩漏分別設成問題,再用政策決定標記或送審。Jev 的輸出本身不應直接成為永久停權指令。招募則可試做履歷資料整理,例如辨識候選人明列的技能;自動淘汰與最終錄用需要另外評估偏差和責任,不能靠信心分數代替審查。
在檢索增強生成流程裡,Jev 可協助判斷候選段落是否相關,再把保留下來的資料交給生成模型。若工作仍需要撰寫回覆、長篇推理或產生程式碼,就保留原本的生成模型。兩者可以串接,不必把整個系統一次換掉。
價格很低,benchmark 仍有比較條件
2026 年 9 月 21 日查閱的模型文件列出 jev-1.13.0。當天 jev-latest 與 jev-preview 都指向這個版本。輸入每百萬 token 收費 USD 0.042,輸出不另計費。假設每筆請求合計 1,000 個輸入 token,100 萬筆的模型輸入費用為 USD 42;這是算式示例,未包含重試、其他模型、資料處理與人工覆核。
| 已公布項目 | 數值或限制 | 評估時要保留的條件 |
|---|---|---|
| 單次請求總長度 | 64k token | 包含 state 與所有問題 |
| state 加最長單題 | 32k token | 另一項獨立限制 |
| 官方端到端延遲範圍 | 70–500 ms | 不是台灣連線或尖峰流量的服務保證 |
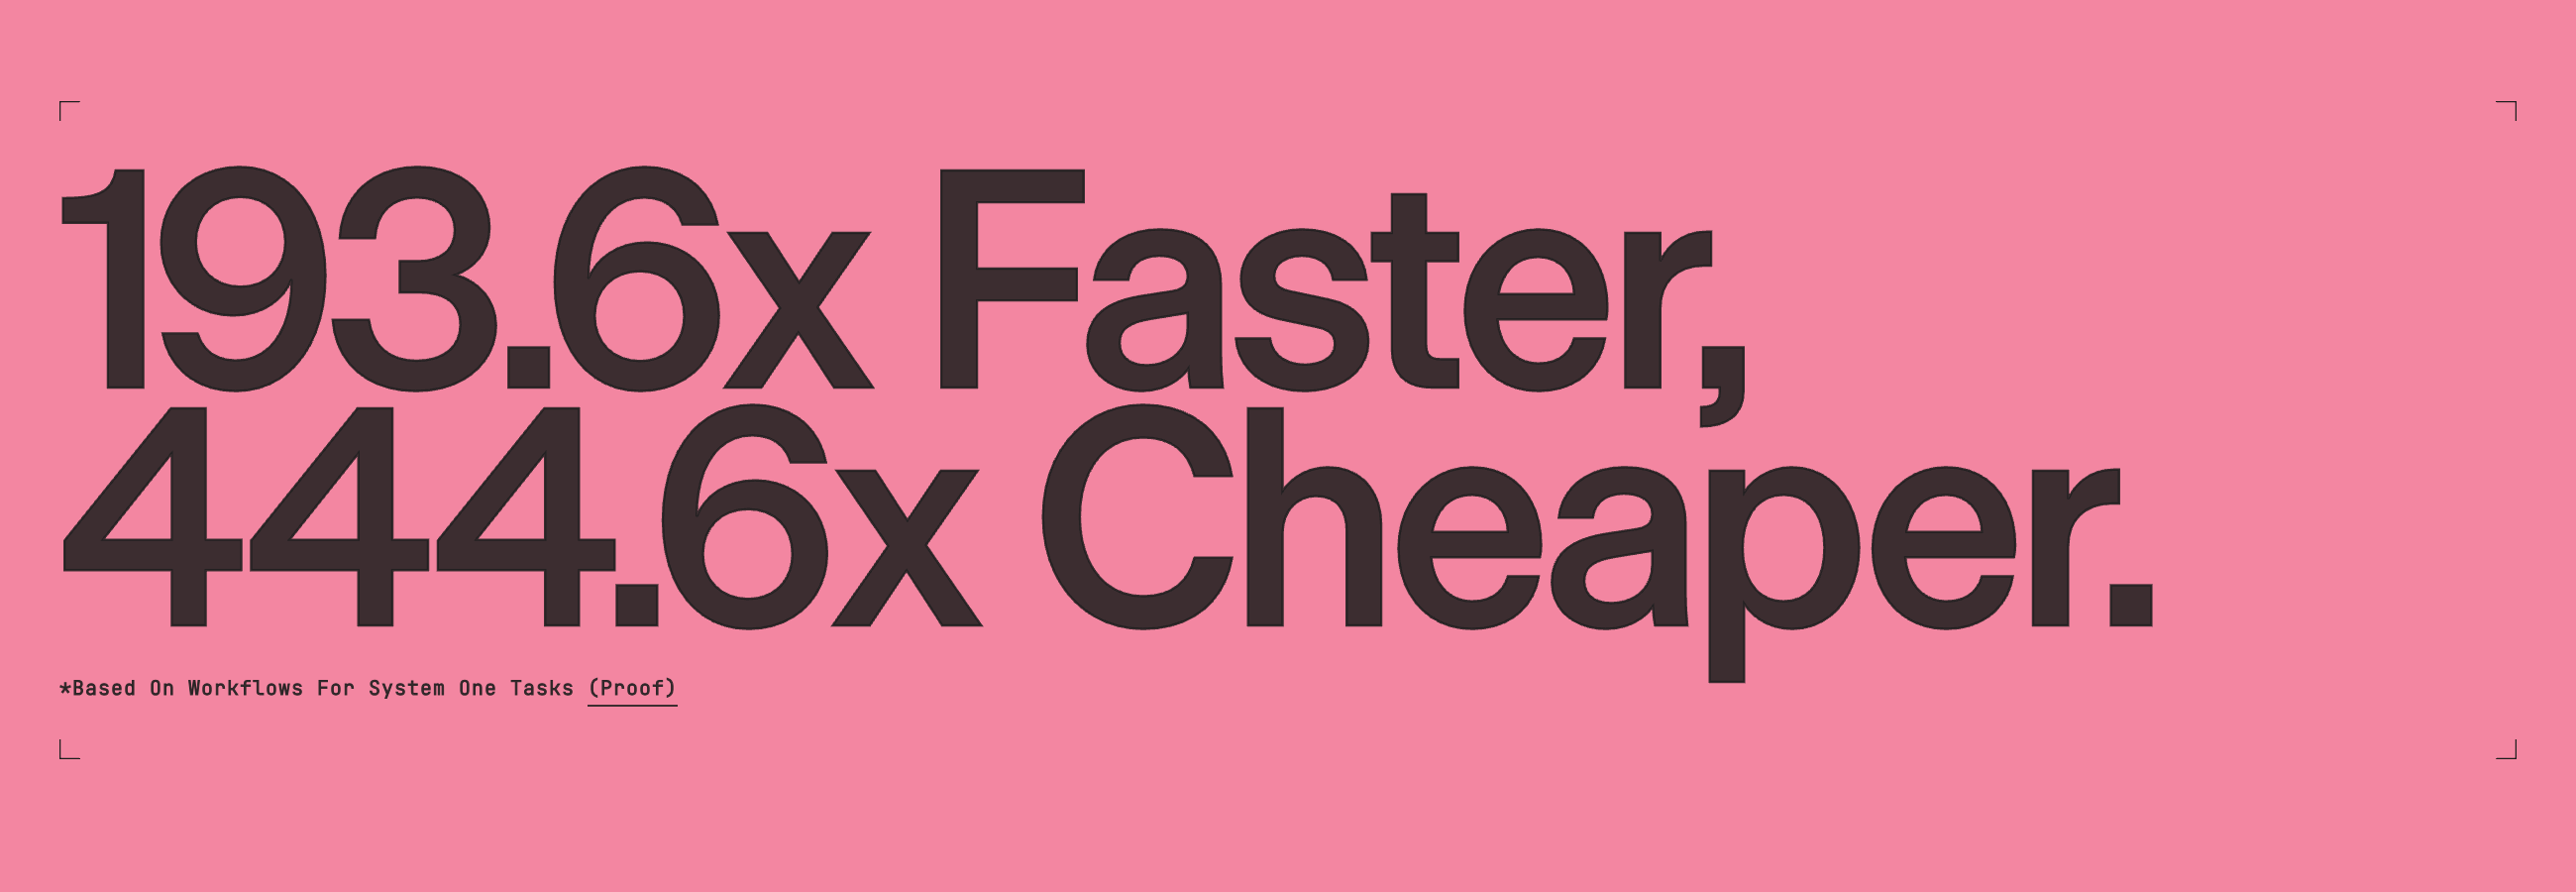
| 廠商工作流程測試 | 快 193.6 倍、便宜 444.6 倍 | 特定流程與比較設定,不是所有任務的普遍結果 |
官方發表文交代,測試以大型模型預測的平均值當參考,並非全部採用人工真值標籤。測試流程由內部能力團隊建立,廠商也承認可能存在偏差。比較對手使用相容的結構化決策包裝,包含機率輸出,其成本與一般簡短分類不同。
多問幾題可以攤提重複輸入、減少往返,但新增問題仍消耗輸入 token。輸出免費不代表所有呼叫免費。公開資料也不足以推算 TypeSafe AI 的毛利,或保證這套價格長期不變。
官方列出的限制,比零幻覺口號更有用
Jev 1.13 的官方限制頁於 2026 年 9 月 17 日更新,列出九類已知弱點。它可能過度照字面解讀,也不擅長精確數學與日期比較。無關上下文、間接推理、惡意內容或彼此矛盾的指示,都可能拉低結果品質。
算術與期限判斷應留在程式裡。例如先由模型辨識文字中提到的月份,再由日期函式檢查格式與先後。不要把整份訂單紀錄丟進模型,要求它自行算出退款期限。
不同問題各自作答,結果也可能彼此衝突。程式必須檢查不變條件,不能假設每個回傳值相加就會形成一致政策。網路逾時、API 失敗與重試仍要處理;型別保證不會消除這些運作問題。
目前模型只接受文字資料,沒有原生圖片、音訊或影片輸入。官方也說英語是主要訓練語言,其他語言表現不均。台灣團隊應另外測試繁中工單、夾雜英文的產品名稱與口語省略句。
Jev 的實作入口
先從官方 Playground 測試 state 與問題,再用同一批案例比較人工標籤。取得帳號存取權與 API key 後,可以呼叫 POST https://api.typesafe.ai/v1/systemone。Python SDK 需要 Python 3.10 以上,金鑰由環境變數 TYPESAFE_API_KEY 讀取。
pip install typesafe-sdk
以下是依官方 SDK 介面撰寫的最小分流範例,沒有實際呼叫付費 API。0.8 只是示範門檻,正式使用前需要自己的測試資料。程式只印出建議去向,不會修改工單。
from typesafe_sdk import Choice, TypeSafeClient

with TypeSafeClient(model="jev-1.13.0") as client:
    result = client.system_one(
        state="同一張訂單被扣款兩次,請協助確認。",
        questions={
            "team": Choice(
                instructions="應由哪個團隊先檢查這則訊息?",
                criteria={
                    "billing": "扣款、發票或付款問題",
                    "shipping": "配送進度或包裹遺失",
                    "other": "不符合前述分類,或資料不足",
                },
            )
        },
    )
answer = result.answers["team"]
destination = answer.choice if answer.confidence >= 0.8 else "manual_review"
print(destination)
固定版本有助重現測試結果。升級模型時,重新檢查門檻與錯誤案例。官方另有 JavaScript SDK 與供程式代理使用的 TypeSafe skill;導入之前仍應檢查依賴與安裝範圍。
社群正在爭論什麼
9 月 16 日至 19 日的公開討論呈現兩種反應。試用回報對低延遲前置篩選抱有期待:先判斷是否需要進一步處理,再讓生成模型接手。質疑則集中在模型是否只是分類器的重新包裝,以及型別保證被宣傳成零錯誤的風險。
這些是早期、自選樣本的經驗,沒有一致的資料集或評測環境,不能代表社群共識。對準備導入的團隊,最值得追問的是:相同資料與錯誤容忍度下,比既有分類器或結構化輸出模型省下多少工作。名稱是否全新,無法替這個問題作答。
常見問題
Jev 能取代 ChatGPT 嗎?
Jev 不產生自由文字,因此不能直接接手聊天、文章或程式碼生成。它適合在這些流程前後執行範圍明確的判斷。
Jev 的零幻覺代表什麼?
官方主張輸出符合預先指定的型別與選項。這不保證選中的答案正確,也不保證輸入資料真實。
可以直接在本機執行 Jev 嗎?
這次查核的官方入口是託管 API 與 Playground,沒有確認可下載執行的官方權重。不要把 SDK 安裝誤認為下載模型。
Jev 可以做繁體中文客服嗎?
可以送入繁中內容,但官方說英語表現最好。必須用自身工單測試,再決定哪些案例可以自動處理。
參考來源
- TypeSafe AI:Jev 發表與評測方法
- 官方模型規格與價格
- Choice 定義與回應欄位
- Score 等級與機率
- Noul 是非機率
- Confidence 與機率的差別
- Jev 1.13 已知限制
- 官方快速開始
Author Insight
我會先挑人工能快速確認的分流工作試跑。測試要保存錯分案例,也要記下送人工的比例。若只是把錯誤藏進覆核佇列,低 token 單價未必降低整體成本。
術語表
| 術語 | 本文用法 |
|---|---|
| System One | TypeSafe AI 對快速、結構化決策模型的命名 |
| state | 提供給模型判斷的資料與背景 |
| confidence | Choice/Score 機率分布衍生的信心統計量 |
| 校準 | 預測機率與實際結果頻率的吻合程度 |