Claude Code 在 Anthropic 的日常工作裡,已經能接手完整的開發任務。2025 年的團隊訪談記錄了一個例子:Vim 模式約 70% 的最終實作,來自 Claude 的自主工作。碰到核心業務邏輯,工程師仍會逐步參與、即時審查。
這份《How Anthropic teams use Claude Code》收錄 10 個團隊的使用經驗。除了工程師,設計師也直接調整介面,財務人員用文字描述資料流程,法務同仁則做出內部工具原型。官方同題案例文章於 2025 年 7 月 24 日發布;以下案例保留當時背景,操作建議另參照現行文件。
我最在意的是團隊如何決定交付範圍。審查者要能看出修改是否符合需求,並取得測試結果。Claude Code 是 Anthropic 的代理式程式開發工具,可以讀取專案、修改檔案並執行工具;這也使任務邊界成為開發流程的一部分。Anthropic 官方案例
七成 Vim 程式,不能換算成七成工程師工時
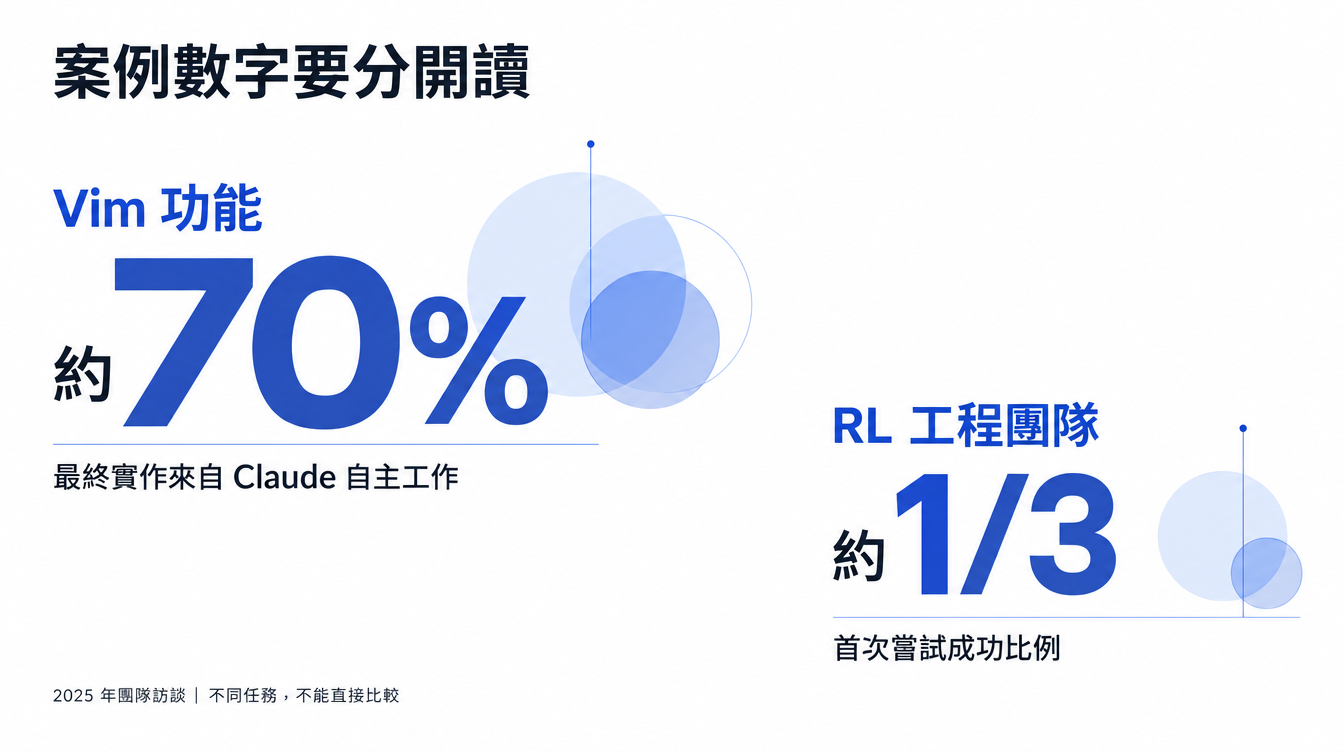
Claude Code 團隊把 Vim 按鍵操作功能交給自己的產品實作。這項功能當時並非優先工作,適合拿來試驗較自主的工作方式。經過幾輪修改,Claude 的自主工作約占最終實作 70%。
同一個團隊處理核心功能時,做法就不同。他們提供明確實作指示,持續查看架構與程式品質。原型可以讓 Claude 先跑一段,牽涉核心業務邏輯時,人會更靠近每一次變更。PDF,第 5–6 頁
70% 衡量的是這個功能的實作來源。訪談沒有提供對照組,也沒有交代人工審查、重寫與維護的完整工時。拿它去推算整個團隊可以省下多少人力,會超出資料能回答的範圍。
強化學習(reinforcement learning,RL)工程團隊給了另一種經驗。他們讓 Claude 處理中小型變更,第一次嘗試就成功的比例約為三分之一。其他情況需要繼續引導或人工介入。他們頻繁建立 Git 檢查點,方便撤回不合適的實作。PDF,第 19–20 頁
這兩個數字不能直接比較,任務與分母都不同。評估 Claude Code 時,要把失敗嘗試與後續修正一起算進去。
10 個團隊,接手的是不同一段工作
PDF 最實用的部分,是把工作場景拆得很具體。下表保留各團隊的代表案例;所有時間與比例都是訪談中的自述,並非統一測試結果。
| 團隊 | 代表用法 | 案例細節與頁碼 |
|---|---|---|
| 資料基礎架構 | 排查 Kubernetes 叢集、整理資料流程 | 從儀表板截圖找出 Pod IP 位址耗盡問題;第 3–4 頁 |
| 產品開發 | 原型與周邊功能實作 | Vim 模式約 70% 最終實作來自自主工作;第 5–6 頁 |
| 資安工程 | 追蹤程式控制流程、檢視 Terraform 變更 | 原本約 10–15 分鐘的程式掃讀,縮至約 5 分鐘;第 7–8 頁 |
| 推論工程 | 理解機器學習概念、補單元測試 | 部分查找工作由約 1 小時縮至 10–20 分鐘;第 9–10 頁 |
| 資料科學與視覺化 | 製作可重用的分析儀表板 | 在不熟悉語言的情況下,完成約 5,000 行 TypeScript 應用程式;第 11–12 頁 |
| API 知識團隊 | 找出相關檔案、調查陌生程式 | 在動手修錯前,先取得程式庫導覽;第 13–14 頁 |
| 成長行銷 | 依既有廣告資料產生文案變體 | 文案製作由約 2 小時縮至 15 分鐘;第 15–16 頁 |
| 產品設計 | 直接修改介面、製作互動原型 | 一次跨專案文案調整,以兩通各 30 分鐘的通話完成協調與更新;第 17–18 頁 |
| RL 工程 | 中小型功能、測試與除錯 | 首次嘗試成功約三分之一,配合檢查點與撤回;第 19–20 頁 |
| 法務 | 內部聯絡與審查進度工具原型 | 先在 Claude.ai 整理構想,再逐步實作;第 21–22 頁 |
來源:Anthropic 團隊訪談 PDF。表中縮短的是指定工作片段,不能當成整個部門的生產力增幅。
資料科學團隊的案例尤其值得看。他們原本會寫用完就擱置的 Jupyter 筆記本,後來改做能反覆使用的 React 儀表板。多了工具之後,後續模型評估也能沿用。價值包含減少重做,以及讓分析結果更容易再次查看。
程式行數本身無法證明品質。這個案例的啟發是:先找出一件經常重做、輸入與輸出又清楚的工作,再判斷是否值得做成持續維護的工具。
先讓 Claude 找到證據,再讓它改程式
API 知識團隊把 Claude Code 當作任務起點,先問哪些檔案值得讀。資安工程師則提供錯誤堆疊與文件,請它沿著控制流程追查。兩者都在減少理解陌生程式的時間。
例如,使用者反映匯出報表有時少資料,第一個任務可以只要求找出資料流。讀者可把下面的範本改成自己的檔案與症狀;這是依案例整理的實作建議,並非 Anthropic 內部原始提示。
任務:調查報表匯出偶爾少資料的原因,先不要修改檔案。

已知現象:<貼上重現步驟、預期結果與實際結果>
調查範圍:<相關目錄或入口檔案>

請找出資料讀取、篩選與匯出的呼叫順序。
每個判斷都附上檔案路徑與對應程式位置。
分開列出已確認事實與仍需驗證的假設。
提出能區分這些假設的最小測試,並說明預期結果。
如果缺少必要資料,明確指出缺的是什麼。
看過調查結果,再決定變更範圍。這能避免 Claude 把一個篩選條件的錯誤,擴大成整套報表系統的重構。它提出的路徑也方便工程師核對,減少只憑說明相信答案的機會。
對不熟悉的模組,先交出可驗證的理解,通常比立即交出大量程式更容易審查。熟悉的小錯誤則可以直接修,無須每次都重新規劃。
把完成條件寫進任務
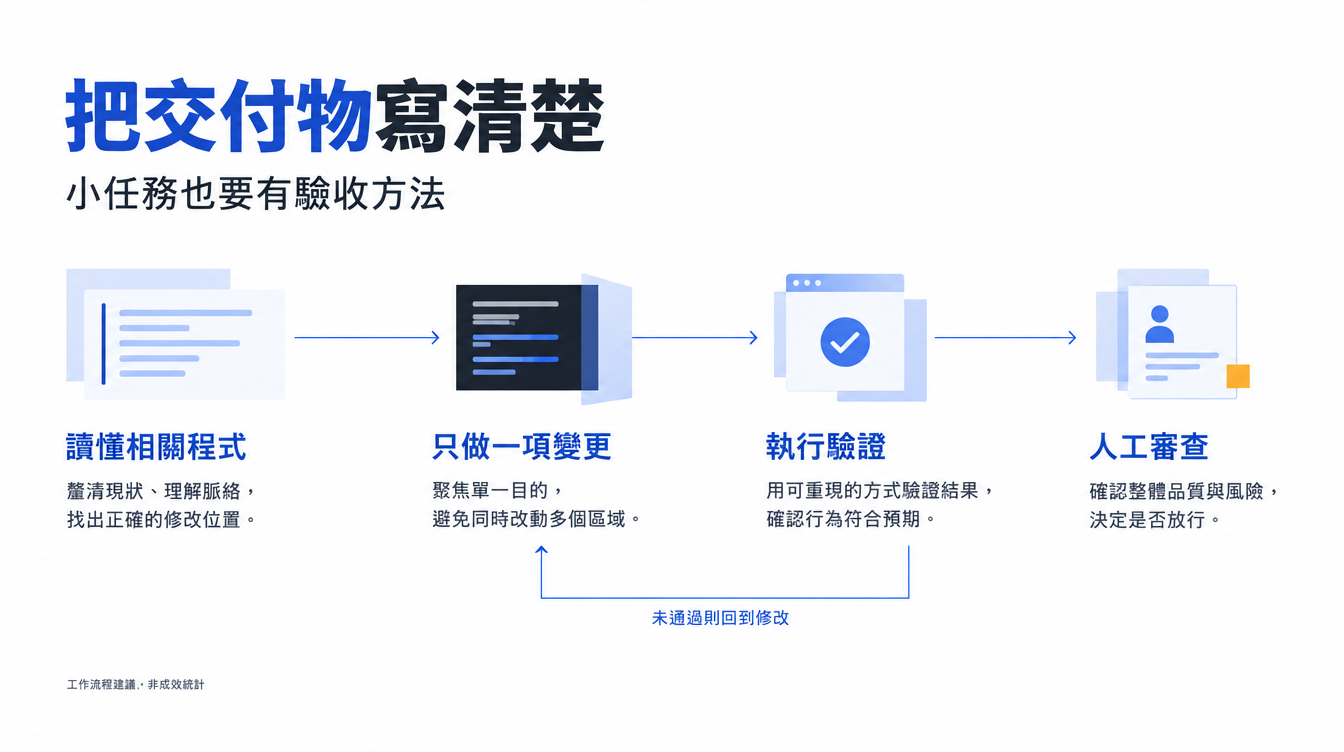
產品開發團隊建議讓 Claude 自己跑建置、測試與程式碼檢查。資安工程團隊也把測試驅動開發納入工作:先討論行為與測試,再持續修正實作。測試驅動開發(test-driven development,TDD)會先定義預期行為,讓測試約束後續修改。PDF,第 6–7 頁
接續報表案例,實作任務可以這樣寫:
依照已確認的原因,只修正 <指定行為>。
沿用專案既有寫法,不增加無關功能。

驗收條件:
1. 用既有測試工具重現原本錯誤,記錄修正前的失敗結果。
2. 修改後,同一個測試應通過;補上 <具體邊界情況>。
3. 執行受影響範圍的測試與必要檢查。
4. 交付修改摘要、實際執行的命令、結果與尚未驗證的部分。

不要刪除或弱化測試來取得通過結果。
若發現必須改動原定範圍以外的模組,先說明原因。
完成後交由人工審查,再決定是否合併。
測試通過仍需要閱讀差異。AI 可能只驗證自己假定的行為,也可能漏掉權限與資料邊界。工程師要確認測試對應需求,並查看必要的執行結果。現行官方最佳實務同樣強調,交付可執行的驗證方法,能讓 Claude 在工作中取得回饋。Claude Code 最佳實務
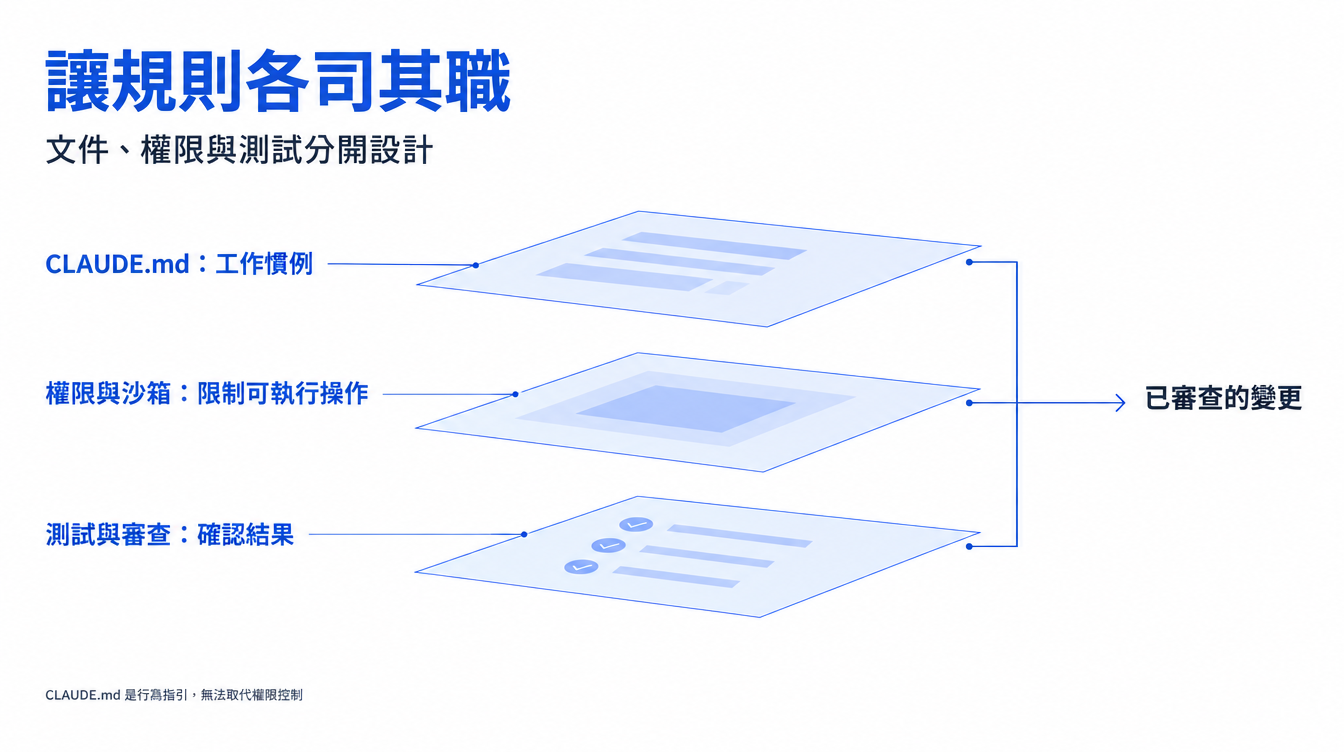
CLAUDE.md 記錄慣例,權限設定限制操作
資料基礎架構團隊把流程與工具寫進專案文件,並在任務結束後更新。RL 工程團隊則補上經常出錯的操作規則,例如使用正確測試工具,避免不必要地切換目錄。
現行文件使用的檔名是 CLAUDE.md。適合放進去的內容,包括專案特有的測試命令、容易誤解的業務規則,以及常見操作陷阱。詳細背景可以分檔,避免每次工作都塞入大量用不到的資訊。
但文件裡的一句禁止事項,無法取代實際權限限制。官方文件明確區分兩者:CLAUDE.md 提供行為指引,受管理設定才負責強制限制。需要隔離檔案與網路時,也要配置對應的沙箱控制。Claude Code 記憶與指令文件
PDF 提到資料團隊偏好透過 MCP 存取敏感資料。模型情境協定(Model Context Protocol,MCP)可讓 AI 工具連接外部資料與功能。若自行建立伺服器,就有機會限制工具可用操作並保留紀錄;這些保障要在系統中實作,不能光靠協定名稱。
官方安全文件也指出,Anthropic 並未替所有 MCP 伺服器做安全稽核。導入時應確認工具來源、實際權限與資料去向。Git 可以撤回程式變更,卻無法撤回已經送出的郵件或外部系統異動。Claude Code 安全文件
非工程師能做工具,維護責任也要有人接
設計團隊用截圖產生互動原型,也直接修改視覺與狀態管理。成長行銷團隊把廣告文案處理拆成不同任務,並記錄實驗假設與結果。法務團隊則先用對話整理需求,再逐步完成工具原型。
這些案例的共通條件是,使用者熟悉問題本身。他們知道哪種介面難用、哪些文案格式不合要求,也知道內部同仁找不到哪位負責人。Claude Code 補上部分實作能力,讓需求能更早變成可操作的東西。
工具一旦開始處理真實工作,仍要指定維護者。誰負責資料欄位變更、套件更新與使用者回報,應在試用時就決定。否則原型製作省下的時間,可能轉成工程團隊後來接手的成本。
評估時可記錄每件經審查可採用的變更,總共花了多少時間。需求整理、AI 執行、人工審查與返工都要計入。再加上服務費用與維護負擔,才比較接近實際成本。這是本文建議的衡量方式,PDF 沒有提供完整投資報酬率。
也要避免只靠體感判斷。研究機構 METR 在 2025 年 7 月 10 日公布一項試驗:16 位熟悉各自開源專案的開發者,處理 246 件真實任務時,允許使用當時 AI 工具的組別反而多花 19% 時間。主要工具是 Cursor 搭配 Claude 3.5/3.7 Sonnet;這項研究不能直接當成 Claude Code 的成效測試。METR 原始研究
METR 在 2026 年 2 月 24 日的後續說明中,認為新工具可能帶來更多加速。但參與者與任務的選擇偏差,使新估計不夠可靠。舊結果與新估計,都不適合直接推廣到所有開發工作。METR 後續說明
自己的團隊可以先挑選可比較的小任務,記錄交付時間與返工原因。若程式產出增加,審查排隊也變長,就先處理那個瓶頸。
常見問題
Claude Code 適合先拿來處理什麼工作?
可從陌生程式庫導覽、補測試或範圍清楚的小錯誤開始。先確認結果能被驗證,再逐步擴大任務。核心業務邏輯與高影響操作,需要更密集的人工審查。
非工程師可以使用 Claude Code 嗎?
Anthropic 的設計、行銷與法務案例顯示可行。初期仍需要工程師協助設定專案與權限,並說明如何預覽、驗收與撤回變更。開始做原型時,就應安排後續維護責任。
CLAUDE.md 寫得越長,結果就越好嗎?
應保留專案特有、會影響操作的規則,定期移除過時內容。細節可以分檔,在需要時讀取。CLAUDE.md 是工作指引,不能當成安全隔離措施。
能用 PDF 裡的數字估算導入效益嗎?
可以用來挑選試驗場景,但不宜直接預估省下的總工時。各案例衡量不同,且屬團隊自述。請把審查、失敗嘗試與維護成本納入自己的紀錄。
參考來源
- Anthropic:How Anthropic teams use Claude Code,使用者提供的 PDF
- Anthropic:2025 年 7 月 24 日官方案例文章
- Claude Code:Best practices
- Claude Code:How Claude remembers your project
- Claude Code:Security
- METR:2025 年初 AI 工具對資深開源開發者生產力的試驗
- METR:2026 年 2 月的實驗設計更新
Author Insight
Tenten 編輯觀點:我會先檢查一個團隊能不能清楚描述驗收條件。若需求只有「做得更好」,Claude Code 很容易產出一份難以判斷的修改。把預期行為、測試證據與人工審查者指定清楚後,才有依據決定哪些工作值得繼續交給它。
術語表
| 術語 | 本文用法 |
|---|---|
| Claude Code | 能讀取專案、修改程式並使用工具的代理式開發環境 |
| CLAUDE.md | Claude Code 讀取的專案慣例與工作指引檔案 |
| MCP | 讓 AI 工具連接外部資料與功能的模型情境協定 |
| RL | 強化學習,文中指負責相關訓練工程的團隊 |
| TDD | 測試驅動開發,以預期行為與測試約束實作 |
| Git 檢查點 | 已保存的版本,可作為比較或撤回程式變更的依據 |