GPT-6 Astra 可以協助產生研究假說、撰寫回測程式與整理結果,卻不會替一套策略證明獲利能力。 把 Grok Bot、Kimi K3 Swarm、Astra 與 Telegram 串在一起,確實能縮短研究週期;要把它變成可長期運作的交易系統,仍得補上時點正確的資料、交易成本、樣本外驗證、風險閘門與獨立執行服務。
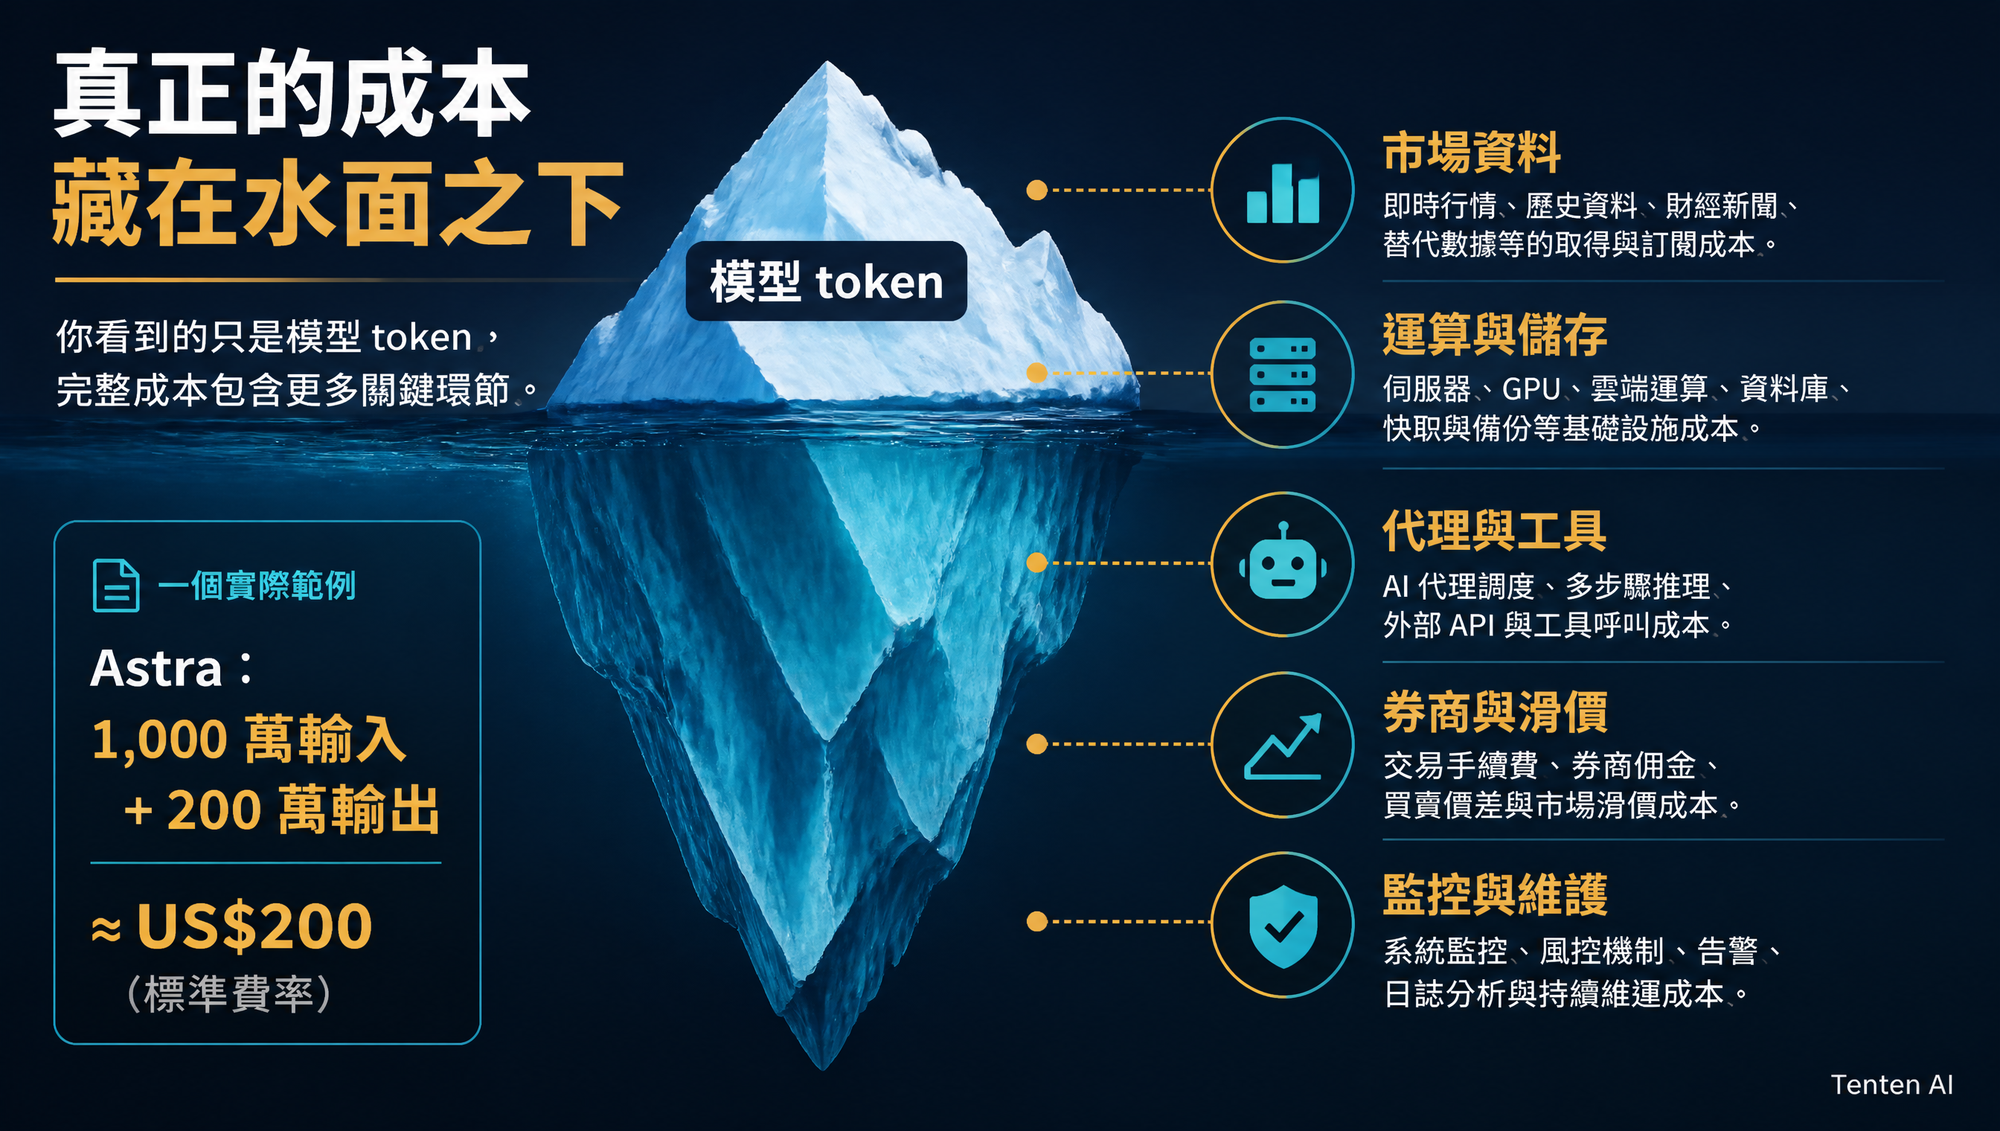
一篇在 X 流傳的教學把這套組合稱為「一人避險基金」,並估算每月只要 300 至 500 美元。這個價格不能直接成立。OpenAI 對 GPT-6 Astra 的標準 API 費率是每 100 萬輸入 token 10 美元、輸出 50 美元;Fast 模式加倍,超過 272,000 個輸入 token 的請求另有長上下文加價。市場資料、券商費用、運算、儲存、Kimi 呼叫與重試成本都不在這張模型價目表裡。
這套構想真正值得採用的地方,是把量化研究拆成多個有明確輸入與輸出的工作。最需要修正的地方,則是把研究代理、共享電腦和交易執行混在同一個信任區域。
四類策略可以研究,原文的獲利捷徑不能照抄
| 來源構想 | 有根據的研究問題 | 上線前必須補的驗證 |
|---|---|---|
| 共整合統計套利 | Engle–Granger 方法可檢查非平穩序列是否存在穩定線性組合 | 滾動估計、結構轉折、借券、滑價、擁擠與樣本外績效 |
| 波動率曲面 | Heston 模型提供隨機波動率定價框架 | 模型誤差、避險成本、跳躍與賣方策略的尾端損失 |
| Fama–French 殘差 | 因子模型可分解已知風險曝險與未解釋報酬 | 殘差不等於可交易 alpha;需控制延遲、換手率與資料探勘 |
| 內部人交易訊號 | SEC Form 4 是可結構化的公開揭露資料 | 申報通常可到交易後第二個工作日;群聚分數與 5.3% alpha 的說法沒有可靠來源 |
原文把隱含波動率高於實現波動率描述成套利機會,這會低估選擇權賣方的凸性風險。價差可能是風險溢酬,也可能反映跳躍、流動性與模型沒有捕捉到的尾端情境。沒有動態避險、壓力測試與部位上限,它不是無風險交易。
內部人訊號也需要更精確。Cohen、Malloy 與 Pomorski 的研究區分例行與機會型交易,發現機會型交易組合具有較高異常報酬;它沒有支持任意設定「群聚分數大於 3」便得到 5.3% alpha。公開 Form 4 屬於有申報期限的監管資料,不能視為即時內線消息。
一百萬 token 不是時序資料庫
GPT-6 Astra 的 1,050,000 token 上下文很大,適合放入研究規格、程式、少量診斷樣本與先前實驗摘要。逐筆成交、完整委託簿和數百個市場的長期歷史資料,仍應留在 Parquet、DuckDB、ClickHouse 或專用時序資料庫。
模型應該收到已定義版本的特徵、資料切片與統計摘要,並透過受限制的工具要求更多資料。把原始行情全部塞進 Prompt,成本高、難以重現,也無法保證模型在長上下文裡正確計算每一個數值。
Kimi 官方文件確認 K3 Swarm 最多可以協調 300 個子代理。這是工作分解上限,不是「同時監控 300 個市場就一定省錢」的保證。每個子代理都會產生 token、工具、資料與協調成本。持續掃描應由確定性的篩選器完成,只有出現候選事件時才啟動模型研究。
成本要用工作量估算,不能用訂閱名稱推算
假設每月使用 1,000 萬輸入 token 和 200 萬輸出 token,Astra 標準費率的模型成本約為 200 美元:輸入 100 美元,輸出 100 美元。Fast 模式約為 400 美元,長上下文請求還可能更高。這只是一個示例,不包含快取、Kimi、Grok Bot、行情授權、券商、雲端、監控與工程維護。
ChatGPT Pro 的使用額度也不等於一般 API 點數。OpenAI 將 ChatGPT 方案與 API 平台計費分開管理。要做預算,應從每個工作流的 token、工具執行時間、資料授權與失敗重試量開始測,而不是把月費方案當成完整基礎設施成本。
安全版本的系統邊界
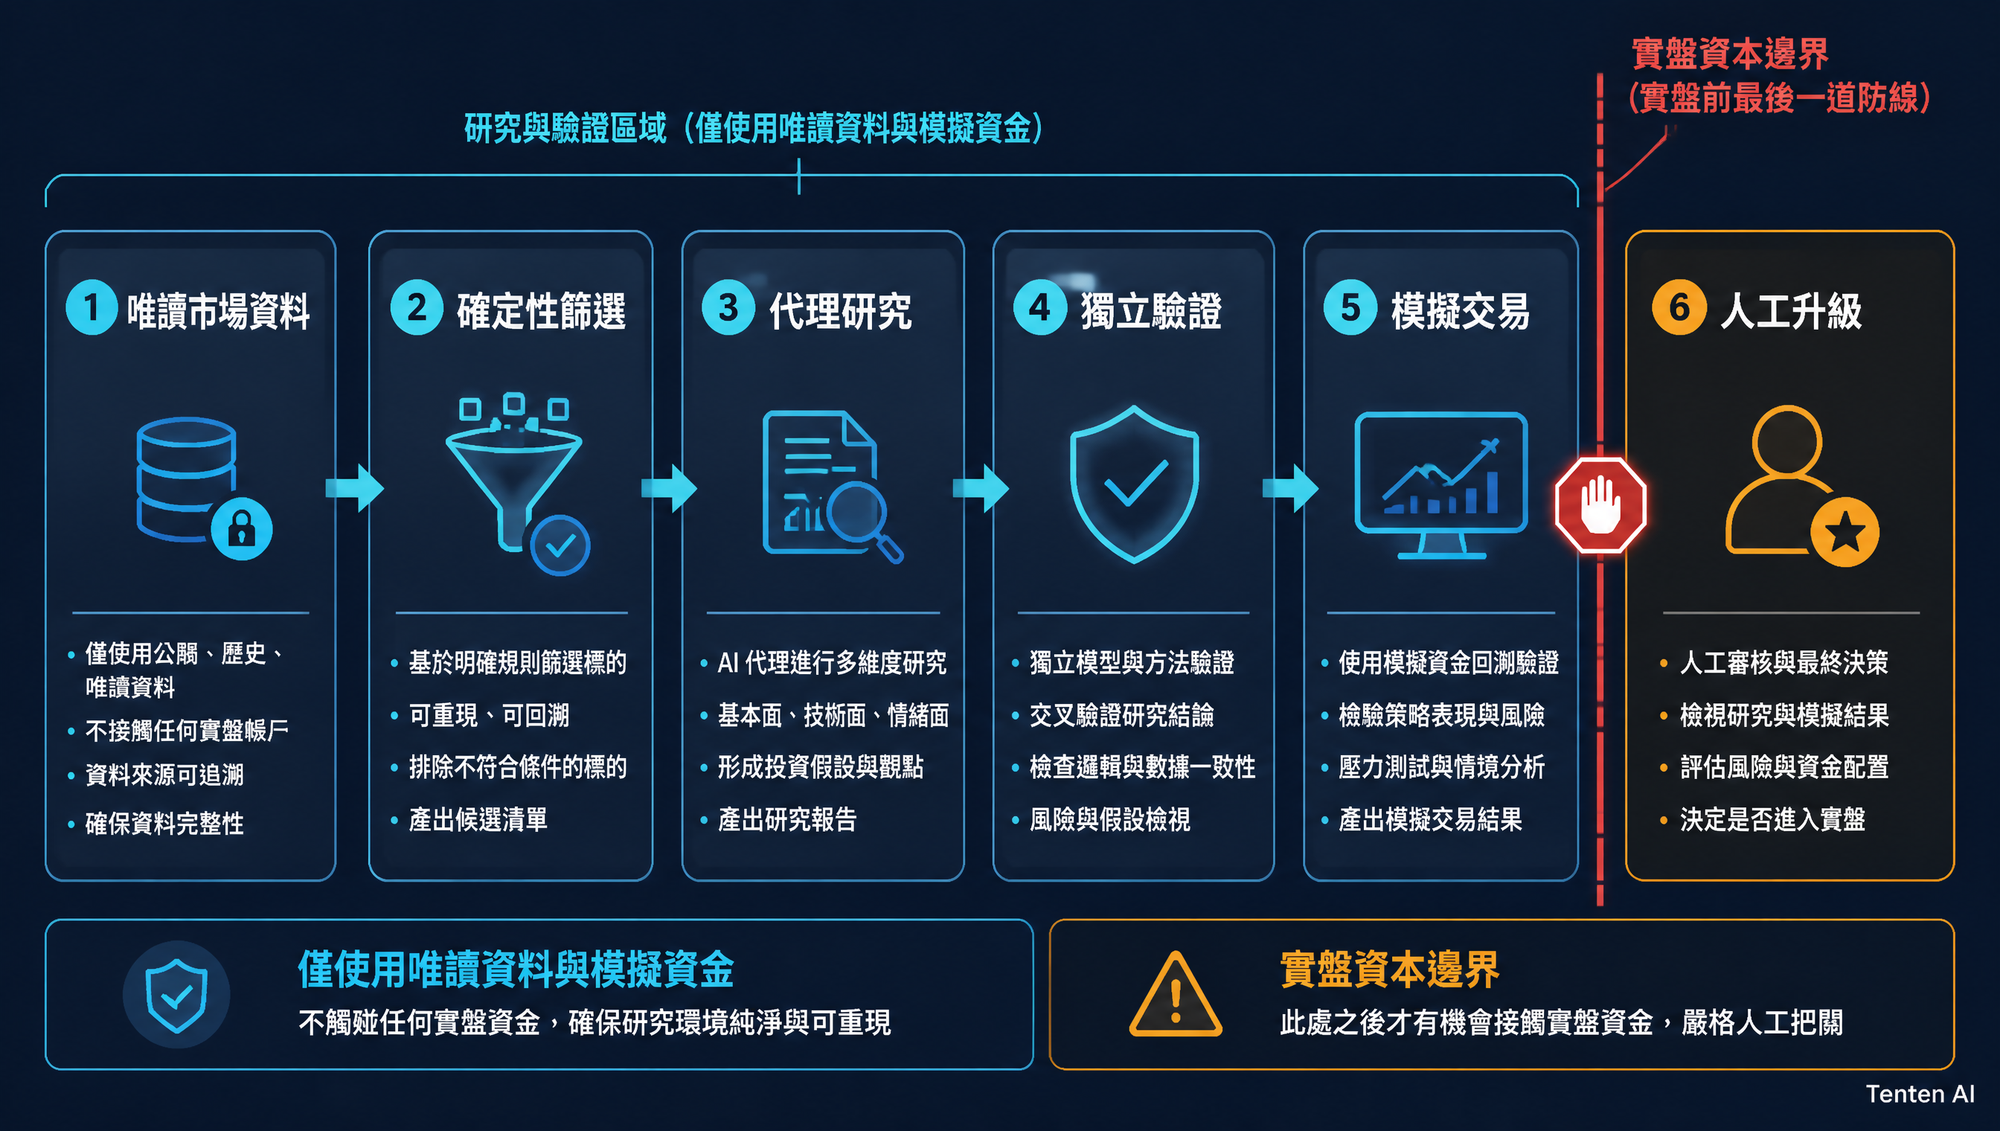
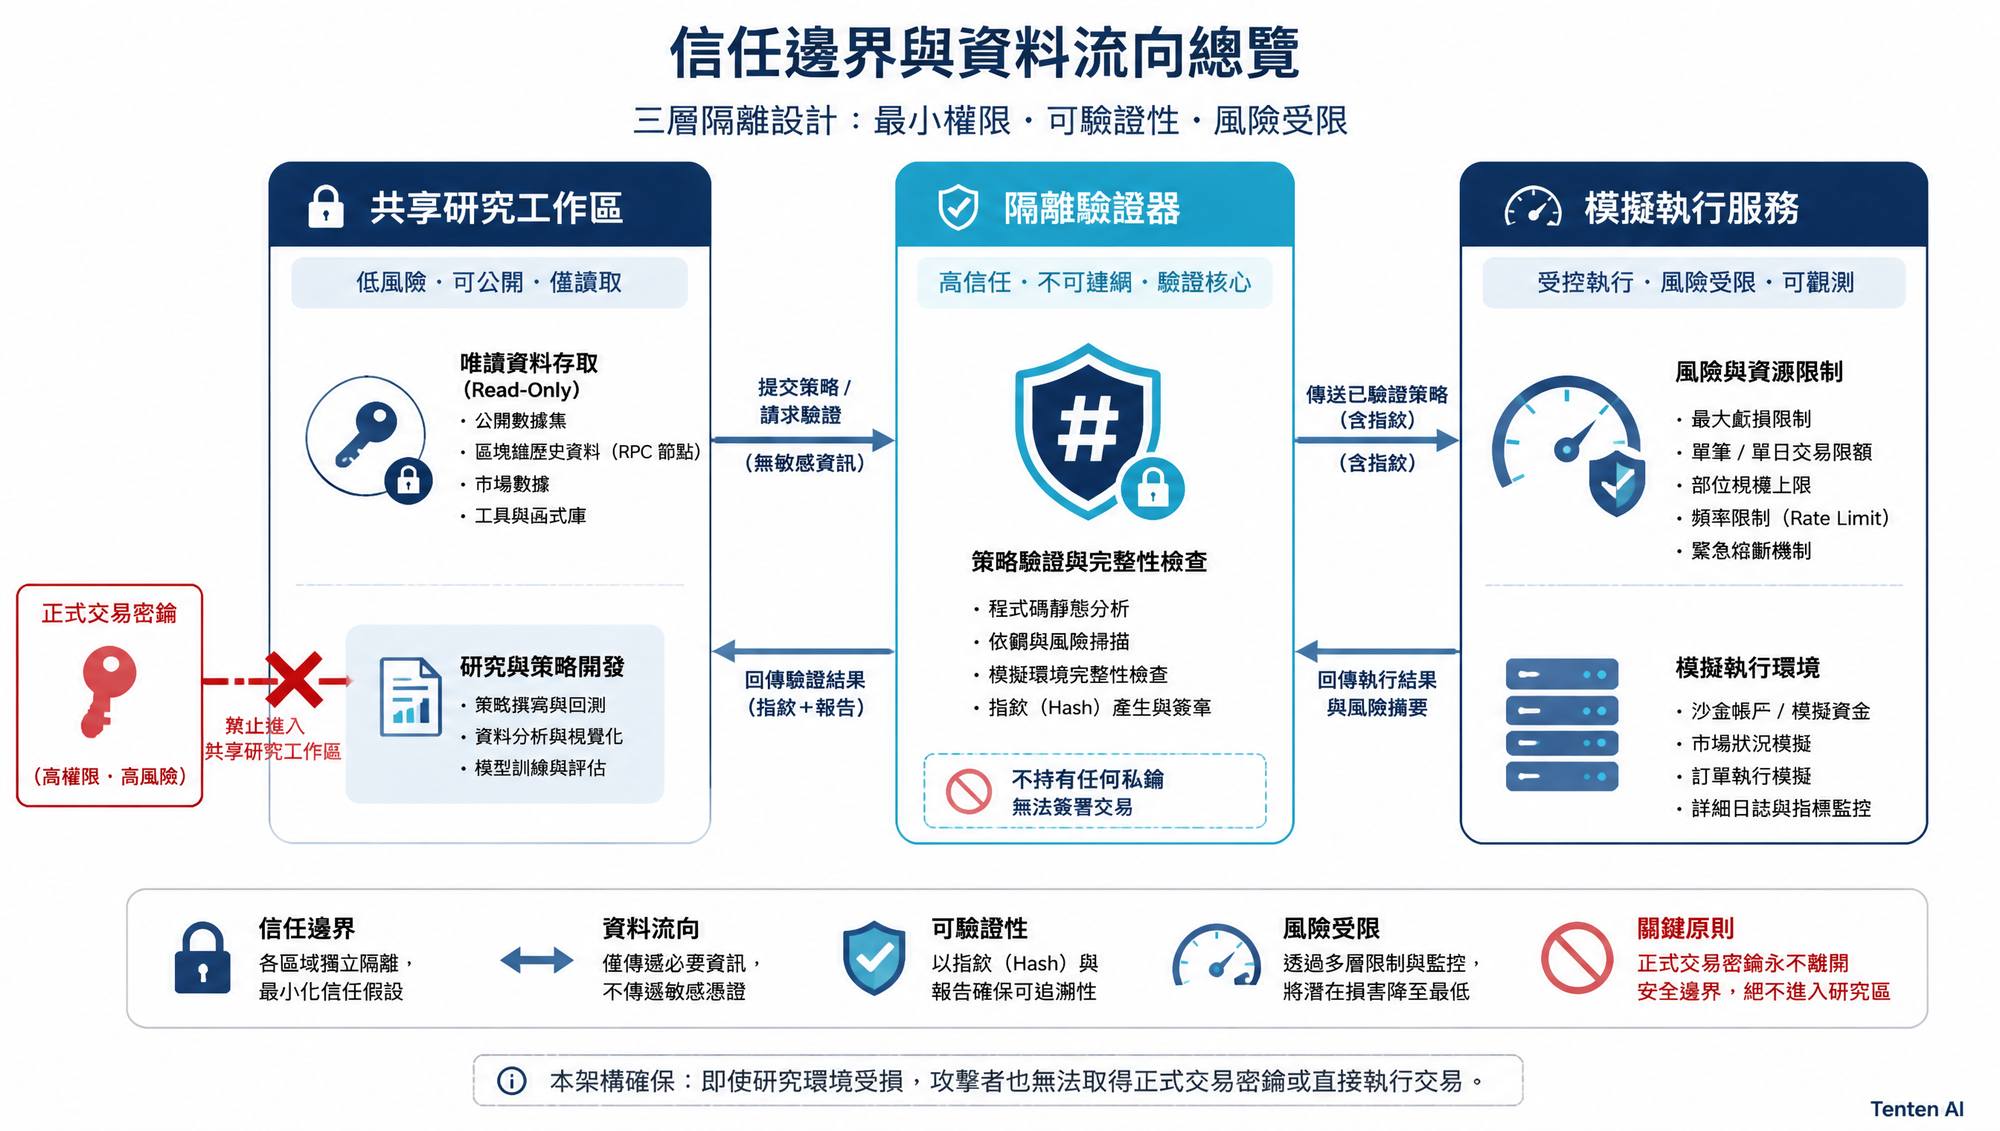
Grok Bot 的官方文件指出,多個 Bot 共用同一台持續運作的雲端電腦與其中的憑證。這種設計方便協作,卻不構成 Bot 之間的資安隔離。研究工作區只能放唯讀市場資料憑證;可提款、可轉帳或可送正式訂單的密鑰不應進入共享電腦。
較穩健的架構有七層:
- 資料收集器以唯讀方式取得行情、公司行動與公開申報。
- 特徵管線產生有版本、可回溯的資料集。
- 確定性篩選器找出值得研究的候選事件。
- Kimi K3 Swarm 或其他代理負責有界線的資料整理與研究分工。
- Astra 在隔離環境中提出假說和程式,不持有正式交易權限。
- 獨立驗證器重跑程式,檢查資料洩漏、交易成本、樣本外表現與多重測試。
- 風險閘門只把通過標準的結果送到模擬券商;Telegram 僅通知人員。
正式交易應是另一個部署與授權流程。FINRA 對演算法交易強調測試、導入後檢查與合規;SEC 的市場准入規則也要求預先設定信用與資本門檻,阻止錯誤或重複訂單。模型產生的 JSON 不能直接越過這些控制。
八步建立可稽核的模擬研究系統
第一步:切開研究、驗證與執行目錄
quant-research/
├── data/              # 版本化的唯讀市場資料
├── features/          # 可重現的特徵資料集
├── hypotheses/        # 結構化研究假說
├── strategies/        # 未受信任的候選程式
├── validation/        # 獨立驗證報告
├── paper_orders/      # 模擬訂單與成交紀錄
└── audit/             # Prompt、程式雜湊與核准紀錄
研究代理可以寫入 hypotheses/ 與 strategies/。只有驗證服務能寫入 validation/;模擬執行器只讀取已核准的不可變版本。
第二步:分開帳號與密鑰
OPENAI_API_KEY=<OPENAI_PLATFORM_API_KEY>
KIMI_API_KEY=<KIMI_PLATFORM_API_KEY>
MARKET_DATA_TOKEN=<READ_ONLY_MARKET_DATA_TOKEN>
PAPER_BROKER_KEY=<PAPER_TRADING_ONLY_KEY>
TELEGRAM_BOT_TOKEN=<TELEGRAM_NOTIFICATION_TOKEN>
TELEGRAM_CHAT_ID=<AUTHORIZED_CHAT_ID>
不要把正式券商密鑰放在這個檔案。生產環境應使用秘密管理服務,限制每個服務只能讀取自己的憑證,並保存存取稽核。
第三步:先做資料契約
每個資料集都要記錄來源、時間戳、時區、調整方式、存取時間與版本。回測只能看到當時已公開的資料;日後修訂的基本面、存活者名單與延遲發布資料都可能造成前視偏誤。
第四步:用規則篩選候選事件
先用 SQL 或 Python 找出價差、波動率、因子殘差或 Form 4 活動超過門檻的候選事件。模型只分析縮小後的集合,並把每個判斷連回資料版本。這能降低成本,也讓漏報與誤報可以量測。
第五步:要求 Astra 產生可否證的假說
你是量化研究代理,只能提出供模擬驗證的假說,不得下單或要求正式交易憑證。

輸入:
- 候選事件與資料版本
- 可用欄位、頻率和發布延遲
- 研究開始前寫定的風險與成本假設

每個假說輸出:
1. 經濟機制與可能失效原因
2. universe、signal、entry、exit、holding_period
3. point_in_time_requirements
4. transaction_cost_model
5. falsification_test
6. 至少一個負向控制
7. 結構化 JSON 規格與供審查的 Python 程式

禁止:捏造缺少的數值、把樣本內 Sharpe 當成通過、執行正式訂單。
第六步:讓另一個流程負責回測驗證
你是獨立驗證器。不要修改假說來改善結果,也不要執行候選程式中的網路或系統呼叫。

請在隔離容器中重跑測試並輸出:
1. 資料版本、程式雜湊和固定亂數種子
2. 樣本內、走動式樣本外與市場分段結果
3. 手續費、滑價、借券、延遲與容量假設
4. 前視偏誤、存活者偏誤、選擇偏誤檢查
5. 多重測試數量、PBO 或相應的資料探勘調整
6. 壓力測試、最大回撤和尾端損失
7. PASS、REJECT 或 NEEDS_DATA,並列出理由

單一 Sharpe > 1.5 或 t-stat > 2 不足以判定 PASS。
Bailey 等人的研究指出,投資回測中的一般保留樣本可能不可靠,尤其當研究者試過許多組合再挑最佳結果時。驗證流程至少要記錄實驗總數,並以走動式測試、組合式對稱交叉驗證或其他適合時序資料的方法估計過度擬合風險。
第七步:先跑模擬交易
模擬期要驗證訊號延遲、訂單狀態、部分成交、重複事件、斷線重送與市場關閉。風險閘門應有單筆、單日、商品、策略與總曝險上限,也要能在資料過期、價格異常或稽核紀錄缺失時拒絕訂單。
第八步:Telegram 只送通知
import os
import requests

BOT_TOKEN = os.environ["TELEGRAM_BOT_TOKEN"]
CHAT_ID = os.environ["TELEGRAM_CHAT_ID"]

def send_research_alert(report: dict) -> None:
    message = (
        f"研究狀態:{report['status']}\n"
        f"假說:{report['hypothesis_id']}\n"
        f"資料版本:{report['dataset_version']}\n"
        f"樣本外 Sharpe:{report['oos_sharpe']:.2f}\n"
        f"最大回撤:{report['max_drawdown']:.1%}\n"
        f"報告:{report['report_url']}"
    )
    response = requests.post(
        f"https://api.telegram.org/bot{BOT_TOKEN}/sendMessage",
        json={"chat_id": CHAT_ID, "text": message},
        timeout=10,
    )
    response.raise_for_status()
這段程式不計算部位,也不接受「買入」回覆。通知與交易控制分開後,即使 Telegram 帳號或研究代理出錯,也不能直接改變資金部位。
何時才值得考慮正式交易
團隊至少需要一段涵蓋不同市場狀態的模擬紀錄、可重現的樣本外結果、明確容量估計,以及能被獨立觸發的停止開關。任何升級都應綁定固定版本,而非讓代理在正式環境臨時重寫策略。
最難的工作不在於讓 Astra 產生更多想法,而是讓失敗的想法快速、便宜、可追溯地被淘汰。模型可以增加研究吞吐量;如果驗證預算沒有同步增加,它也會放大資料探勘與假陽性。
常見問題
GPT-6 Astra 能直接連接券商或交易所嗎?
模型支援工具呼叫與電腦操作能力,但連線、憑證、權限與訂單控制都由應用程式提供。它沒有內建券商帳戶,也不應繞過風險閘門。
每月 300 至 500 美元能跑完整系統嗎?
沒有固定答案。這個數字可能涵蓋某個低用量模型實驗,卻沒有涵蓋市場資料、Kimi、Grok Bot、運算、儲存、券商與維護。應以實際工作量量測。
1,050,000 token 能取代市場資料庫嗎?
不能。長上下文適合規格、程式與摘要;大規模時序資料需要可查詢、可版本化的資料系統。
Sharpe 大於 1.5 就代表策略有效嗎?
不代表。若研究過大量候選策略,最佳 Sharpe 很可能受選擇偏誤影響。還要檢查樣本外、成本、結構轉折與過度擬合機率。
K3 Swarm 的 300 個子代理適合一直掃描 300 個市場嗎?
官方上限代表可協調的子代理數,不代表固定成本或資料處理保證。持續監控應先用確定性程式,事件發生後再啟動代理。
權威來源
- OpenAI API — GPT-6 Astra 模型與定價
- OpenAI — GPT-6 Astra 發布公告
- OpenAI — GPT-6 Astra 安全說明
- Moonshot AI — Kimi K3
- Moonshot AI — K3 Swarm 官方說明
- xAI — Grok Bot 核准、資安與隱私
- FINRA — Algorithmic Trading
- SEC — Market Access Rule FAQ
- SEC — Form 4
- Bailey et al. — The Probability of Backtest Overfitting
Author Insight
一套研究代理的價值,應該看它淘汰了多少錯誤假說、留下多少可重現證據,而不是一天產生多少策略。Astra 讓程式與研究文字更快完成之後,獨立驗證、資料治理與權限設計會成為整套系統真正的產能上限。
術語表
- Alpha:扣除選定風險因子後仍無法解釋的報酬估計,不保證未來可交易。
- 共整合:多個非平穩序列之間存在穩定線性組合的統計關係。
- 前視偏誤:回測使用了在當時尚未公開的資訊。
- PBO:回測過度擬合機率,用來估計挑選出的最佳策略在樣本外失敗的風險。
- 風險閘門:在送出訂單前,以確定性規則檢查信用、資本、曝險與資料狀態的服務。