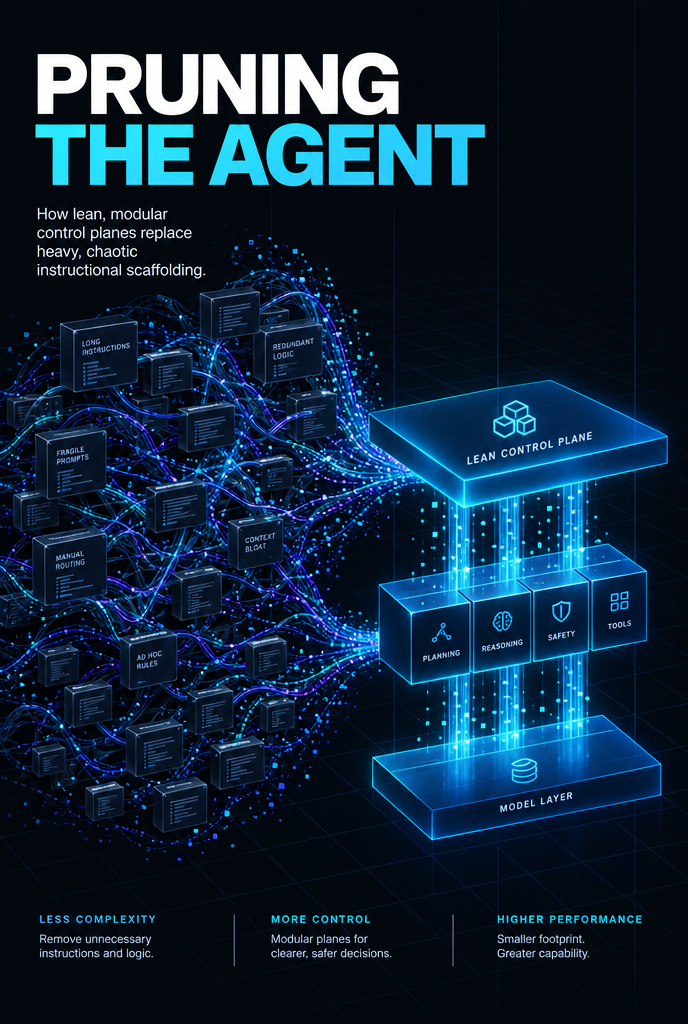
OpenAI 於 2026 年 9 月 11 日發佈 GPT-6 Astra 官方實踐指南,明確指出模型推理能力越強,越不該塞入龐雜規則。過度微觀管理的 AGENTS.md 與冗長 Skill 描述會佔用模型脈絡,甚至誘發相互矛盾的指令衝突。官方呼籲工程團隊大刀闊斧精簡配置:Skill 描述僅保留核心功能與觸發情境,改採依需求讀取的漸進式載入架構,並以明確的完成定義(Definition of Done)取代瑣碎步驟手冊。
在自主程式開發領域,許多團隊長期陷入一種工程盲區:每當模型執行偏差,工程師便習慣在系統提示詞、AGENTS.md 或自訂 Skill 內追加一道限制。長久下來,一個簡單的程式碼修改任務,往往掛載著數萬字的操作手冊。
前沿推理模型 GPT-6 Astra 問世後,OpenAI 開發者關係團隊在官方指南中直接點破:這種堆疊防禦性提示詞的作法,非但無法提升準確度,反而成為拖垮高階 Agent 自主性的技術負債。
脈絡膨脹與語意截斷:為什麼過長 Skill 描述反而讓 Agent 迷航
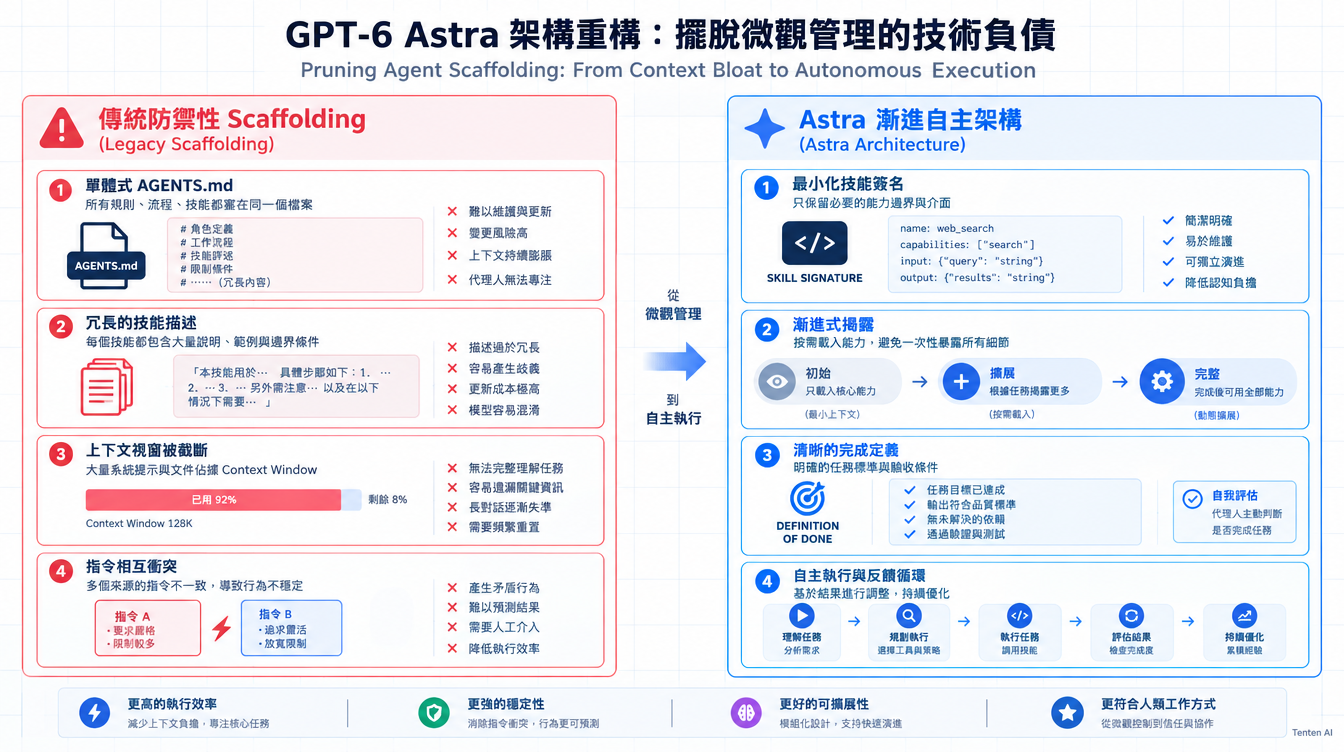
在現代 Agentic 架構中,系統為了讓模型隨時具備調度能力,會將所有註冊 Skill 的名稱與前言描述預先載入至系統脈絡中。一旦工作區內累積數十個 Skill,且每個 Skill 的 description 欄位都寫滿詳細操作步驟與防禦清單時,有限的初期脈絡窗口將迅速被非必要文字佔滿。
這會引發嚴重的工程副作用。當系統為了維持推理運算而強制截斷過長的描述時,關鍵的觸發條件往往最先被截除。失去邊界說明的 Agent,在面對複雜任務時,便極易發生誤判呼叫或幻覺路由。
OpenAI 官方對此給出的第一道重構原則相當俐落:Skill 的描述必須保持極簡。開發者在撰寫 Skill 定義時,僅需清楚回答兩件事:
- 這個工具具體解決什麼核心問題?
- 在何種確切觸發時機或檔案類型下,Agent 應當調用它?
其餘所有詳細的執行指令、邊界參數與參考文件,一律不應出現在常駐系統脈絡的描述區塊中。
指令衝突與微觀管理陷阱:當「主動完成」遇上「每步必問」的左右腦互搏
微觀管理的另一個致命代價,是多重 Skill 與多層配置檔案之間的規則踩踏。
在大型專案中,不同工程師常會各自撰寫專屬 Skill 或局部 AGENTS.md。某個 Skill 為了追求效率,要求 Agent「盡可能自主推演並一次完成全部修改」;另一個偏重安全審查的 Skill,卻嚴格規定「執行任何終端機指令或檔案寫入前,必須暫停並向工程師確認」。
當這些規則同時湧入 GPT-6 Astra 的脈絡時,模型會陷入嚴重的邏輯死鎖。高推理模型具備強大的多步思維鏈,但若提示詞內充斥相互矛盾的硬性禁令,模型便會在自相矛盾的權重拉扯中消耗大量推論權杖,甚至停滯不前。
這種微觀管理心態源於對早期模型的防禦習慣:試圖把模型當成只懂循序執行的指令碼,強行規範每一步動作。面對具備自我修正與規劃能力的新一代推理引擎,過度防禦的規則非但無法提供保護,反而成為自我矛盾的枷鎖。
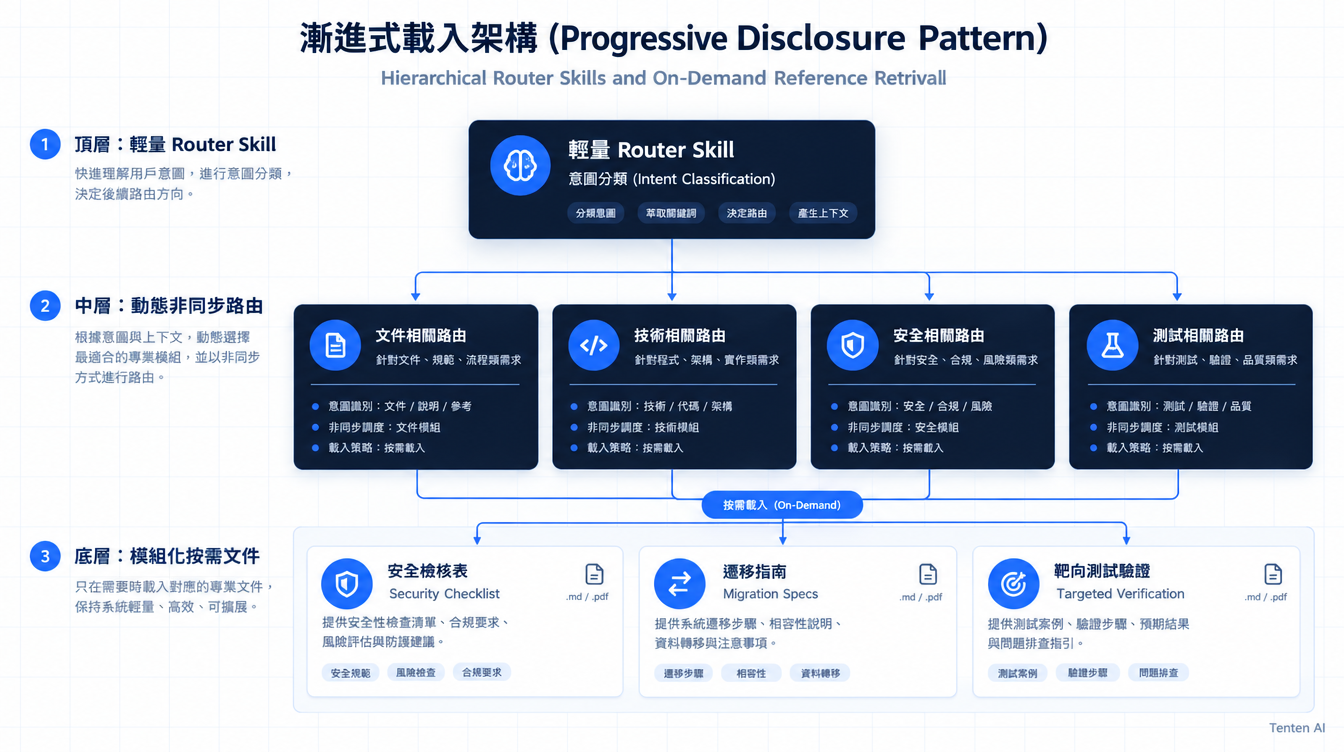
漸進式載入架構實務:以 Router Skill 與隨選資源重塑工作流
要徹底解決脈絡膨脹與指令衝突,OpenAI 推薦的核心架構模式是漸進式載入(Progressive Disclosure)。
其運作哲學非常直觀:不要為了修改一個錯別字,就強迫模型讀完一整個模組說明。
在漸進式架構中,系統採用階層式設計。常駐頂層的 Router Skill 僅擔任輕量級流量分發的角色,負責判斷當前使用者需求屬於哪種工程工作流。只有當任務被明確歸類後,Agent 才會依據情境去非同步讀取真正需要的操作指南、腳本或參考規格。
# 範例:輕量化 Router Skill 架構範本

name: database_migration_router
description: 處理 PostgreSQL 資料庫綱要異動與版本遷移。僅在偵測到 schema 修改或遷移指令時觸發。

instructions:
  - 識別目標資料庫環境與遷移目標。
  - 依需求動態讀取參照指南:`references/migration_safety_checklist.md`。
  - 嚴禁預先載入無關的備份還原與維運手冊。
這項原則同樣適用於專案根目錄的 AGENTS.md。與其將專案架構、程式風格規範、部署步驟與團隊禁忌全塞在一份長文檔中,更優雅的實踐是將 AGENTS.md 作為索引頁,依據模組路徑與檔案副檔名,導引 Agent 在觸及特定目錄時再行載入局部規則。
從微步操作手冊轉向完成定義(DoD)與靶向驗證
在任務提示詞與驗證機制上,OpenAI 官方指南提出了極具顛覆性的工程建議:大砍無意義的全套測試要求。
在早期模型時代,工程師往往習慣在提示詞內強制加上「每次修改任何檔案後,必須跑完整套整合測試與單元測試」。但面對 GPT-6 Astra,這種做法極其低效。讓模型為了一行變數名稱的修訂,反覆執行耗時數分鐘的全套測試,只會導致巨大的運算浪費與推論延遲。
OpenAI 指出,高階 Agent 具備自我評估測試範圍的推理能力。工程師在提示詞中應該建立的是「靶向驗證(Targeted Verification)」心態,要求模型針對修改範圍自主設計最小驗證集,而非無差別呼叫龐大測試套件。
| 評估維度 | 舊版微觀管理架構(Legacy Scaffolding) | GPT-6 Astra 漸進自主架構(Astra Pattern) |
|---|---|---|
| Skill 描述風格 | 冗長手冊、詳列限制、佔用數千 Tokens | 僅陳述核心功能與確切觸發時機(極簡) |
| 文件載入機制 | 起始全量載入、無差別讀取所有規範 | 依需求動態載入(Progressive Disclosure) |
| 提示詞控制顆粒 | 手把手微步指令、限制模型每步行動 | 明確目標、自主邊界與完成定義(DoD) |
| 規則衝突處理 | 多層文件相互矛盾、引發決策死鎖 | 職責隔離、單一真理來源(Single Source) |
| 品質驗證機制 | 強制每次修改無差別跑完全套測試 | 模型針對變更範圍執行高覆蓋率靶向驗證 |
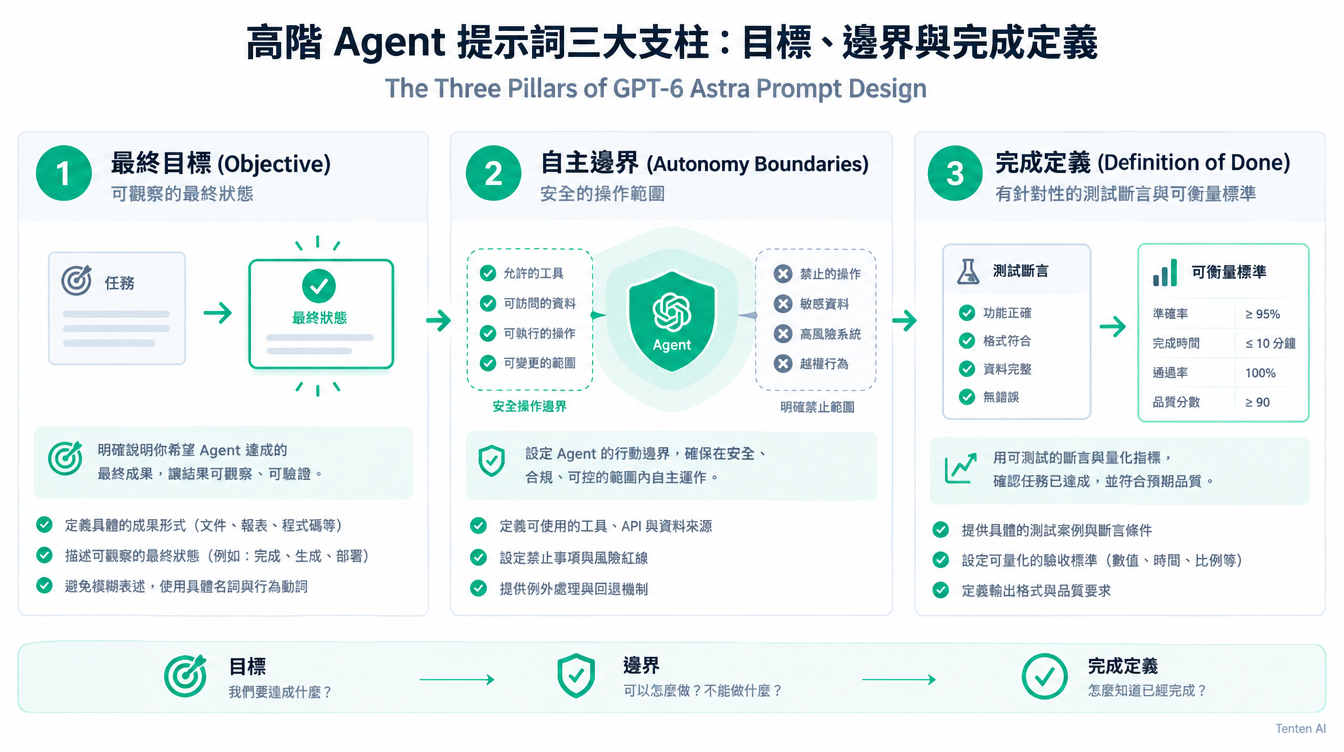
工程師與高階 Agent 協作時,提示詞不再需要鉅細靡遺說明每一步該做什麼。真正決定交付品質的,只有三個核心要件:
- 最終目標(Objective):系統最終需要達成的可觀察狀態或功能產物。
- 自主權限邊界(Autonomy Boundaries):模型在何種權限範圍內可自由決定架構,哪些操作(例如資料庫破壞性變更)必須中斷請求確認。
- 完成定義(Definition of Done, DoD):驗收該任務的客觀條件,例如特定測試通過、型別檢查無錯誤或特定端點回應預期狀態碼。
當完成定義清晰明確時,GPT-6 Astra 會在限定邊界內發揮最強大的自我修正能力,以最短路徑達成目標。
常見問題(FAQ)
為什麼把所有規則寫在 AGENTS.md 反而會讓 GPT-6 Astra 表現下降?
當規則文檔過於龐雜時,會佔用寶貴的脈絡窗口,降低模型對主要任務與程式碼語意標記的注意力權重。更嚴重的是,龐雜文檔經常包含彼此衝突的陳述,使高推理模型在權衡規則先後時消耗額外推論資源,造成決策遲緩甚至停滯。
漸進式載入(Progressive Disclosure)會不會增加 Agent 的工具調用次數與延遲?
實務數據顯示,漸進式載入反而能縮短整體執行時間。雖然模型在初期會多進行一次目標文檔讀取,但因初始脈絡極度輕量乾淨,模型能更迅速精準地做出推論,避免了因讀入大量無關規範所引發的重試與修正循環。
如果不強制跑完整單元測試,如何確保 Agent 產生的程式碼品質?
OpenAI 建議使用清晰的「完成定義(DoD)」引導模型。工程師應要求 Agent 針對變更模組執行精準的靶向驗證,並在最終交付前以輕量靜態分析、型別檢查與關鍵路徑測試進行驗收,而非在每一次局部編輯時無差別執行全套耗時測試。
Author Insight
身為長期建構與調優自主 Agent 系統的工程團隊,我們在實務中反覆印證了這項趨勢:工程師最常見的反射動作,是在 Agent 出錯時立即往 AGENTS.md 補上一條「嚴格禁止」或「步驟指南」。當規則堆疊至數萬字時,模型反而陷入決策癱瘓。GPT-6 Astra 的架構提示了下一代自主軟體開發的核心轉變:無須寫出更精密的操作手冊,重在為高推理模型設計乾淨的介面、動態載入的技能樹,以及清晰的驗收基準。
權威引用
- Rethinking skills and prompts for GPT-6 Astra | OpenAI Developers
- OpenAI Developers Official Guidelines