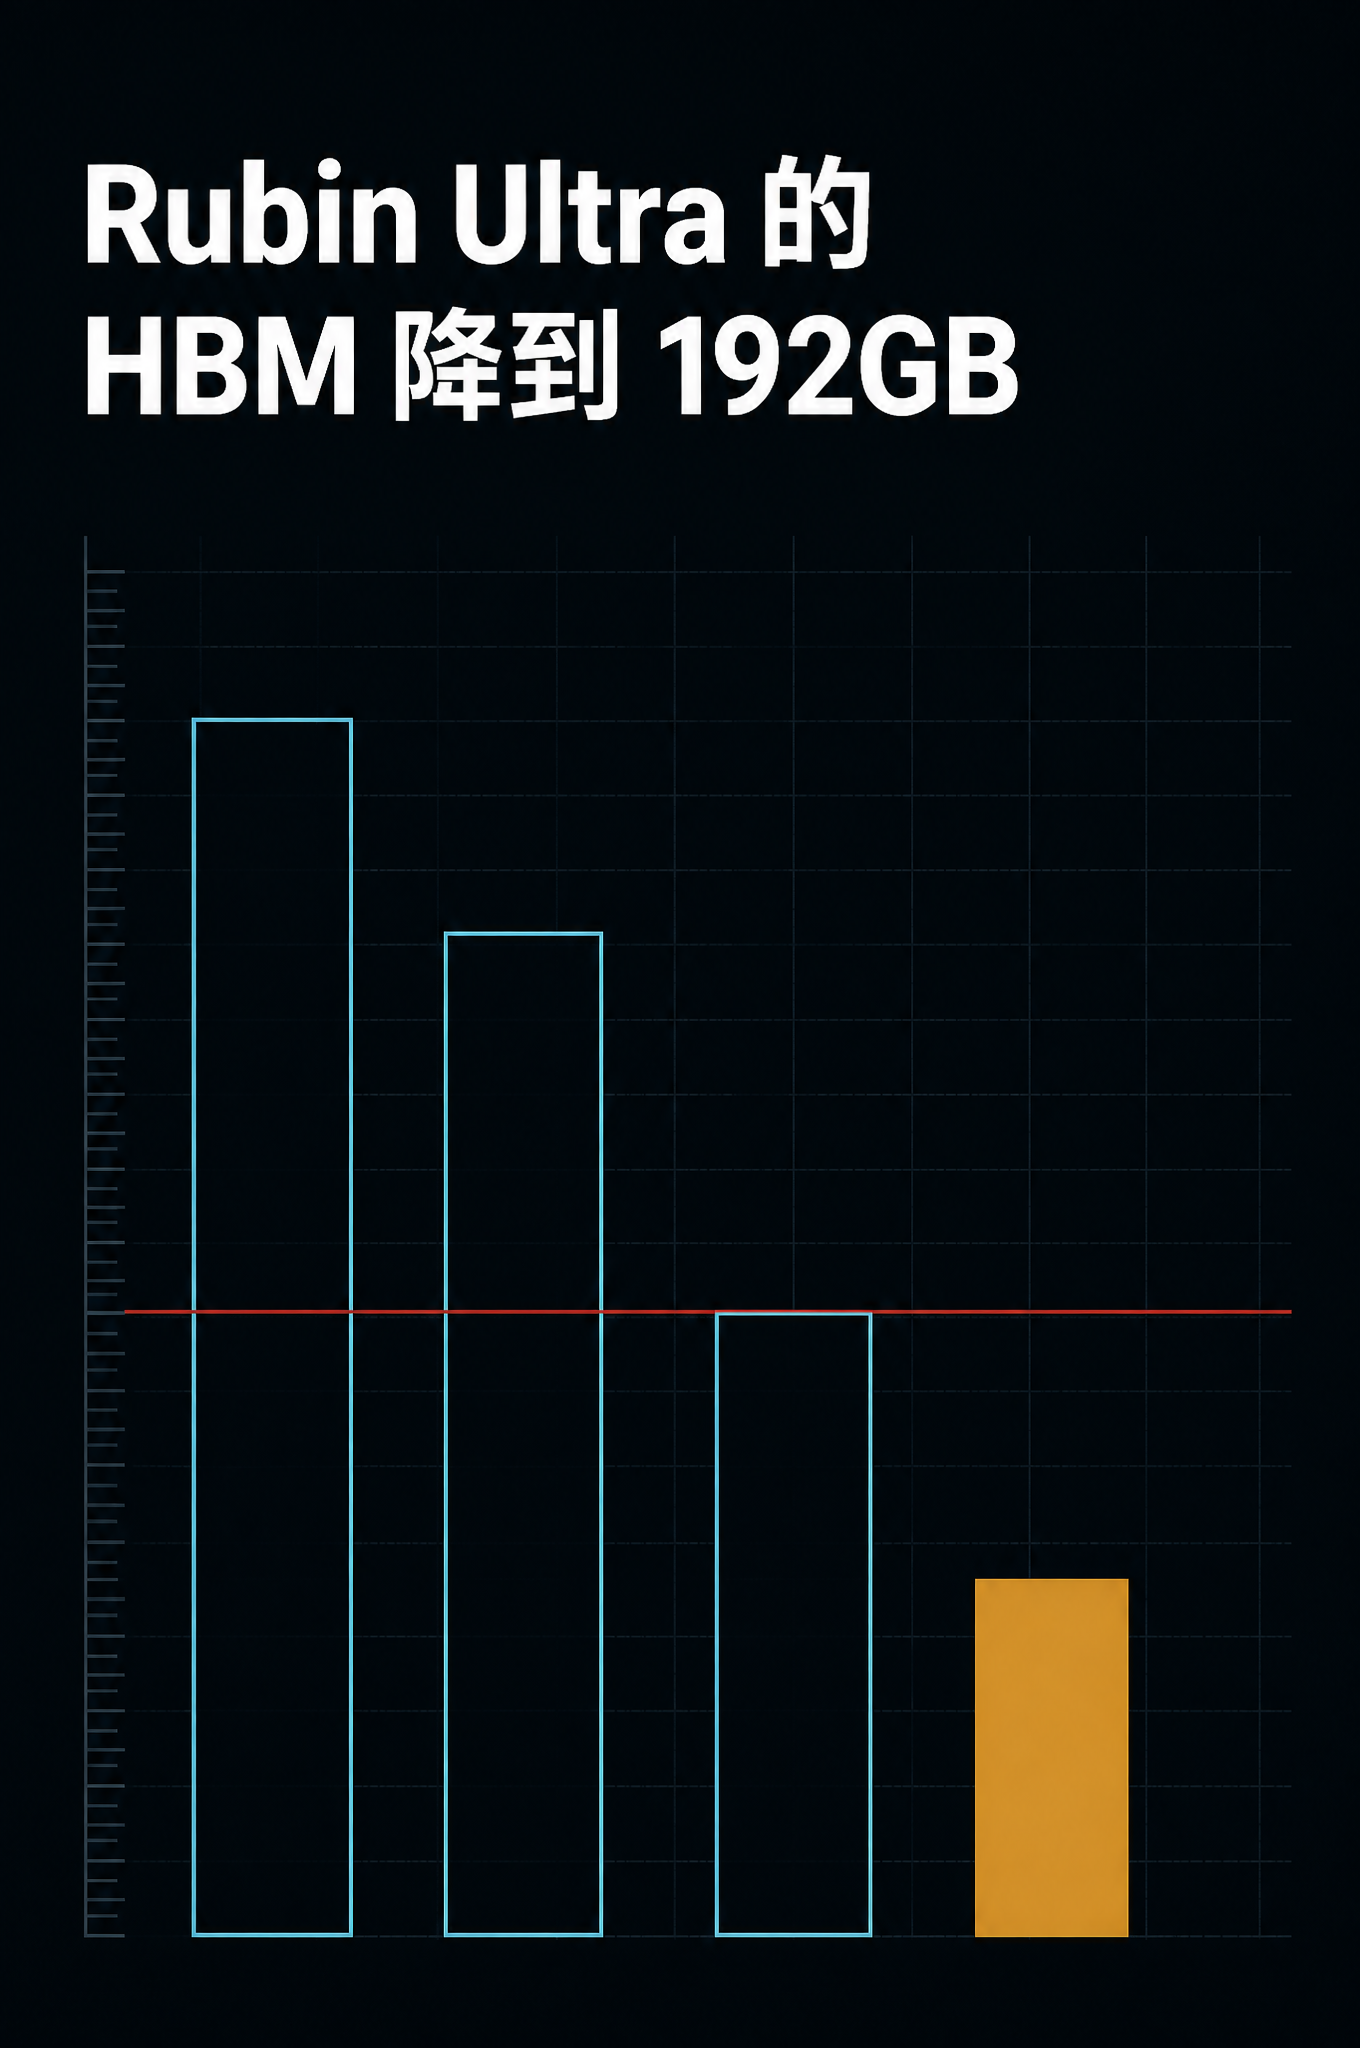
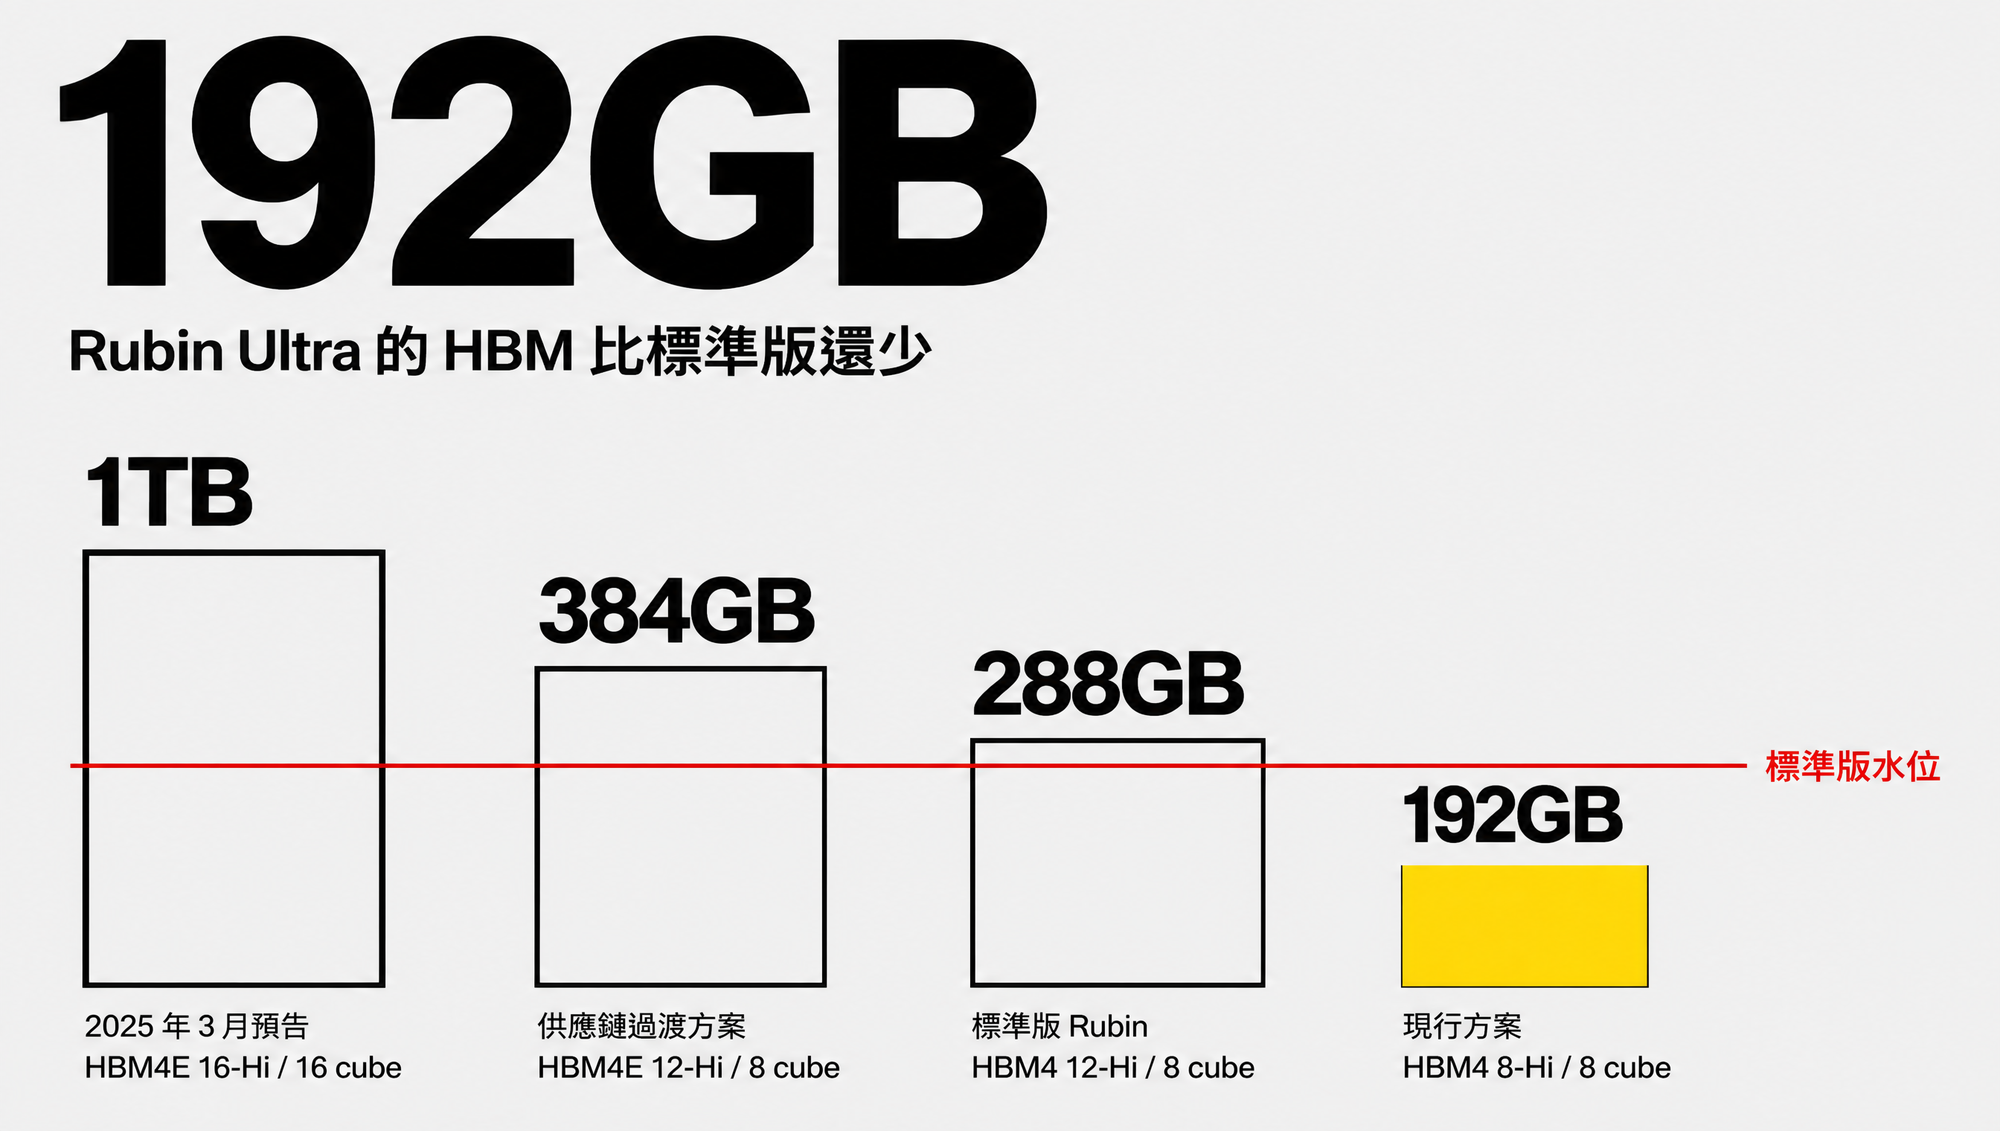
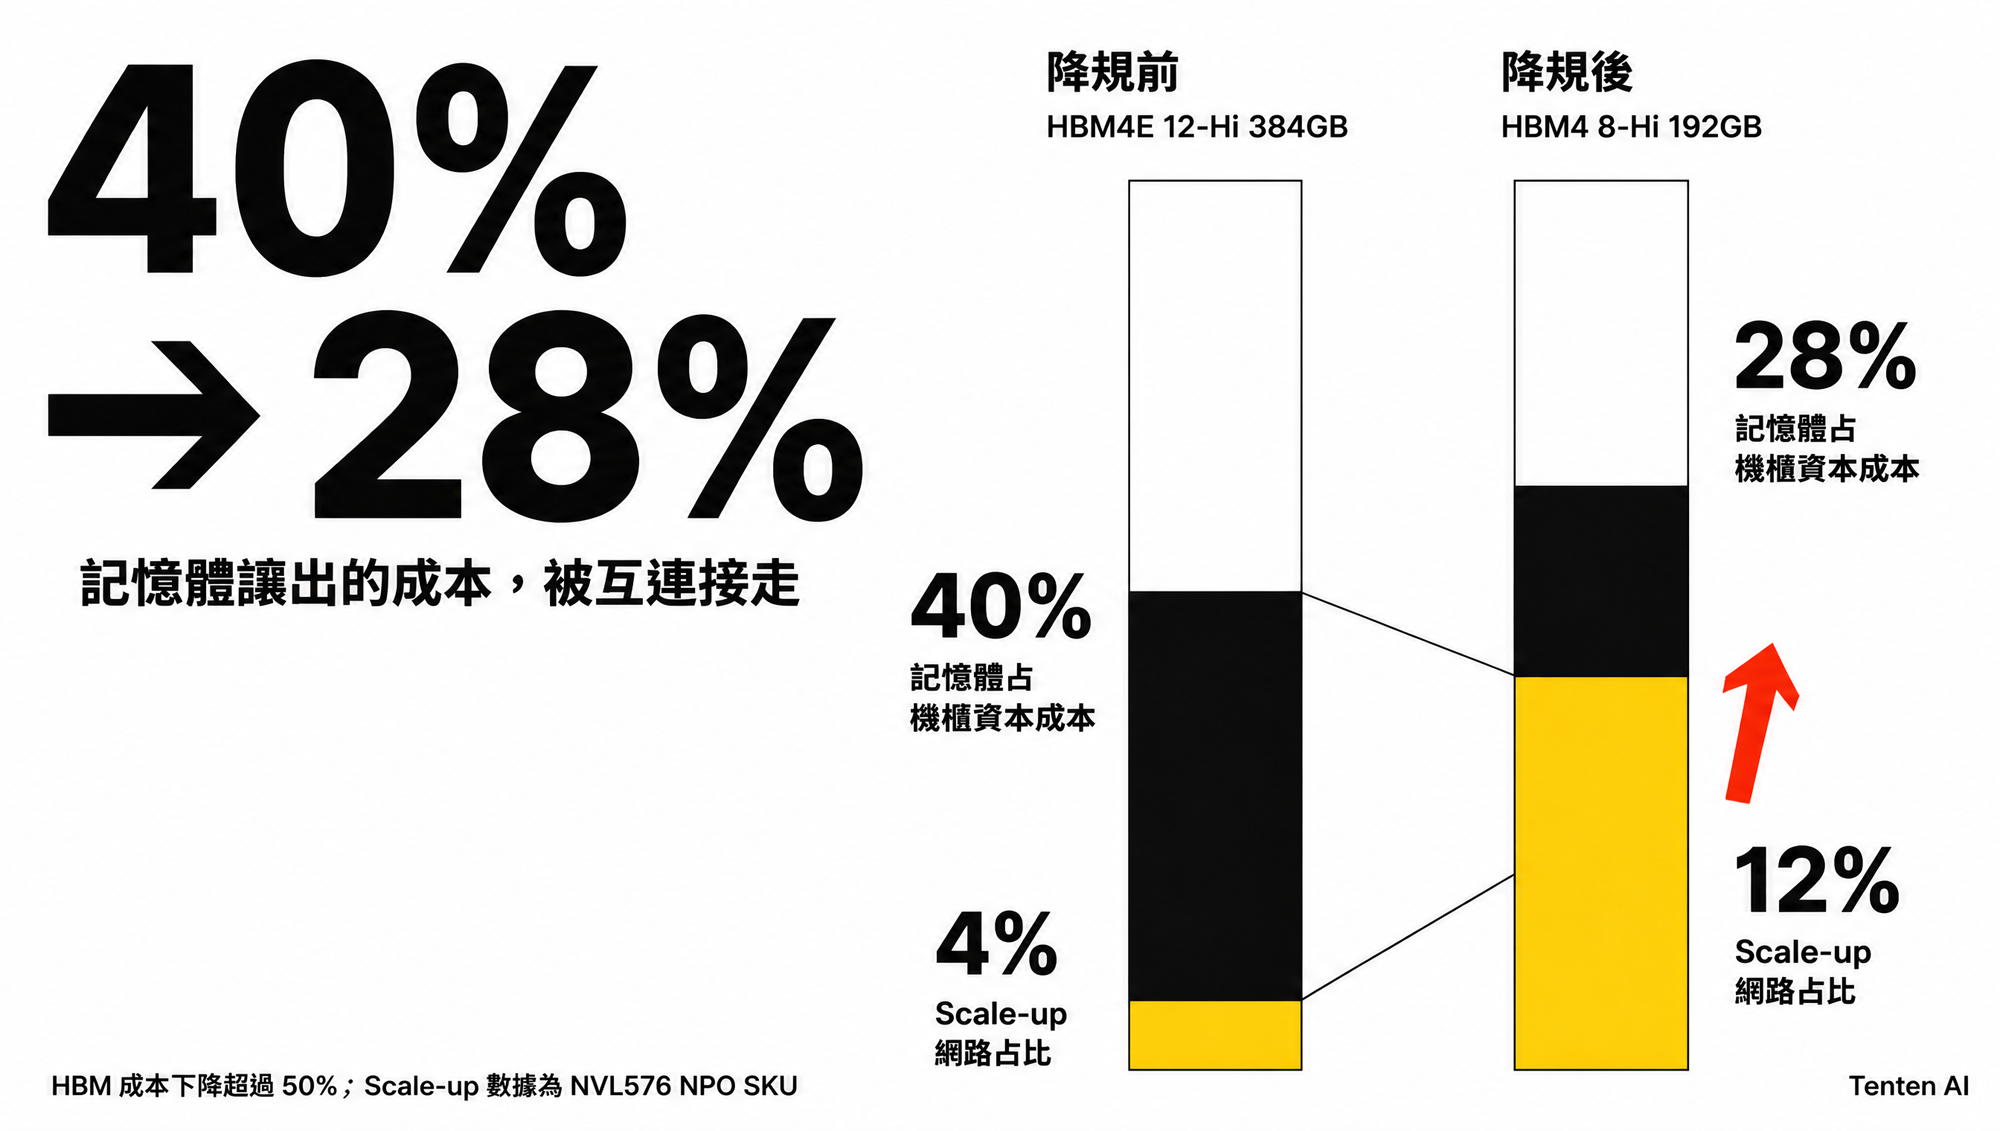
Rubin Ultra 的 HBM 配置已經降到 192GB,比標準版 Rubin 的 288GB 還少。 半導體研究機構 SemiAnalysis 在 2026 年 9 月 2 日公布 TCO 模型。經歷這一輪 HBM 與 DRAM 漲價後,記憶體悄悄吃掉整座機櫃資本成本的四成左右。降規之後這個比例掉到約 28%,scale-up 網路的成本占比則從大約 4% 拉到 12%。NVIDIA 至今沒有在官方 datasheet 確認這組 Ultra 規格。
一顆掛著 Ultra 的旗艦晶片,記憶體比它的標準版兄弟還少。這種事以前不太會發生。
容量是怎麼從 1TB 掉到 192GB 的
2025 年 3 月的 GTC 上,NVIDIA 預告 Rubin Ultra NVL576 時給的數字是單封裝 1TB HBM4E,配 16 個 HBM site。現在市場拿到的版本是 192GB。
SemiAnalysis 在 8 月 24 日把這條路徑拆成三段。第一段,四晶粒版本的 Rubin Ultra 被取消,HBM cube 數從 16 個砍成 8 個。第二段,堆疊高度從 16-Hi 降到 8-Hi。第三段,規格從 HBM4E 退回 HBM4,顆粒也從 32Gb 的 die 換成 24Gb。
這三刀疊起來的算術很乾淨:8 個 cube 乘以 8 層再乘以 24Gb,等於 1,536Gb,剛好是 192GB。原本的 16 乘 16 乘 32Gb,則是 8,192Gb,也就是 1TB。容量掉到原來的五分之一,每一刀都對得上。
中間還有一個過渡方案。供應鏈一度收斂在 HBM4E 12-Hi、8 個 cube 的組合,換算是 384GB。SemiAnalysis 的成本模型就是以這個 384GB 版本當作降規前的基準。
| 版本 | HBM 世代與堆疊 | cube 數 | 容量 |
|---|---|---|---|
| Rubin(標準版) | HBM4 12-Hi | 8 | 288GB |
| Rubin Ultra(2025 年 3 月預告) | HBM4E 16-Hi | 16 | 1TB |
| Rubin Ultra(供應鏈過渡方案) | HBM4E 12-Hi | 8 | 384GB |
| Rubin Ultra(現行方案) | HBM4 8-Hi | 8 | 192GB |
TrendForce 的說法保守一些。這家研究機構在 8 月 4 日發布的新聞稿寫得很明確。NVIDIA 把 Rubin Ultra 的 HBM 評估範圍,從原本的 12-Hi HBM4E 擴大到三種替代方案:8-Hi HBM4E、12-Hi HBM4 與 8-Hi HBM4。官方口徑還在評估,還沒鎖定。
記憶體為什麼會是先被砍的那一刀
短缺不是明年才開始的事,但明年會最痛。
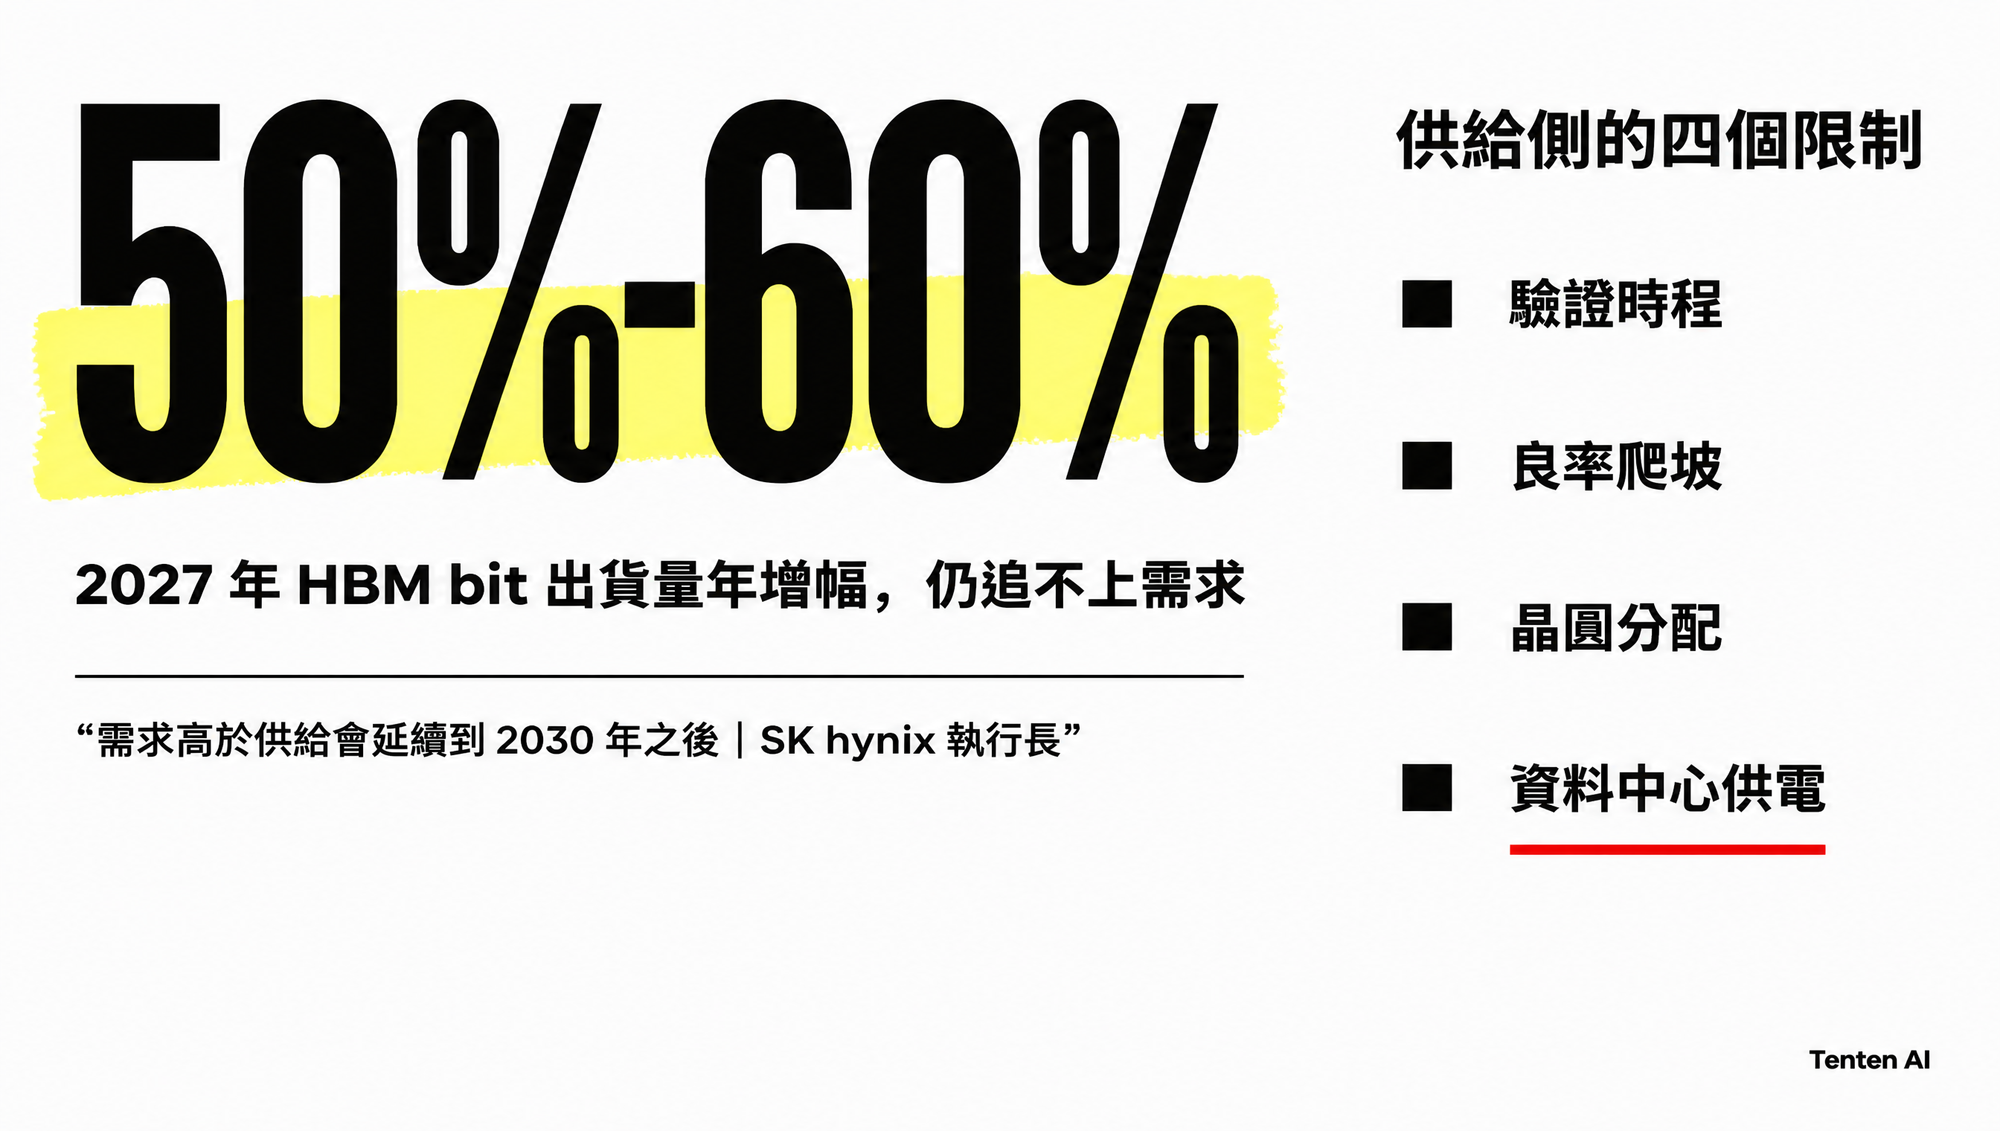
SK hynix 執行長 Kwak Noh-jung 在 2026 年 7 月 10 日的 Nasdaq 掛牌當天告訴路透:「我們預測明年會是這個產業供給史上最糟的一年。」他接著說,客戶需求持續往上,公司產能有其極限,即使過了 2030 年,需求仍然會高於供給能力。
TrendForce 給的數字方向一致。2027 年 HBM bit 出貨量預計年增 50% 到 60%,依然追不上需求成長。這家機構同時指出,12-Hi HBM4E 的驗證時程與良率爬坡都還有不確定性,加上 2027 年 DRAM 缺貨會壓縮可分配給 HBM 的晶圓產能。
驗證風險還會直接吃掉效能。TrendForce 說,HBM4E 能不能準時通過驗證,決定 Rubin Ultra 跑得到 14 到 16 Gbps,還是只能靠 HBM4 的設計優化撐到 11 到 12 Gbps。
所以問題從來不是 NVIDIA 想不想要 384GB。是它拿不到那麼多 12-Hi 的量。
成本表被重寫
這一刀砍下去,機櫃的成本結構整個換了樣子。
| 成本項目 | 降規前(HBM4E 12-Hi、384GB) | 降規後(HBM4 8-Hi、192GB) |
|---|---|---|
| 記憶體占機櫃資本成本 | 約 40% | 約 28% |
| Scale-up 網路占比(NVL576 NPO SKU) | 約 4% | 約 12% |
| HBM 成本變化 | 基準 | 下降超過 50% |
有兩件事值得分開看。記憶體占比從四成掉到不到三成,一部分來自 HBM 本身便宜了一半以上。scale-up 網路從 4% 變 12%,則不只是分母變小的錯覺,NVL576 這個規格本身就要塞進更多互連硬體。
順帶一提,SemiAnalysis 的模型裡有一個數字全程沒動:Rubin Ultra 帶著 27,648GB 的 SOCAMM 記憶體,降規前後都一樣。被砍的是 HBM,不是主記憶體。
錢流去哪裡:從 72 張到 576 張
Rubin Ultra 真正加碼的地方是 scale-up domain。
標準的 Vera Rubin NVL72 一次連接 72 顆 Rubin GPU 封裝,搭 36 顆 Vera CPU 與 36 顆 NVLink 6 switch ASIC。SemiAnalysis 的拆解寫得很細。每個 switch tray 放四顆 NVLink switch 晶片,一座機櫃 9 個 tray,合計 36 顆。
Rubin Ultra 要把這個數字推到 576。做法是把八座 72 GPU 的 Oberon 機櫃組成一個更大的 NVLink fabric,機櫃內部繼續大量用銅,跨機櫃則走 NPO 光互連,形成兩層 all-to-all 網路。
銅在機櫃裡便宜又可靠,拉到機櫃之間就撐不住。這就是為什麼 scale-up 的成本占比會翻三倍。NVSwitch、PCB、銅纜、光模組與 CPO/NPO 這些東西,過去在 BOM 上是配角。
減配不代表需求變弱
看到旗艦降記憶體,第一反應通常是需求撐不住了。供應鏈給的訊息剛好相反。
出貨量還在年增五成以上卻仍然不夠,執行長公開說缺貨會延續到 2030 年之後,這些都不是需求疲軟的樣子。真正的限制在供給端:驗證、良率、晶圓分配,還有資料中心的供電上限。
SemiAnalysis 提到的功耗配置也指向同一件事。主流 SKU 落在 1,800W 的 Max-Q。另外可能有 2,600W 到 2,800W 的 Max-P 版本,以及一個為 token 解碼優化、約 1,200W 的型號。峰值理論 FLOPS 沒有因為降記憶體而改變。
NVIDIA 沒有降低這代的算力承諾。它接受單卡記憶體變少,把有限的 HBM 分給更多 GPU,再用更貴的互連把它們拼成一台機器。
對台灣供應鏈的實際意義
過去幾年 AI 硬體最舒服的位置有明確順序:先是 GPU,後來是 HBM。現在 scale-up domain 從 72 往 576 走,未來還有可能往 1,152 走,價值量正在往互連段移動。
這對台灣的意義很直接。NVSwitch 周邊的高階 PCB、機櫃內的銅連接、跨櫃的光模組與 CPO/NPO 封裝,都是台廠有位置的環節。反過來說,如果一家公司的成長故事完全綁在 HBM 用量上,Rubin Ultra 提醒了一件事:單卡容量並不是只會往上走。
有一個前提要說清楚:這些規格目前都還沒有 NVIDIA 官方 datasheet 背書。SemiAnalysis 與 TrendForce 都是可信度高的研究來源,但它們描述的是供應鏈當下的收斂方向,不是已定案的產品公告。真正的定稿要等 2027 下半年 Rubin Ultra NVL576 出貨才知道。
常見問題
Rubin Ultra 的 HBM 為什麼比標準版 Rubin 還少?
標準版 Rubin 是 HBM4 12-Hi、8 個 cube,容量 288GB。Rubin Ultra 現行方案是 HBM4 8-Hi、8 個 cube,容量 192GB。堆疊層數少了四層,顆粒也從 32Gb 換成 24Gb,兩者相乘後容量就低於標準版。
這代表 HBM 需求開始下滑嗎?
沒有。TrendForce 預估 2027 年 HBM bit 出貨量年增 50% 到 60%,仍然追不上需求。SK hynix 執行長 Kwak Noh-jung 在 2026 年 7 月 10 日表示,需求高於供給的情況會延續到 2030 年之後。降規反映的是供給側的驗證、良率與晶圓分配限制。
降記憶體會讓 Rubin Ultra 變慢嗎?
峰值理論 FLOPS 沒有改變。受影響的是記憶體頻寬與可容納的模型規模。TrendForce 另外指出,如果 HBM4E 沒能準時通過驗證,速率可能落在 11 到 12 Gbps,而不是 14 到 16 Gbps。
NVL576 和 NVL72 差在哪裡?
NVL72 是一座機櫃連接 72 顆 GPU 封裝,內部用銅背板做 all-to-all。NVL576 把八座這樣的機櫃組成更大的 NVLink fabric,機櫃內維持銅連接,跨機櫃改用 NPO 光互連,形成兩層網路。
這組規格已經確定了嗎?
還沒有。NVIDIA 沒有在官方 datasheet 確認。TrendForce 在 2026 年 8 月 4 日的說法是,NVIDIA 正在同時評估 8-Hi HBM4E、12-Hi HBM4 與 8-Hi HBM4 等替代方案。Rubin Ultra NVL576 預計 2027 下半年出貨。
權威引用
- TrendForce — DRAM Supply to Remain Tight in 2027, Prompting NVIDIA to Lower HBM Configurations for Rubin Ultra
- SemiAnalysis — Vera Rubin: Extreme Co-Design, An Evolution from Grace Blackwell Oberon
- NVIDIA Technical Blog — Inside the NVIDIA Vera Rubin Platform: Six New Chips, One AI Supercomputer
- Reuters via Yahoo Finance — SK Hynix CEO sees worst-ever memory supply shortage in 2027, says demand to outstrip supply beyond 2030
- Bloomberg — SK Hynix CEO Expects Memory Crunch to Last Beyond 2030
- Tom's Hardware — Nvidia reportedly testing lower memory configs of Rubin Ultra as memory shortage bites back
- Data Center Dynamics — Nvidia's Rubin Ultra NVL576 rack expected to be 600kW, coming second half of 2027
Author Insight
我看硬體規格表的習慣,是先看被拿掉的東西。加上去的那些通常寫在新聞稿標題,拿掉的才透露真正的限制在哪裡。
Rubin Ultra 這次很少見。一個叫 Ultra 的產品,記憶體比它的標準版少了 96GB,而且 NVIDIA 沒有為此降低算力承諾。它寧可讓每顆 GPU 少配記憶體,也要維持 576 張卡的 scale-up 規模。這個取捨等於把賭注押在互連,不押在單卡容量。
我對這個判斷有點保留的地方在時間點。SemiAnalysis 和 TrendForce 描述的是 2026 年夏天的供應鏈狀態,而出貨要等 2027 下半年。中間隔了四個季度,HBM4E 的良率如果爬得比預期快,這組規格完全有可能再改一次。研究機構的模型是在跑一個移動中的靶。
所以如果你在做零組件相關的判斷,我會建議把重點放在方向而不是數字:互連的成本占比在上升,這件事比 192GB 這個特定數字更耐久。
術語表
- HBM(High Bandwidth Memory,高頻寬記憶體):以矽穿孔垂直堆疊多層 DRAM die 的記憶體封裝,供 AI 加速器使用。
- 8-Hi/12-Hi/16-Hi:一個 HBM cube 裡堆疊的 DRAM die 層數,數字愈大容量愈高、製程難度也愈高。
- HBM4 與 HBM4E:相鄰兩個 HBM 世代;HBM4E 使用 32Gb 顆粒,HBM4 使用 24Gb 顆粒。
- cube(堆疊體):一組垂直堆疊的 HBM die 與其基底晶片,一顆 GPU 封裝周圍會放多個 cube。
- Scale-up domain(縱向擴充域):透過高速互連被視為單一加速器的 GPU 數量,NVL72 是 72,NVL576 是 576。
- NVLink/NVSwitch:NVIDIA 的 GPU 對 GPU 高速互連協定與交換晶片。
- CPO/NPO(共同封裝/近封裝光學):把光引擎放在交換晶片封裝內或旁邊,以降低跨機櫃互連的功耗與延遲。
- SOCAMM:伺服器用的可插拔壓縮記憶體模組規格,屬於主記憶體,與 HBM 分開計算。
- BOM/TCO:物料清單與總持有成本,是評估機櫃級系統經濟性的兩個常用口徑。
- Max-Q/Max-P:同一顆晶片的低功耗與高效能配置,對應不同的功耗上限。