高通 Dragonfly 資料中心路線圖把 AI 推論的比較單位,從峰值算力拉到每瓦能產生多少 token。 高通在 2026 年 9 月 14 日的 AI Infra Summit 預告中,主張搭配 High Bandwidth Compute(HBC)可達最高 8 倍每秒每瓦 token;但第一代 HBC 搭配 AI250 預計到 2027 年中才送樣,現階段仍是供應商估算與產品規畫。
這個時間差決定了新聞該怎麼讀。高通已經把 CPU、推論加速器、近記憶體運算、連結與客製化晶片整成機櫃級產品組合,也取得 Amazon 這個具名合作對象。真正能讓雲端業者改採新架構的證據,還要等硬體送樣、實際模型測試、軟體成熟度與量產交付。
高通先換掉資料中心的計分板
AI 訓練常用浮點運算量描述規模,推論業者最後付的帳單卻包含電力、記憶體、網路、冷卻與閒置容量。代理型 AI 會反覆讀取上下文、呼叫工具並產生更多 token,模型權重與 KV cache 必須持續搬動。單顆晶片的峰值運算量很高,如果資料供應跟不上,機櫃仍可能在等記憶體。
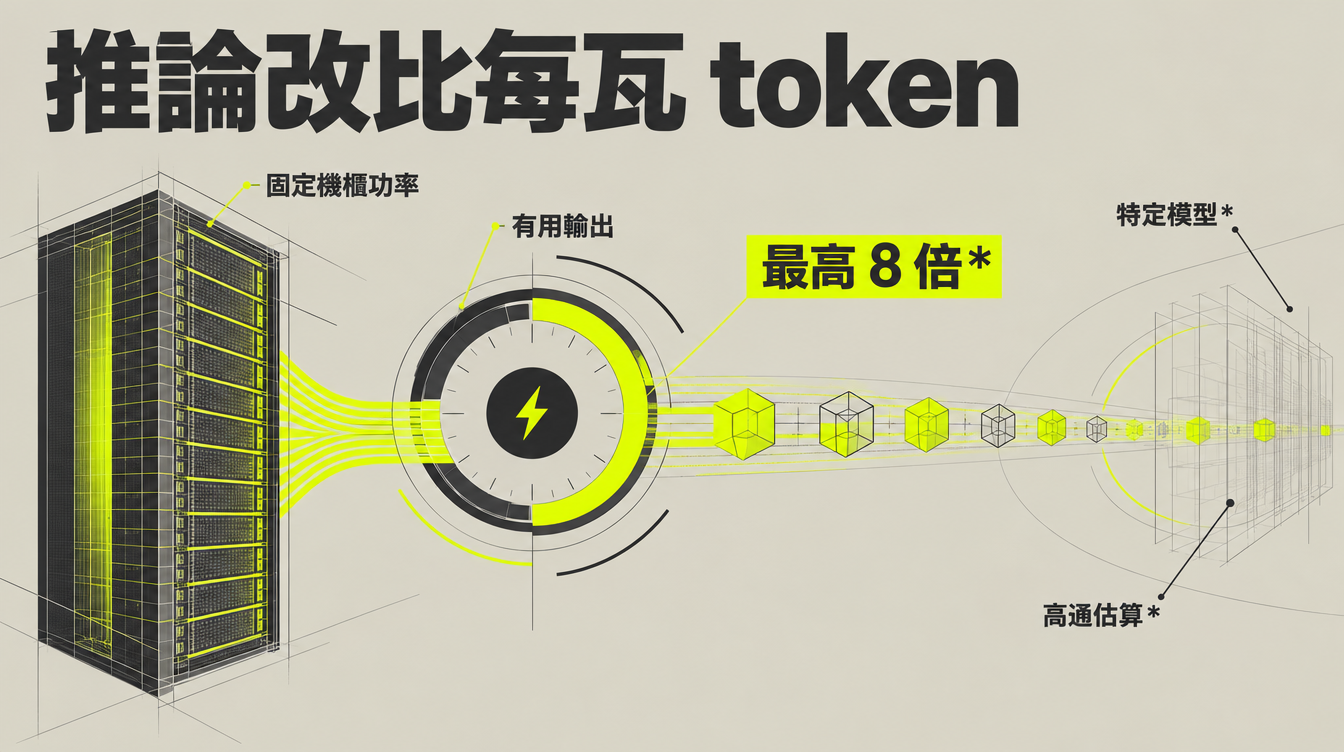
高通資料中心事業執行副總裁暨總經理 Tony Pialis 因此把「每瓦 token」放在 Dragonfly 的中心。9 月 14 日的官方文章列出四組效率主張:搭配 HBC 時,特定模型的解碼效能最高可達當代 GPU 架構的 8 倍每秒每瓦 token;記憶體容量功耗比最高為 SRAM 路線的 200 倍;記憶體頻寬功耗比最高為傳統 HBM 設計的 6 倍;C1000 CPU 的每瓦效能估計高於最新伺服器 CPU 系統 2 倍以上。
四組數字的腳註都很重要。8 倍是高通針對特定模型的估算;200 倍以機櫃級公開規格正規化;6 倍以卡級公開規格正規化;CPU 比較同樣根據產品規格與既有基準推估。它們適合用來理解高通要攻哪個成本環節,還不能拿來當第三方採購評測。
| 高通提出的指標 | 官方比較基準 | 目前能支持的結論 |
|---|---|---|
| 最高 8 倍每秒每瓦 token | 搭配 HBC、特定模型解碼、當代 GPU 架構 | 供應商估算,需保留模型與測試條件 |
| 最高 200 倍記憶體容量功耗比 | SRAM 路線、機櫃級公開規格正規化 | 說明大容量記憶體的設計方向 |
| 最高 6 倍記憶體頻寬功耗比 | 傳統 HBM 設計、卡級公開規格正規化 | 說明 HBC 的功耗訴求 |
| 2 倍以上 CPU 每瓦效能 | 既有伺服器 CPU 規格與基準 | C1000 的目標值,並非現貨實測 |
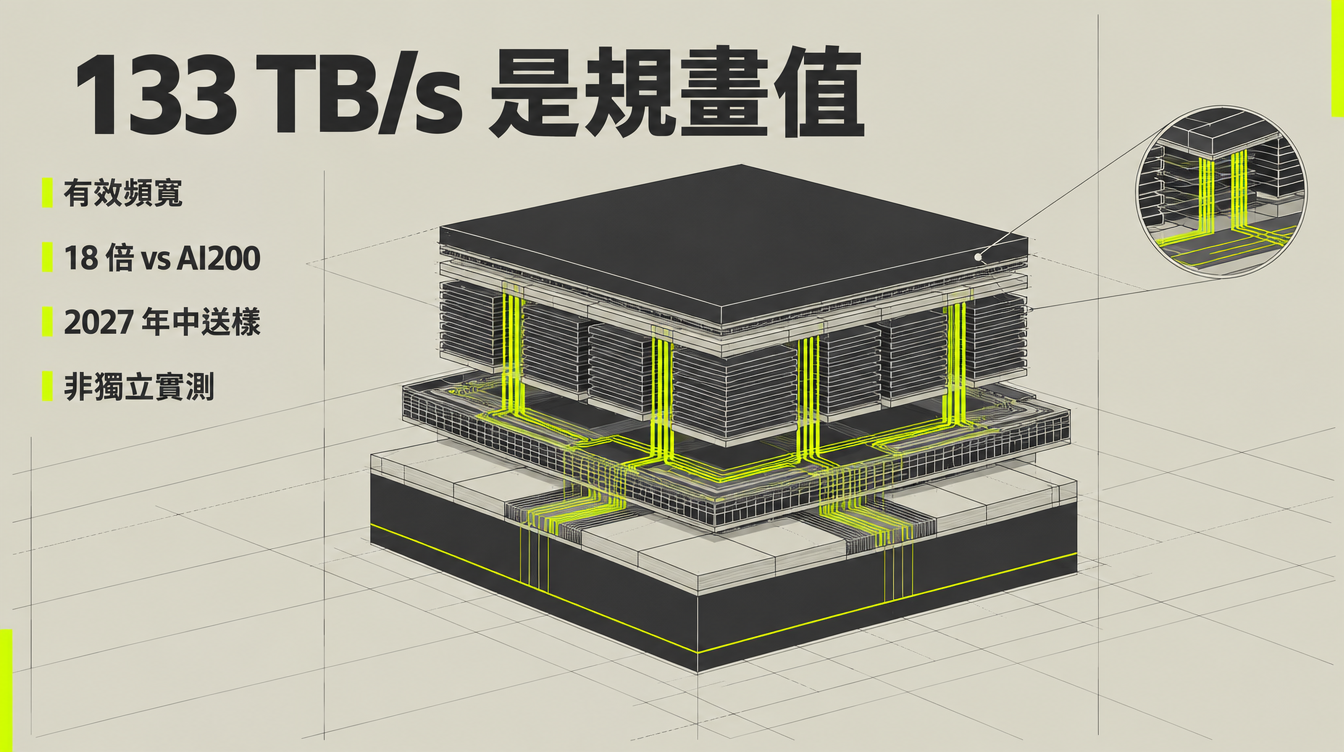
133 TB/s 是有效頻寬規畫,不是現成卡的實測
高通在 6 月 24 日公布的歷史基線更具體。HBC 是 3D 堆疊的近記憶體運算架構,把運算單元貼近高頻寬記憶體,目的是減少資料搬移。官方規畫讓 AI250 搭配第一代 HBC,達到每卡 133 TB/s 的有效記憶體頻寬,相較 AI200 搭配 LPDDR5X 增加 18 倍;AI300 搭配第二代 HBC,則規畫達到 AI200 的 54 倍。
「有效」兩字不能省。133 TB/s 描述特定平台如何利用近記憶體運算提高可用頻寬,並非今天可買到的 AI250 卡實測傳輸率。18 倍與 54 倍也都以 AI200 為官方比較基線,不能外推成對所有 HBM GPU 的領先幅度。
記憶體之所以成為推論戰場,可以從既有軟體整合看到一個縮影。Modular 在 8 月 18 日公開的工程紀錄使用 Qualcomm Cloud AI 100 Ultra,而非尚未送樣的 AI250 或 AI300。團隊讓 Gemma 4 31B 以四顆 SoC 分割執行,並指出 batch size 為 1 的解碼步驟受記憶體限制。這支持「資料搬移會限制推論」的方向,卻不能替 HBC 的未來效能背書。
路線圖跨到 2028 年,成熟度不能混在一起
Dragonfly 不是一款單獨晶片。它涵蓋 C1000 CPU、AI200/AI250/AI300 推論加速器、HBC、客製化晶片與連結方案。各產品的公開成熟度不同。
| 時間 | 已公開事項 | 讀者應保留的界線 |
|---|---|---|
| 2026 年 6 月 24 日 | 高通公布 C1000、HBC 與 AI300 路線圖 | 多項數字是設計目標與供應商估算 |
| 2026 年 9 月 8 日 | 高通與 Amazon 公布跨世代客製化推論晶片及最高 1.6T 光連結合作 | 公告未指名採購 C1000、AI250 或 AI300 |
| 2026 年 9 月 14 日 | 高通發布 AI Infra Summit 展示預告 | 不能與 9 月 22 至 24 日的夏威夷 Snapdragon Summit 混為一談 |
| 2027 年中 | AI250 搭配 HBC Gen 1 預計商業送樣 | 送樣是客戶驗證起點,不等於量產部署 |
| 2028 年 | C1000 預計商用;AI300 預計商業送樣 | 兩者一個是商用、一個是送樣,成熟度不同 |
C1000 本身也反映機櫃策略。官方規畫超過 250 顆 Oryon 核心、時脈高於 5 GHz,並提供超過 2 TB/s 的 PCIe Gen 7 連線能力,可搭配 HBC 做 CPU 推論。規格很大膽,交付仍在 2028 年。把它寫成高通已經有一整套現貨機櫃,會抹掉兩年的執行風險。
Amazon 讓客戶需求變得具體,卻沒有揭露採購型號
Amazon 合作讓 Dragonfly 多了一個具名的超大規模雲端夥伴。雙方在 9 月 8 日宣布,將共同開發多世代客製化晶片,用於大型 AI 資料中心推論,也合作最高 1.6T 與後續世代的光連結。Cristiano Amon 談的是高通的低功耗處理、晶片設計與系統整合能力;Amazon 則帶來實際的大型資料中心需求。
公告沒有把合作綁到 C1000、AI250、AI300 或特定交貨批次。對高通而言,具名客戶證明超大規模雲端業者願意討論另一條推論路線。對採購者而言,它仍不是可下單的標準產品清單,更不能把 Amazon 的客製化合作當成未來 Dragonfly 效能已通過驗證。
高通選「每瓦 token」當切入點,有明確的競爭理由。若高通直接比峰值運算量,它要在 GPU 供應商最熟悉的戰場追趕。改比固定機櫃功率下能服務多少 token、放進多少模型,便把手機與邊緣裝置累積的低功耗設計經驗帶進資料中心採購語言。這個策略很合理。數字是否成立,仍得看客戶工作負載。
軟體與連結會決定記憶體優勢能否變成訂單
Modular 的整合紀錄同時揭露軟體門檻。Cloud AI 100 Ultra 跑 GPT-2 的初版,比既有 Qualcomm PyTorch 基線慢約 1.6 倍;工程團隊花約三週調整核心、算子融合與派送後,才做到該基線的 6.7 倍。這個結果只適用於 GPT-2 124M、指定硬體與指定基線,不能拿去宣稱高通全面領先 GPU。
更重要的是,團隊仍需為 NPU 寫硬體特定核心,Gemma 4 的四晶片通訊也有待降低 all-reduce 成本。MAX 與 Mojo 減少了上層模型重寫,沒有消除底層調校。對大型客戶來說,採購判斷會落在一整組可觀察證據:常用模型的吞吐與延遲、固定功率下的 token 成本、模型容量、軟體支援、跨卡通訊,以及實際交付時程。
高通已經提出一個清楚的挑戰:AI 推論要用有用輸出與能源成本評分。現在輪到 2027 年中第一批 HBC 樣品,證明這張新計分板真的對它有利。
常見問題
高通的 133 TB/s 是實測記憶體頻寬嗎?
不是公開的獨立實測。高通把它列為 AI250 搭配 HBC Gen 1 的每卡有效記憶體頻寬設計值,預計 2027 年中商業送樣。評估時應保留「有效頻寬」、平台組合與送樣時程。
最高 8 倍每秒每瓦 token 代表全面領先 GPU 嗎?
不能這樣推論。高通腳註把比較限定在搭配 HBC、特定模型解碼與當代 GPU 架構,數字也是公司估算。不同模型、批次、精度、延遲目標與軟體版本都會改變結果。
Dragonfly 的產品什麼時候可以買到?
時程各自不同。AI250 搭配 HBC Gen 1 預計 2027 年中送樣;C1000 預計 2028 年商用;AI300 預計 2028 年送樣。送樣與商用不能互換。
Amazon 已經承諾採購 C1000 或 AI300 嗎?
公開公告沒有指名這些型號。雙方確認多世代客製化推論晶片與光連結合作,產品分工、數量、價格與交貨批次仍未完整揭露。
權威來源
- Qualcomm:AI Infra Summit 2026 與 Dragonfly 展示預告
- Qualcomm:2026 年 6 月 Dragonfly 資料中心路線圖
- Qualcomm:與 Amazon 的跨世代 AI 資料中心合作
- Modular:Qualcomm 加速器的 MAX 與 Mojo 整合紀錄
Author Insight
我會把 2027 年中的 HBC 送樣看成真正的分水嶺。高通已經選好最有利的問題:同一個機櫃功率內,誰能交付更多有用 token。接下來若只再公布另一組倍數,資訊價值有限;能重現的模型設定、延遲、功率與軟體版本,才會把路線圖變成採購依據。
術語表
- Tokens per watt(每瓦 token):在固定耗電下產生 token 的效率指標,必須連同模型、批次、精度與延遲條件閱讀。
- HBC(High Bandwidth Compute):高通規畫的 3D 堆疊近記憶體運算架構,目標是降低資料搬移成本。
- 有效記憶體頻寬:把架構與資料重用效果計入後的可用頻寬表述,不等同介面的原始傳輸率。
- 商業送樣:提供客戶驗證硬體的階段,仍可能早於量產與一般商用。
- KV cache:大型語言模型在推論時保存前文注意力狀態的記憶體資料,長上下文與多工作階段會增加容量需求。