高通在 2026 年 9 月 10 日預告,下一代 Hexagon NPU 的共享記憶體子系統將增加 50%,目標是減少手機 AI 運算時的資料搬移。 對要同時處理多個模型的助理而言,運算單元再快,也得等需要的資料送到。評估手機 AI,還得計算一件工作做完要搬多少資料、等多久。
官方說明由高通 AI 產品管理副總裁 Vinesh Sukumar 撰寫。他也介紹針對 Transformer 運算的 Element Accelerator。NPU 是負責神經網路運算的專用處理器;加速運算與把資料留在附近,是兩項相互配合的設計。官方尚未在這篇預告揭露共享記憶體的絕對容量,也沒有可用來推算手機售價的成本資料。
同樣是 50%,容量與速度要分開看
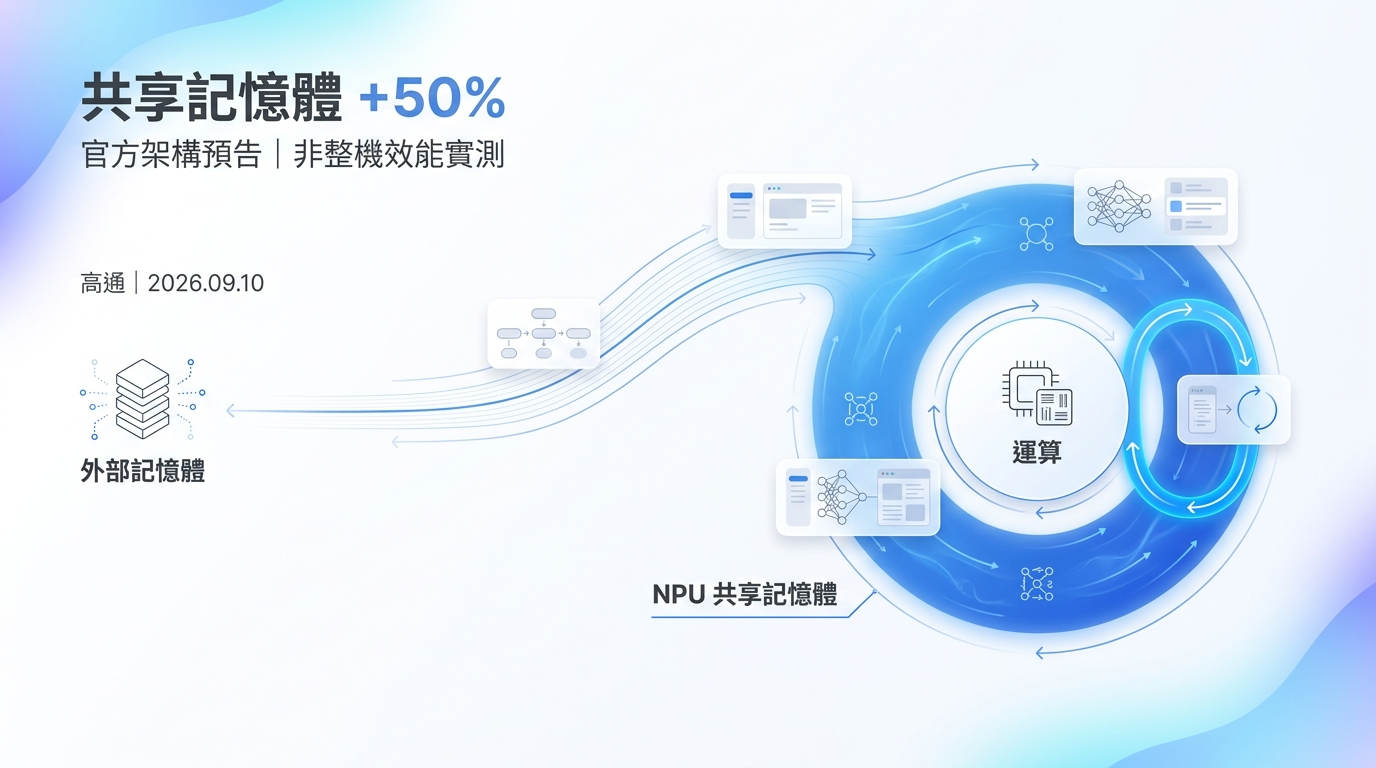
共享記憶體增加,讓處理器有機會把更多運算中的資料留在晶片內,減少存取外部 DDR 記憶體。這是高通提出的設計理由。資料是否真的少搬,還要看模型大小、使用方式,以及軟體能否有效利用新增空間。
另一個 50% 是高通聲稱 INT4 模型的 prefill 效能最高提升幅度。Prefill 指模型產生回覆前處理輸入的階段,後續逐步產生內容則屬於解碼。較快讀完輸入,無法直接換算成整段回答、所有應用程式或電池續航的同比改善。
| 官方預告 | 指標描述 | 尚不能推定的結果 |
|---|---|---|
| 共享記憶體子系統增加 50% | NPU 附近可用的記憶體規模變化 | 手機總記憶體增加 50% |
| INT4 prefill 最高提升 50% | 特定精度、特定推論階段的效能 | 整件工作固定快 50% |
| 支援 INT2、INT4、INT8、FP8、FP16 | 可用的數值格式範圍 | 每個模型都能無損使用最低精度 |
低精度有機會減少儲存與運算需求,但模型品質也要一起驗證。對買家而言,能否正確完成任務比格式名稱更有用。廠商若宣稱某個助理更快,需要交代使用哪個模型、量化方式及輸入長度,才能進行有意義的比較。
30B 模型每次啟動 3B,其餘參數沒有消失
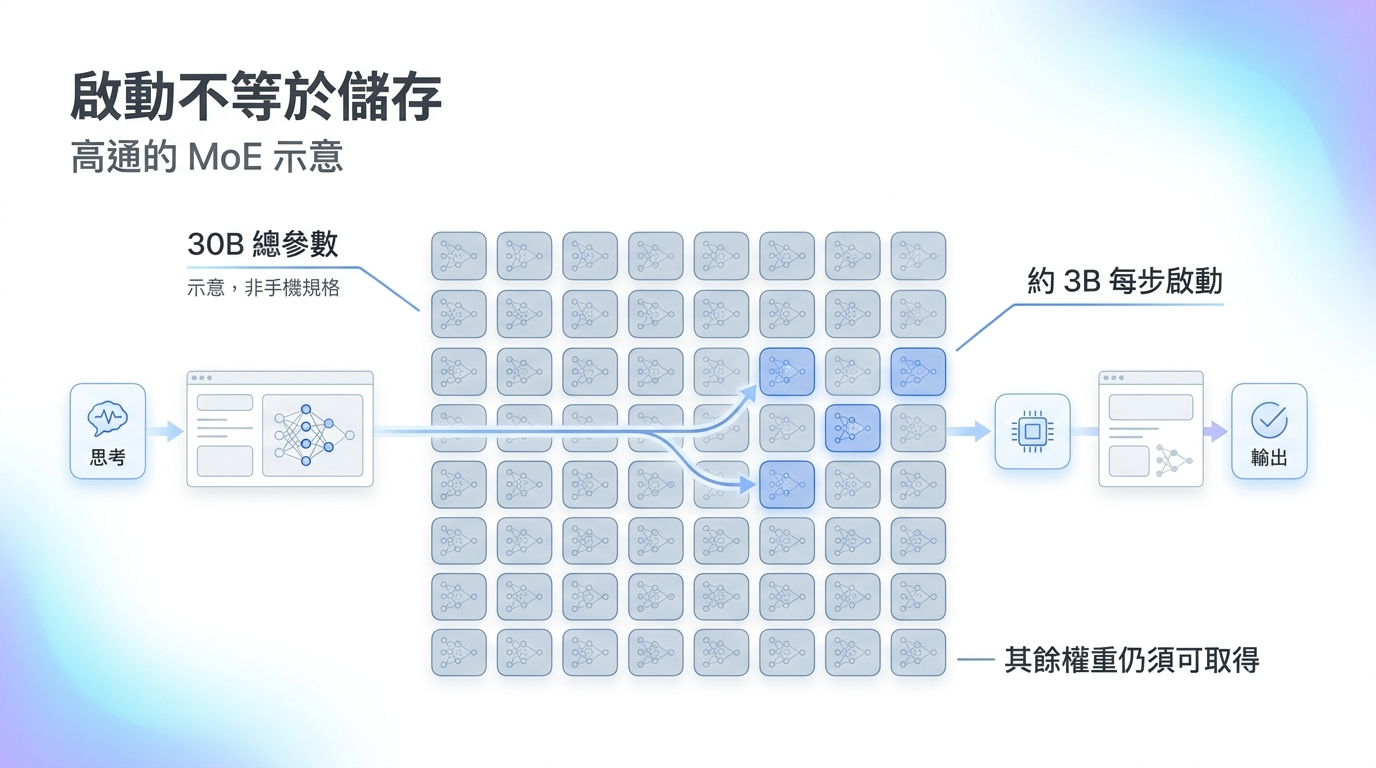
高通用一個 30B 參數的混合專家模型(Mixture-of-Experts,MoE)作例子:每個 token 生成步驟約啟動 3B 參數。B 是十億,token 是模型處理文字等內容的單位。這裡談的是每一步參與工作的參數量,不能寫成整個模型只需 3B 參數的儲存空間。它也不足以證明市售手機已普遍搭載 30B 模型。
MoE 會依輸入選擇部分專家網路參與計算,下一步可能選到不同專家。因此,一次沒有啟動的權重仍可能在後續被需要。軟體必須決定哪些權重先留在記憶體,哪些等需要時再載入。把資料放在快閃儲存,也會遇到讀取速度與搬移量的限制。
既有研究也區分總參數與活躍參數。Albert Q. Jiang 等人於 2024 年 1 月 8 日發表的《Mixtral of Experts》,描述每層從 8 個專家選出 2 個,模型總參數約 47B,每個 token 使用約 13B。它是另一個模型,用來說明總參數與活躍參數的差別,並非新 Hexagon 的實測。
若把兩種數字混用,手機規格就容易被誤讀。以活躍參數估算每一步工作量,與以全部權重估算需要保存的資料,是不同問題。實際記憶體需求還包含運算中的暫存資料。只拿參數數量乘上一個精度,算不出完整裝置需求。
多模型協作,還要支付切換的成本
多個專用模型協作與 MoE 是兩個層次。前者可以是語音模型、文字模型接續工作;後者是在一個模型內選擇專家。兩者都可能受益於減少資料搬移,但不能把它們當成同一種機制。
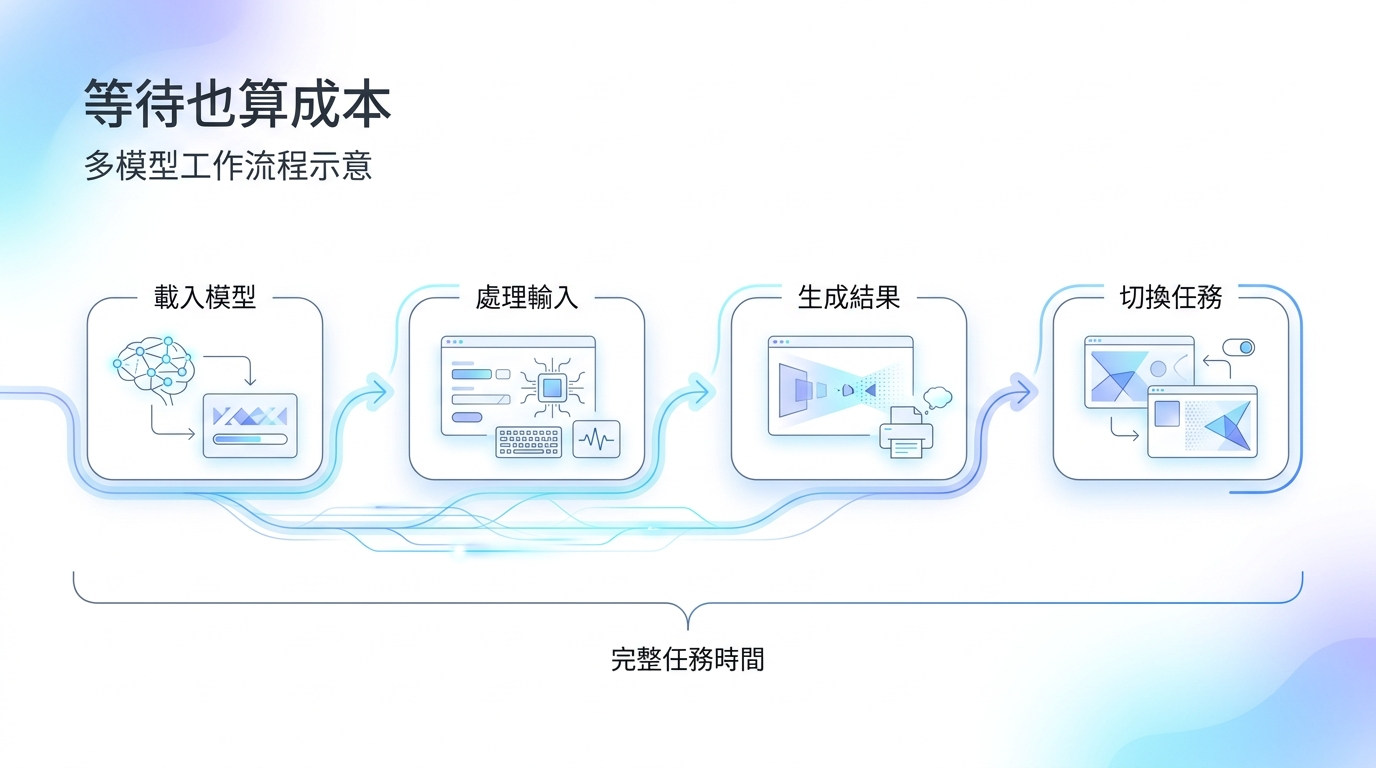
設想一個助理先理解語音,再讀取文件並整理回覆。這是用來分析成本的假設情境。若下一個模型尚未就緒,系統就得先載入。上一段處理留下的資料若還會再用,太早移走又會增加下一輪等待。一次漂亮的單模型跑分,未必涵蓋這些交接。
Keivan Alizadeh 等人的《LLM in a flash》研究,探討把模型權重放在快閃儲存、按需載入 DRAM,並透過資料重用與較連續的讀取減少成本。論文最初於 2023 年 12 月 12 日提交,後收入 ACL 2024。它支持資料搬移值得單獨研究的判斷,沒有驗證高通此次的產品宣稱。
手機品牌需要量測完整工作,包括按下按鈕到第一個有用結果出現的時間。接著切到另一個任務,重新等待的時間也應計入。這些量測才能連接晶片規格與產品體驗。
本地執行能少付雲端帳單,卻不會讓成本歸零
高通公關副總裁 Clare Conley 在 9 月 16 日的個人 AI 情境文章中,描繪裝置與雲端分工,也明確把案例定位為未來願景。這篇文章沒有提供各家手機已上市功能的清單。
若部分工作在手機上完成,服務商就有機會減少相應的雲端推論需求。但成本會有一部分落到裝置與軟體整合。品牌要分配記憶體,驗證模型品質,處理更新之後的相容性。消費者則承擔儲存空間與電池使用上的取捨。
這是對成本位置的分析,不能直接寫成已實現的毛利改善。高通這次沒有公開每個任務的能耗、裝置成本增幅或雲端替代比例。即使某個步驟本地化,後續工具操作若仍需連網,也不能把整套助理宣傳成完全離線。
手機品牌還需要交代 TOPS 以外的表現。TOPS 表示每秒兆次運算,適合描述特定條件下的運算能力。它沒有包含任務的全部等待,也不會替模型品質作保。若兩套方案答對率不同,只比較完成時間就失去產品判斷的基準。
峰會之後,應補上哪些裝置證據
9 月 21 日重新查閱的 Snapdragon Summit 官方頁面,仍列出 2026 年 9 月 22 至 24 日在夏威夷茂宜島舉行活動。架構預告先於峰會,不足以確認新平台的完整型號、首批手機或量產時間。
評估下一輪手機時,我會先固定任務與品質要求,再比較冷啟動和連續使用的結果。模型已經載入時的速度,只回答了部分問題。首次開啟、背景程式占用記憶體,以及一段時間後的耗電,都需要另外測量。
| 評估問題 | 需要的裝置證據 |
|---|---|
| 多模型協作是否更快? | 相同任務下,包含載入與切換的端到端延遲 |
| 記憶體增加帶來多少收益? | 容量、資料搬移量及實際工作集條件 |
| 低精度是否值得採用? | 相同測試集的答案品質與失敗案例 |
| 能否日常持續使用? | 連續負載下的能耗、溫度與前景反應 |
| 哪些功能現在可用? | 具名手機、軟體版本及正式供應日期 |
常見問題
Hexagon 記憶體增加,是手機 RAM 一起增加嗎?
官方談的是 NPU 的共享記憶體子系統,不能直接套成手機主記憶體的容量變化。裝置 RAM 規格仍要查手機品牌的正式資料。
活躍參數少,為什麼還需要較大的儲存空間?
MoE 在不同步驟可能選擇不同專家,未啟動的權重仍須在需要時可取得。模型儲存、執行時記憶體與每一步運算量應分開評估。
多模型協作就是 MoE 嗎?
多模型協作可以讓不同模型接手不同任務;MoE 則在單一模型內選擇專家網路。兩者可能同時使用,但不是同一個概念。
現在能據此決定換手機嗎?
這份架構預告尚未提供完整裝置證據。若主要需求是本地 AI,應等待目標機型的軟體支援、正式供應時間與完整任務測試。
權威來源
- 高通:下一代 Hexagon NPU 架構預告,2026 年 9 月 10 日
- 高通:個人 AI 情境與未來願景,2026 年 9 月 16 日
- Snapdragon Summit 2026 官方活動資訊
- Jiang 等人:Mixtral of Experts
- Alizadeh 等人:LLM in a flash
Author Insight
我會先看新手機能否在模型尚未載入時,穩定交出第一個有用結果。常駐模型的展示容易讓人忽略載入成本,多個助理輪流接手時,這項成本才會變得明顯。高通擴大共享記憶體的方向值得追蹤。手機品牌接下來需要證明,一般使用者不必先把其他程式關掉,也能得到宣傳中的體驗。
術語表
| 術語 | 本文用法 |
|---|---|
| NPU | 執行神經網路運算的專用處理器 |
| Prefill | 模型產生回覆前,處理輸入內容的階段 |
| MoE | 依輸入選擇部分專家網路的混合專家模型 |
| 活躍參數 | 某一步推論實際參與運算的參數 |
| DRAM/DDR | 裝置工作記憶體與相關傳輸技術用語 |
| TOPS | 每秒兆次運算,須搭配精度與測試條件理解 |