OpenAI 在 2026 年 9 月公布的多代理協作研究動用約萬名代理,卻還沒量出這個規模讓研究快了多少。 這個落差,直接影響企業該如何看待下一筆 AI 預算:代理數量可以寫進規格表,效益仍要靠對照證據。
在 2026 年 9 月 17 日的訪談中,OpenAI 研究員 Noam Brown 說,團隊尚未做過單一代理解同一道題的實驗。他主觀判斷,多代理協作的功勞不到一成,主要突破來自更強的模型。這個比例是研究員的歸因,並非實驗量出的貢獻率。原始訪談
多代理協作指的是讓多個 AI 執行個體分工、交換資訊,共同推進任務。對買方而言,還要確認增加代理後,能否更快交出驗收合格的成果。
1,300 億 token 的規模,與它沒有回答的問題
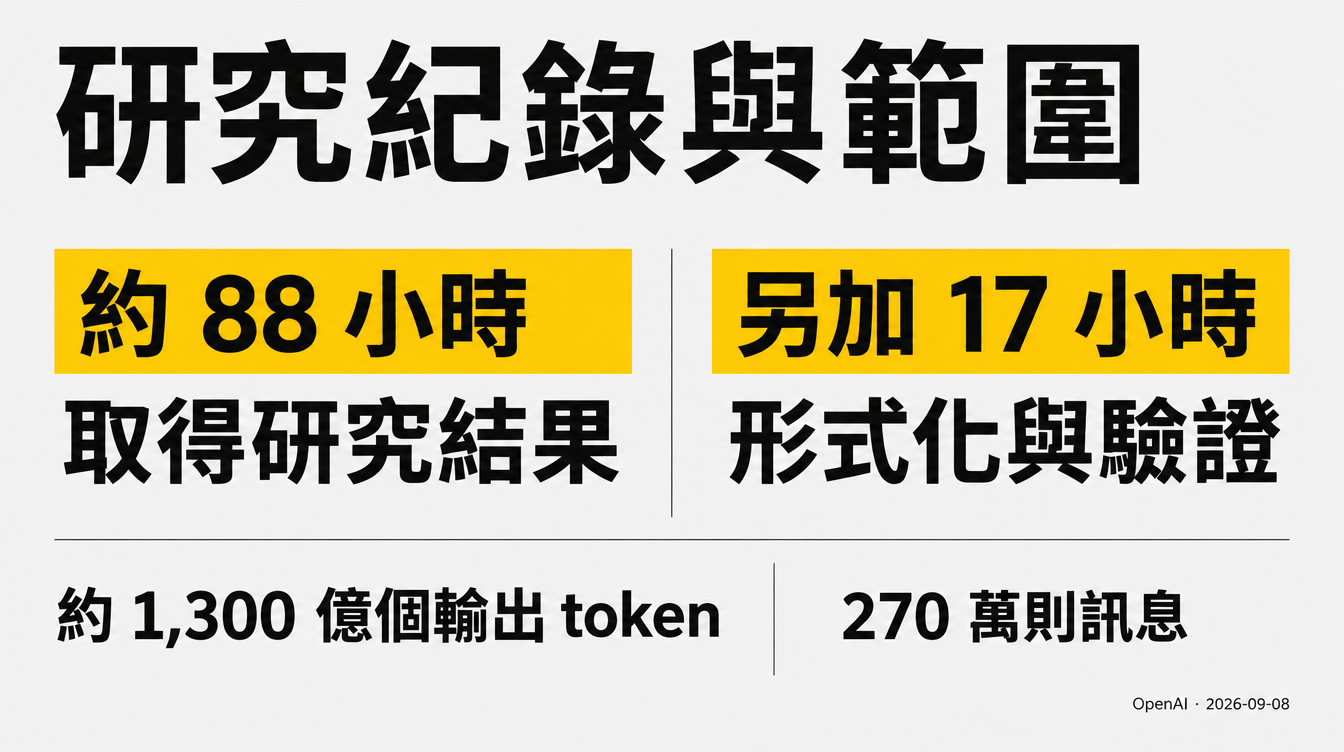
OpenAI 在 9 月 8 日公布 Navier–Stokes 研究,稱找到流體方程在特定條件下形成奇異點的證明。其研究紀錄列出以下數字。官方研究說明
| 紀錄項目 | 公布數值 | 閱讀時的界線 |
|---|---|---|
| 得出 Navier–Stokes 結果的群組 | 約 10,000 名並行代理 | 不代表整段期間維持相同人數 |
| 從首批代理啟動到研究結果 | 約 88 小時 | 不含後續形式化與驗證 |
| 後續形式化與驗證 | 另加 17 小時 | 屬於取得結果之後的工作 |
| 該題訊息數 | 270 萬則 | 訊息量不等於有效知識量 |
| 該題輸出 token | 約 1,300 億個 | 未公布可直接套用的專案總成本 |
token 是模型處理與生成文字的切分單位。它可以衡量輸出規模,卻不能直接衡量一個想法的價值。重複嘗試、推翻錯誤與整理成果,都可能消耗 token;帳面上的量不會自動告訴讀者,哪一部分對答案有幫助。
還少了一組比較。同樣的模型、同樣的題目,交給較小的團隊,能否在可接受的時間完成?若少量代理根本無法完成,增加規模可能打開原先做不到的工作。若小團隊只慢一點點,大規模並行的商業理由就必須來自期限的價值。兩種情況都合理,但需要不同的證據。
目前不能用這次成果判定哪一種成立。把成功案例當成投資起點可以,把它當成所有企業工作的報酬率,會跳過太多尚未量測的條件。
「4,000 年思考」是一個比喻,換算條件不能省略
主持人 Dwarkesh Patel 把這批 token 比作一個人每天思考 8 小時、按照正常工作週工作約 4,000 年。這是訪談中的直覺比喻,並非人類研究工時的實測結果。訪談中的換算說法
要把它當成計算式,至少得先指定每秒對應多少 token、一年有幾個工作日,以及機器輸出與人類思考之間採取什麼對應。即使算術一致,也只能得到所選假設下的等值輸出時間。人會停下來判斷問題是否值得做,也可能在沒有形成語句時產生理解;token 計數沒有測量這些活動。
因此,這個比喻能幫人感受規模,卻不能替人力預算定價。企業若拿它估算可裁減多少研究人員,等於把尚未建立的換算關係直接放進財務模型。
比較可用的做法,是把需求改寫成可觀察的交付條件。例如,一份研究報告必須逐項附上可查證的來源;一份候選方案必須通過事先約定的限制。先說清楚什麼算完成,才有辦法比較完成時間與成本。
多代理協作值得買多少,要看驗收後的時間
企業評估時,可以先固定資料與驗收標準,再比較幾種配置。以下是本文的建議,OpenAI 並未公布這組對照實驗。
| 評估問題 | 應保留的紀錄 | 能支持的決策 |
|---|---|---|
| 增加代理是否縮短等待? | 從交辦到驗收的完整時間 | 是否值得為期限加價 |
| 成果品質是否相當? | 同一套驗收條件與失敗案例 | 是否真的能互相比較 |
| 協作增加多少負擔? | 重複工作、整併與人工審查時間 | 團隊規模該停在哪裡 |
| 更換模型是否更划算? | 不同模型在同一題組的結果 | 預算應放在模型或代理數量 |
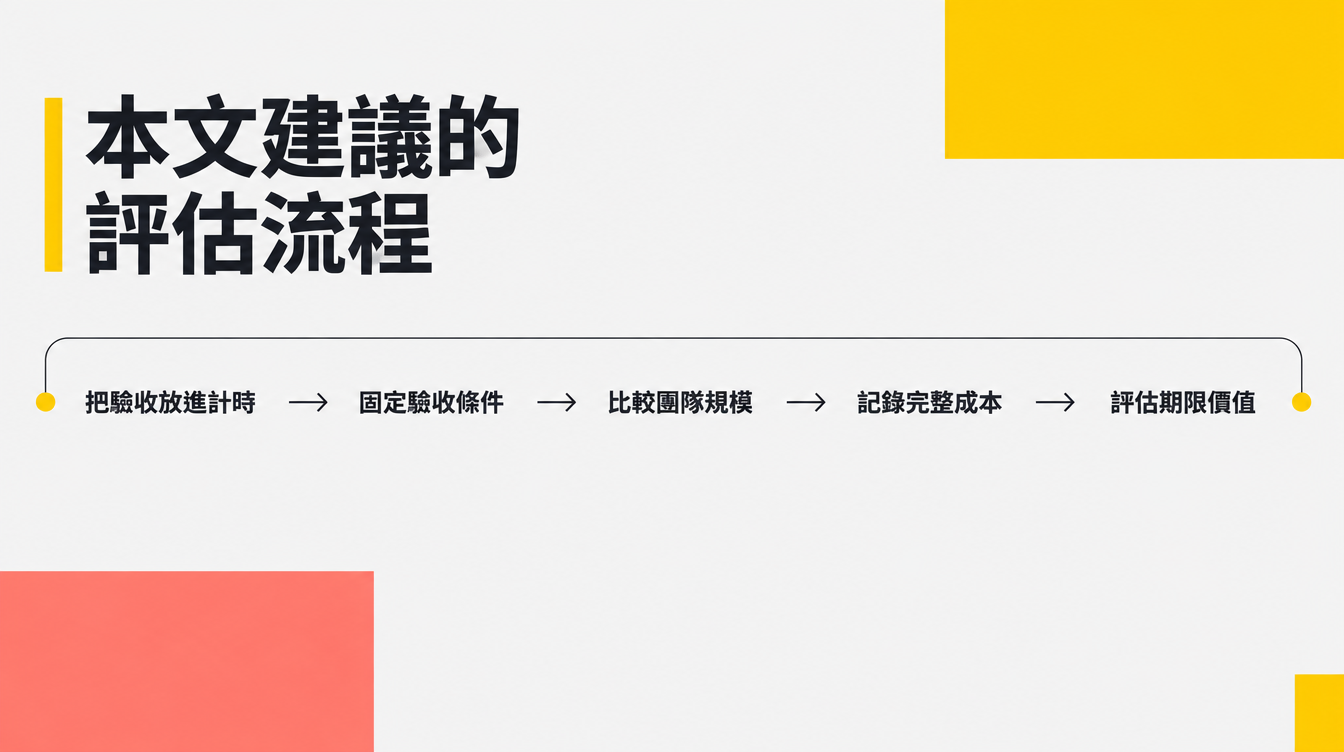
其中最容易漏算的是驗收。有些輸出很快,交付後卻需要大量補證據;另一些配置生成較慢,但比較容易確認正確。若採購報表只記錄第一份答案出現的時間,就可能獎勵了把工作移給審查者的系統。
對照也不必一開始就做到萬名代理。先在有代表性的內部工作上比較幾種可負擔的規模,便能看出下一筆預算是否值得花。測試中途換模型、換資料或放寬驗收條件,都應另外記錄,否則無法把變快歸因於代理數量。
有明確截止時間的工作尤其值得單獨評估。晚一天交付可能失去機會,這時多花運算費換時間,有合理的商業理由。沒有時間壓力的例行工作,則可能更適合追求每份合格成果的成本。兩者不宜共用一張只看速度的排行榜。
形式化證明提供查驗入口,獎項認定另有流程
OpenAI 已公開 Lean 4 形式化內容與獨立檢查說明。其儲存庫把 Navier–Stokes 結果界定在有外力的條件,對應官方問題的 C、D 形式;不能擴寫成所有流體情境都已解決。公開證明儲存庫
Lean 是用來表述與檢查形式化證明的工具。公開這類材料,讓外部讀者有機會查驗具體命題,證據程度比單看模型生成一段自信的文字更高。本文未自行編譯或審核整份證明,不能據此宣告獨立驗證完成。
截至 9 月 18 日,Clay Mathematics Institute 的問題頁仍標示為 Active。其獎項規則要求合格出版、至少經過兩年,以及數學界普遍接受,才會考慮候選解答。研究團隊公布成果與獎項機構認定,應分開報導。問題狀態、官方獎項規則
企業驗收也需要分清這幾個階段。產出候選答案、通過檢查、准許拿來做決策,是不同的階段。採購方應指定誰負責最後一關,並把相關時間算進專案。否則,自動化省下的時間很容易在交接時被高估。
常見問題
這次研究證明萬名代理比單一代理快一萬倍嗎?
沒有。缺少同題、同模型與同等驗收要求的對照結果,無法從代理數量直接推算加速倍率。
1,300 億個 token 可以換算成研究成本嗎?
不能只靠輸出量得出總成本。還要知道實際計價或運算成本、其他資源與人工審查支出,這次公開資料不足以替別人的專案報價。
多代理協作適合直接列入採購規格嗎?
可以列出需求,但應把可驗收的品質、時間與成本一起寫入。單列代理數量,無法證明系統對公司的工作有幫助。
權威來源
- Dwarkesh Podcast:Noam Brown 原始訪談
- OpenAI:Navier–Stokes 研究公告
- OpenAI:公開形式化證明儲存庫
- Clay Mathematics Institute:Navier–Stokes 問題頁
- Clay Mathematics Institute:千禧年獎項規則
Author Insight
我會要求供應商把最有把握的工作交給不同規模的代理團隊,沿用同一份驗收表,再談年度預算。若更多代理確實能在關鍵期限前交出合格成果,溢價有討論空間;若只展示更多訊息與更長輸出,我還看不到加價的理由。
用語表
| 用語 | 本文含義 |
|---|---|
| 多代理協作 | 多個 AI 執行個體交換資訊並共同工作 |
| token | 模型處理或生成文字時使用的切分單位 |
| 對照實驗 | 固定重要條件,比較特定變因造成的差異 |
| 形式化證明 | 以形式語言表述、供檢查工具核驗的證明 |
| 驗收 | 依事先約定的條件確認成果可供使用 |