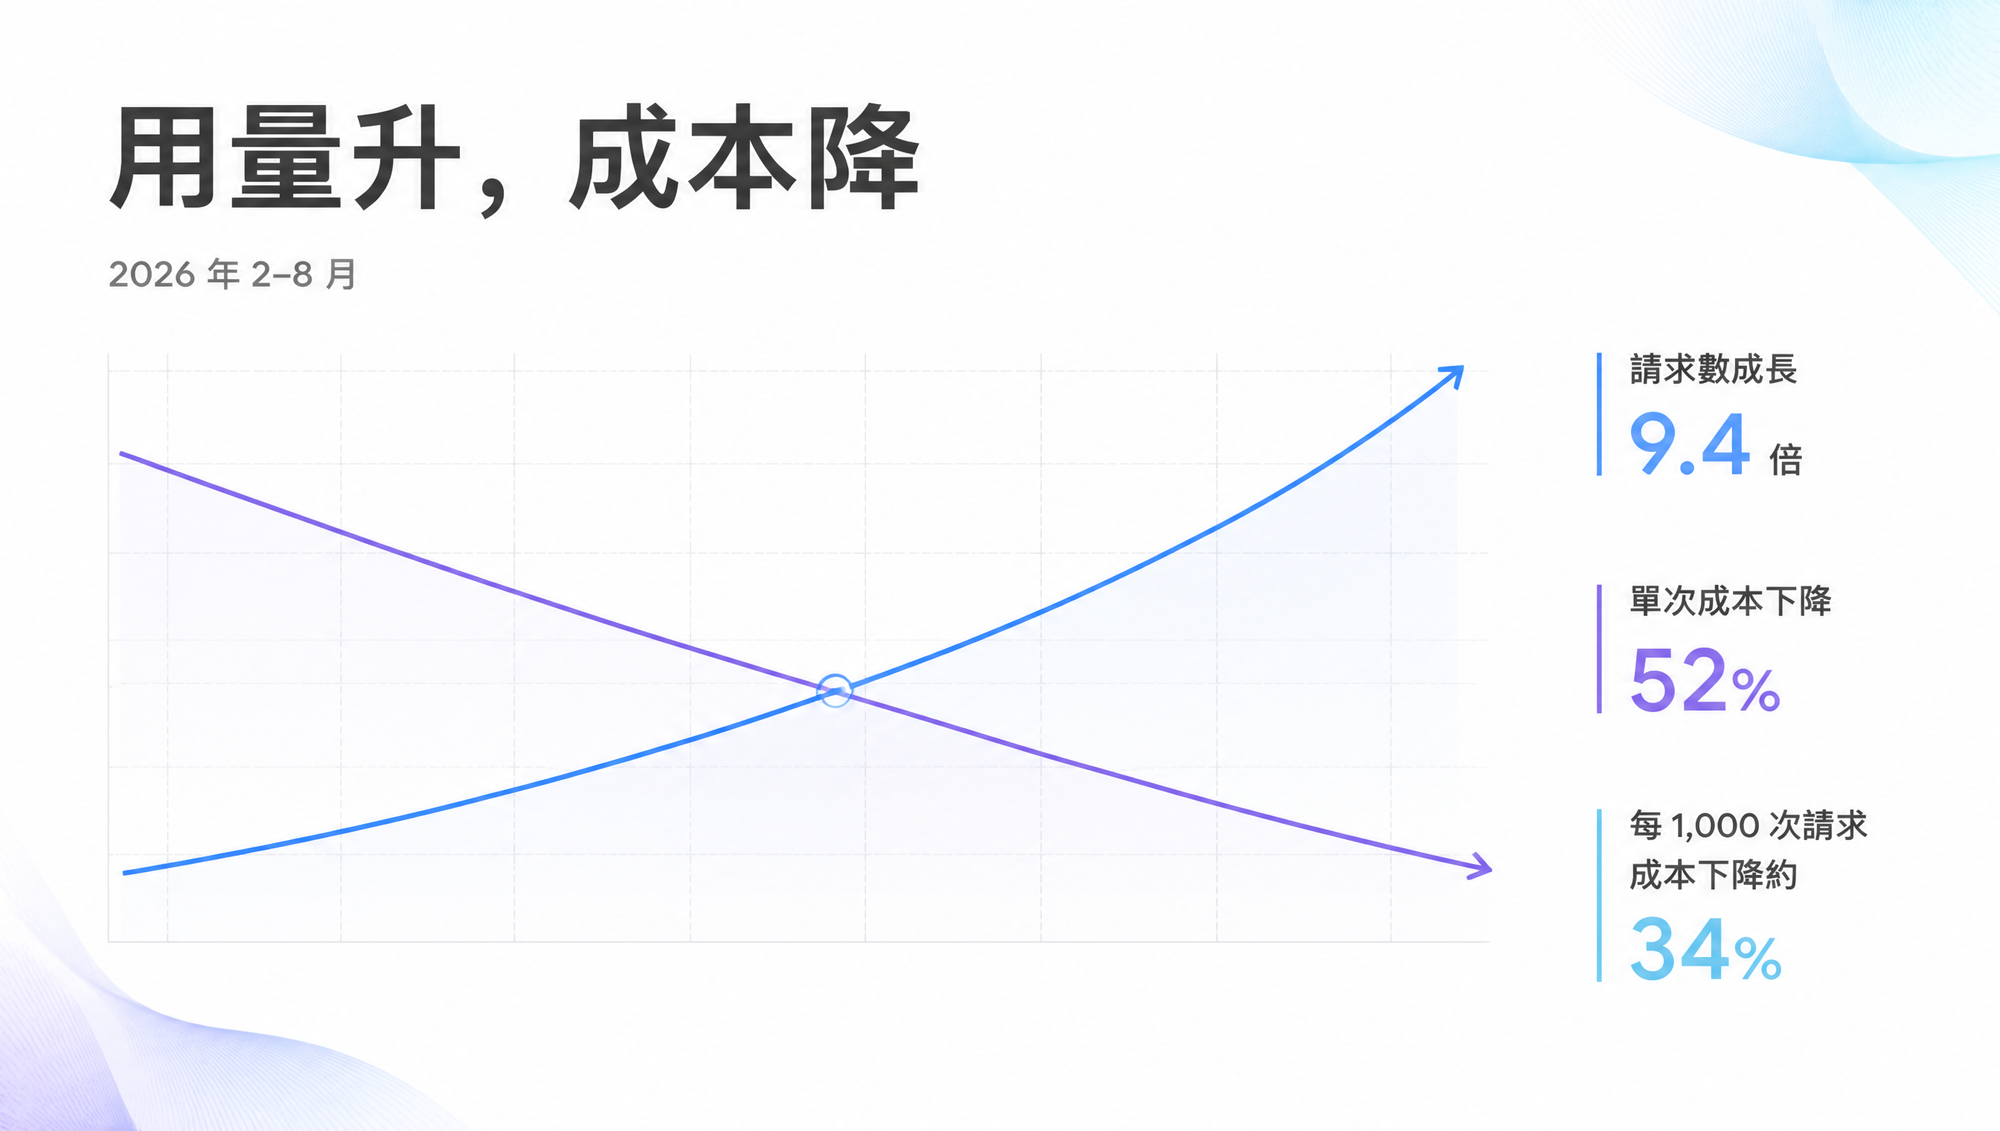
AI agent 成本在使用量暴增時仍能下降,但前提是把模型、上下文與工具呼叫當成一套生產系統來管理。 Uber 於 2026 年 8 月 27 日公布內部數據:2 月至 8 月,agent 每週請求數成長 9.4 倍;同一模型的每 1,000 次請求成本從高點下降約 34%,單次工作階段成本則比 6 月高點低 52%。
這組數字推翻了許多團隊習慣看的儀表板。只追 token 單價,會漏掉工作階段變長、工具定義膨脹、子 agent 數量增加,以及中間結果反覆進入上下文的成本。Uber 的做法比較接近一座軟體工廠:先寫出總成本方程式,再逐項找出能控制的變數。
使用率要配上單位經濟
Uber 表示,超過 70% 的 pull request 已歸因於本機或雲端 agent。公司內部有超過 3,600 項 agent skills,每天執行超過 30,000 次。從 2026 年 2 月到 8 月,agent 產品的每週活躍使用者成長 7 倍,每週請求數成長 9.4 倍;總 AI 支出卻從 4 月起大致穩定。
這些數字來自 Uber 自行公布的營運資料,無法當成跨公司的因果證明。它們仍指出一個工程管理問題:使用人數上升時,團隊不能再把模型帳單視為單一費率乘上 token 數量。
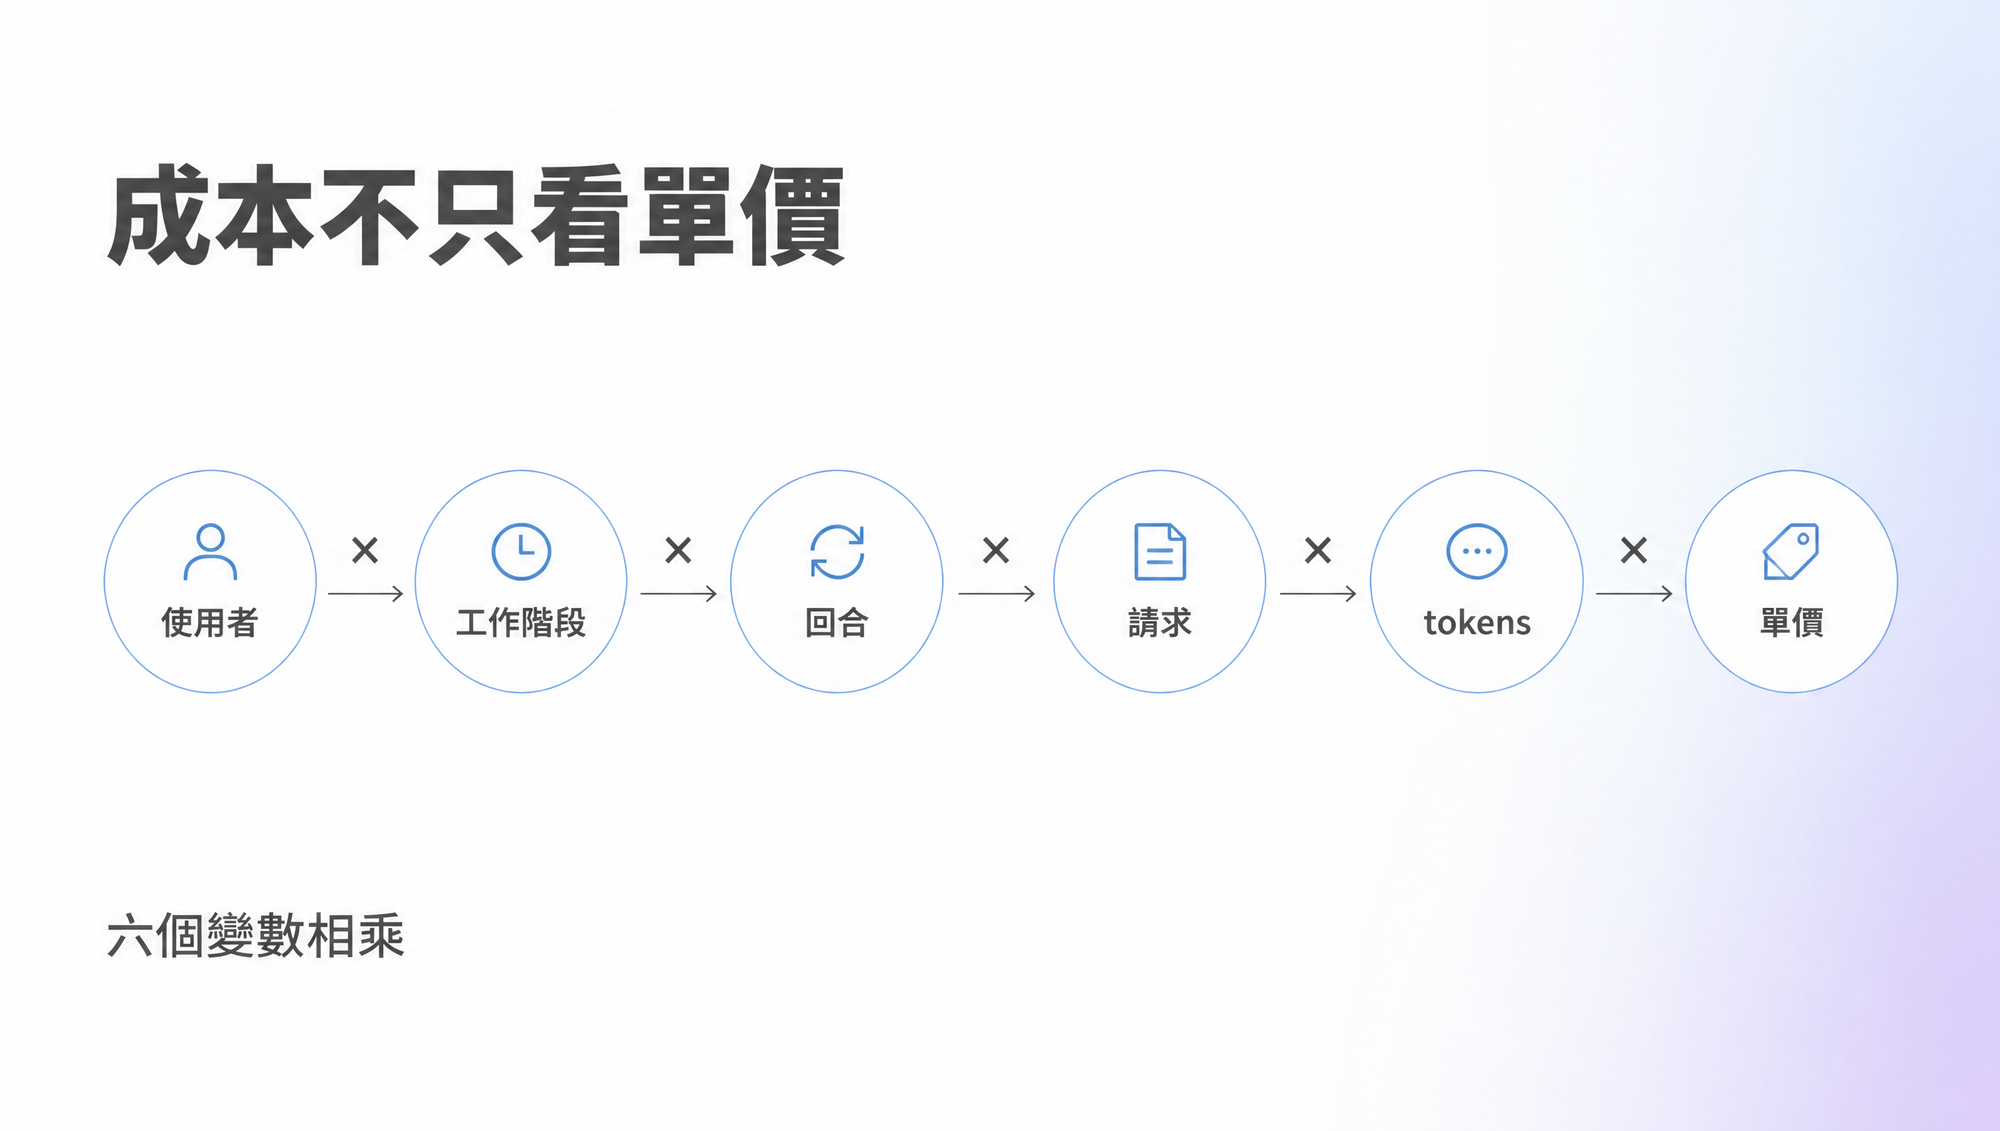
Uber 把總支出拆成以下乘積:
總支出 = 使用者數 × 每位使用者的工作階段數 × 每階段回合數 × 每回合請求數 × 每次請求 token 數 × 每 token 價格
模型價格只在最右側。前面五個乘數若同時上升,換一個便宜 20% 的模型也救不了帳單。模型維持不變時,團隊仍可減少無效回合、縮短提示詞、延後載入工具,並控制子 agent,壓低每次完成任務的成本。
2026 年的成本曲線怎麼轉彎
| 時間 | Uber 公布的變化 | 工程含義 |
|---|---|---|
| 2026 年 2 月至 8 月 | 每週活躍使用者成長 7 倍;每週 agent 請求成長 9.4 倍 | 採用率已進入規模化階段,總額預算不再夠用 |
| 2026 年 4 月起 | 總 AI 支出大致穩定 | 成本控制開始抵銷用量成長,但官方未揭露絕對支出 |
| 2026 年 6 月至 8 月 | 單次工作階段成本比 6 月高點下降 52% | 工作階段層級的設計比單看 token 單價更有用 |
| 2026 年 2 月至 7 月 | 固定同一模型後,每 1,000 次請求成本自高點下降約 34% | 提示詞、快取與上下文治理確實能改變單位成本 |
先用基準測試決定模型,再談路由
「所有 agent 都用最強模型」是最省管理時間的設定,也通常是最昂貴的設定。Uber 先建立任務專屬基準,再從品質與成本的 Pareto 前緣挑模型。
例如 uReview 會拿已知有缺陷的真實 pull request 測試程式碼審查 agent,並同時評估 precision、recall、F1、每次審查成本、延遲、逾時與雜訊。模型切換後,官方報告顯示 F1 提高,每個 pull request 的成本下降。Uber SWE Benchmark 則使用大型 monorepo 裡數千個真實 pull request,比較 frontier 與 open-weight 模型。
這套方法把路由從品牌偏好改成工作負載決策。主要 agent 可以留給拆解任務與驗收結果,子 agent 預設走成本較低的模型;只有基準顯示品質不足時才升級。OpenAI 在 2026 年的 GPT-5.6 建置指南也提出相近原則:縮小模型、調低推理強度與節制子 agent 數量,常能在維持成效時減少支出。
工具越多,agent 還沒工作就先付一筆上下文稅
Model Context Protocol(MCP)讓 agent 以統一介面呼叫外部工具。每項工具仍需要名稱、說明與輸入結構;若把所有 schema 預先塞進提示詞,工具目錄本身就會占用上下文。
Uber 的 1,000 多個 MCP server 若把超過 100 項常用工具全部預載,每個工作階段會多出約 50,000 至 70,000 個 prompt tokens。公司因此把工具搜尋與 CLI resolver 放在前面,只在任務需要時載入完整定義。Anthropic 公布的獨立測試也量到同一種成本:58 項工具在對話開始前約占 55,000 tokens;改成按需搜尋後,初始與相關工具的總用量約為 8,700 tokens。
工具結果也會膨脹。Uber 比較同一個 Claude Code 工作階段裡的自然語言工具呼叫與 code mode,讓查詢先在執行環境完成,再把必要輸出交給模型。
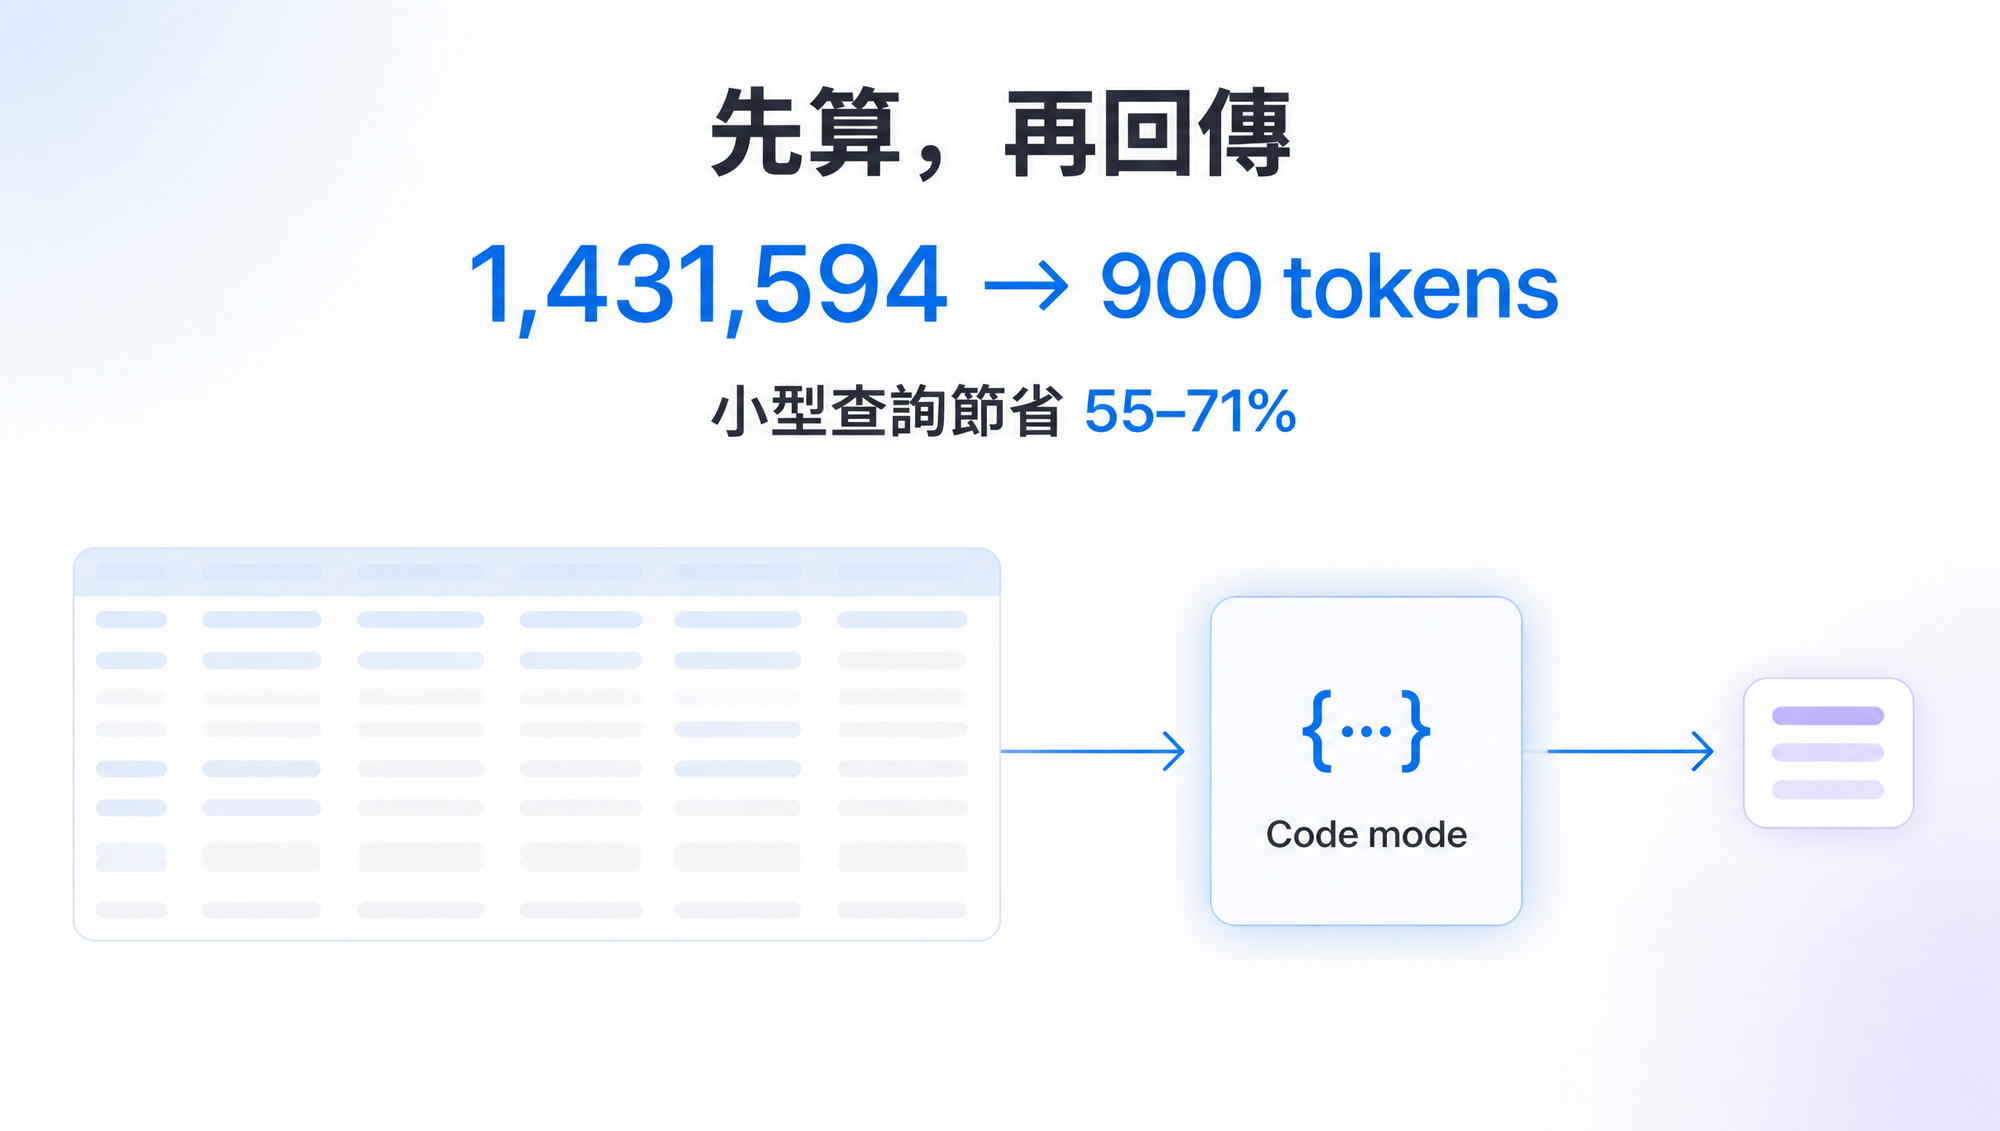
| SQL 工作量 | 一般工具呼叫 tokens | Code mode tokens | 節省幅度 |
|---|---|---|---|
SELECT 1(1 row) |
903 | 402 | 55% |
COUNT(*)(1 row) |
954 | 403 | 58% |
GROUP BY LIMIT 20(20 rows) |
1,600 | 457 | 71% |
SHOW COLUMNS(175 rows) |
2,200 | 900 | 59% |
SELECT * 寬表(50 rows) |
1,431,594 | 900 | 約 100% |
最後一列的差距很刺眼。當模型只需要一個判斷,讓 50 列寬表完整穿過上下文是資料搬運費,不是推理費。Anthropic 的 code execution with MCP 案例同樣把 150,000 tokens 降到 2,000,節省 98.7%;代價是團隊必須另外管理沙箱、資源限制與監控。
快取、壓縮與推理強度要一起設計
Uber 把主要工作階段的 prompt cache 設為 1 小時,短命子 agent 用 5 分鐘。官方列出的相對價格是:cache read 約為標準 input 的 0.1 倍,5 分鐘寫入約 1.25 倍,1 小時寫入約 2 倍。較長快取只有在共同前綴會被重用時才划算;提示詞前段頻繁改動,會讓寫入費白花。
長上下文也沒有免除治理。Uber 即使使用支援 100 萬 tokens 的模型,仍在 400,000 tokens 自動壓縮,並把預設推理強度設為 Medium。兩個設定的共同前提很直接:可用容量不等於合理用量。
OpenAI 的 GPT-5.6 指南指出,該系列的 prompt cache TTL 至少 30 分鐘,並支援決定性的 cache breakpoint。這讓快取從碰運氣變成架構選擇,但團隊仍要監控命中率與未命中成本。Uber 公開的一個 session dashboard 範例裡,總支出為 USD 4,162.07、共 433 個工作階段,快取命中率 95%;未命中成本仍有 USD 1,097.82,估算節省 USD 1,213.87。
一套可以先上線的治理順序
工程團隊不需要複製 Uber 的規模,才能採用這套方法。較合理的起點是先選一種高頻 agent 工作負載,例如 code review、測試修復或資料查詢,為它固定品質指標與成本分母。接著才調整模型路由、推理強度、子 agent 上限與快取。
接著把上下文拆帳。系統提示詞、工具 schema、檢索文件、中間結果與對話歷史要分開計量,否則 50,000 tokens 的工具目錄會藏在平均值裡。當工具超過約 10 項,或定義已占 10,000 tokens 以上,可測試按需搜尋;大型結果集則先在程式執行環境篩選與彙總。
預算告警放在後面。Uber 在支出達個人預算 50%、80% 與 100% 時提示使用者,另用 session 分析儀表板偵測 16 種反模式。告警只會讓問題現形,真正能改變曲線的仍是 benchmark、路由與上下文設計。
常見問題
AI agent 成本應該用什麼單位衡量?
優先使用每個完成任務或每個通過品質門檻的工作階段成本。每百萬 tokens 價格適合採購比較,卻無法反映回合數、工具呼叫與失敗重試。品質指標與成本必須綁在同一個 benchmark 上。
何時該把 MCP 工具改成按需載入?
工具定義超過約 10,000 tokens、可用工具超過 10 項,或 agent 常選錯相似工具時,就值得測試。按需載入會多一次搜尋延遲,因此工具很少、任務很短時未必划算。
子 agent 一定要用較便宜的模型嗎?
預設可以,但要由任務基準決定。主要 agent 負責拆解與驗收,子 agent 執行邊界清楚的工作時,較小模型通常有較好的成本結構;需要複雜判斷的子任務仍應升級。
長上下文模型還需要自動壓縮嗎?
需要。長上下文提高容量,沒有消除延遲、費用與注意力稀釋。Uber 在 100 萬 tokens 容量下仍選擇 400,000 tokens 自動壓縮,這是可操作的上限範例,不是所有團隊的通用答案。
權威來源
- Uber Engineering — Running a Software Factory Efficiently at Uber Scale
- OpenAI — The builder’s guide to GPT-5.6
- Anthropic — Introducing advanced tool use on the Claude Developer Platform
- Anthropic — Code execution with MCP: building more efficient AI agents
- Model Context Protocol — Schema Reference
Author Insight
我會把 Uber 這份報告當成 agent 團隊的損益表範本,而不是一張模型採購清單。最有用的動作,是為每種工作負載建立品質門檻,再追蹤每次通過門檻要花多少錢。模型名稱會換;成本方程式裡那些會相乘的變數,才是長期要管的東西。