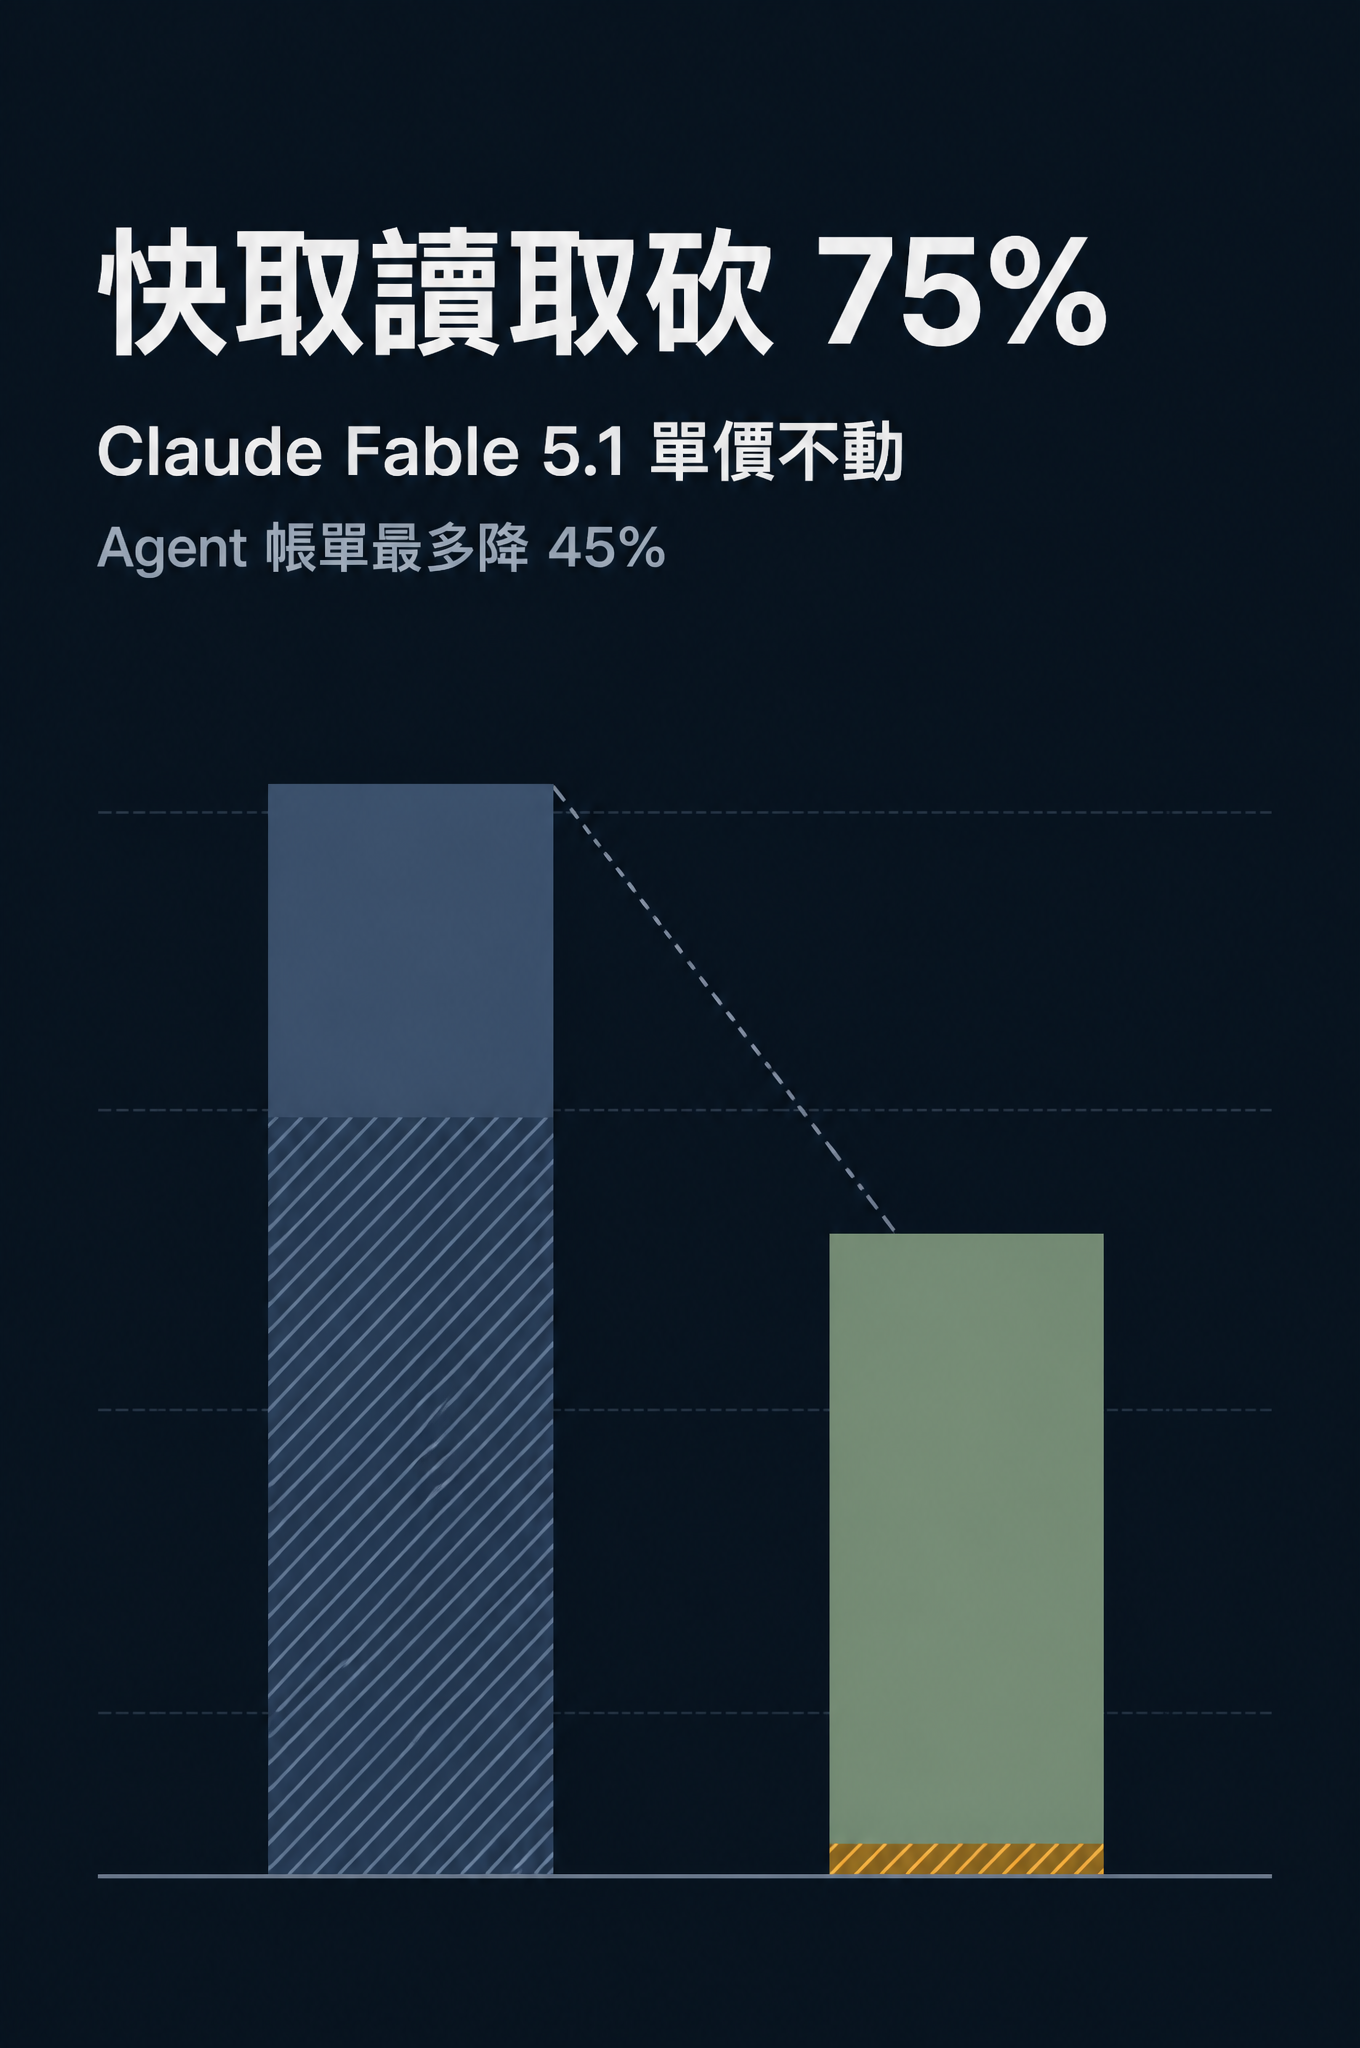
Claude Fable 5.1 在 2026 年 9 月 1 日發表,輸入與輸出單價完全沒動,維持每百萬 token 10 美元和 50 美元,真正調降的是快取讀取:從 1 美元砍到 0.25 美元,降幅 75%。 Anthropic 用八月四週的實際用量重算過帳單:一般工作負載的總成本大約降 25%,重度 agent 工作負載最多降 45%。同一天發表的還有 Claude Mythos 5.1,兩者是同一個模型,差別只在安全護欄的鬆緊。
過去三個月,市場對 Fable 系列的抱怨集中在「太貴」,而 Anthropic 的回應繞過了大家看得懂的那個數字,改去動一行多數人結帳時根本沒注意的費用。
降價降在帳單裡最不起眼的那一行
快取讀取指的是模型重新讀取先前已經處理並存起來的內容。這筆費用通常按輸入單價的 0.1 倍計算。Fable 5.1 和 Mythos 5.1 被單獨拉出來,改成 0.025 倍,也就是每百萬 token 0.25 美元。翻開 Claude Platform 的定價表會發現,整個 Claude 家族只有這兩個型號套用新倍率。Opus 5 仍然是 0.5 美元,Sonnet 5 是 0.2 美元,都維持 0.1 倍。
Anthropic 自己公布的成本結構圖,說明了為什麼這一行這麼關鍵。在一般工作負載裡,快取讀取大約佔 Fable 5 總成本的四成;到了重度 agent 工作負載,這個比例逼近三分之二。Agent 的運作方式決定了這個結果。長任務會反覆帶著同一份系統提示、同一份程式碼庫脈絡、同一批工具定義來回讀取;真正產生新內容的輸出 token 反而佔比不高。
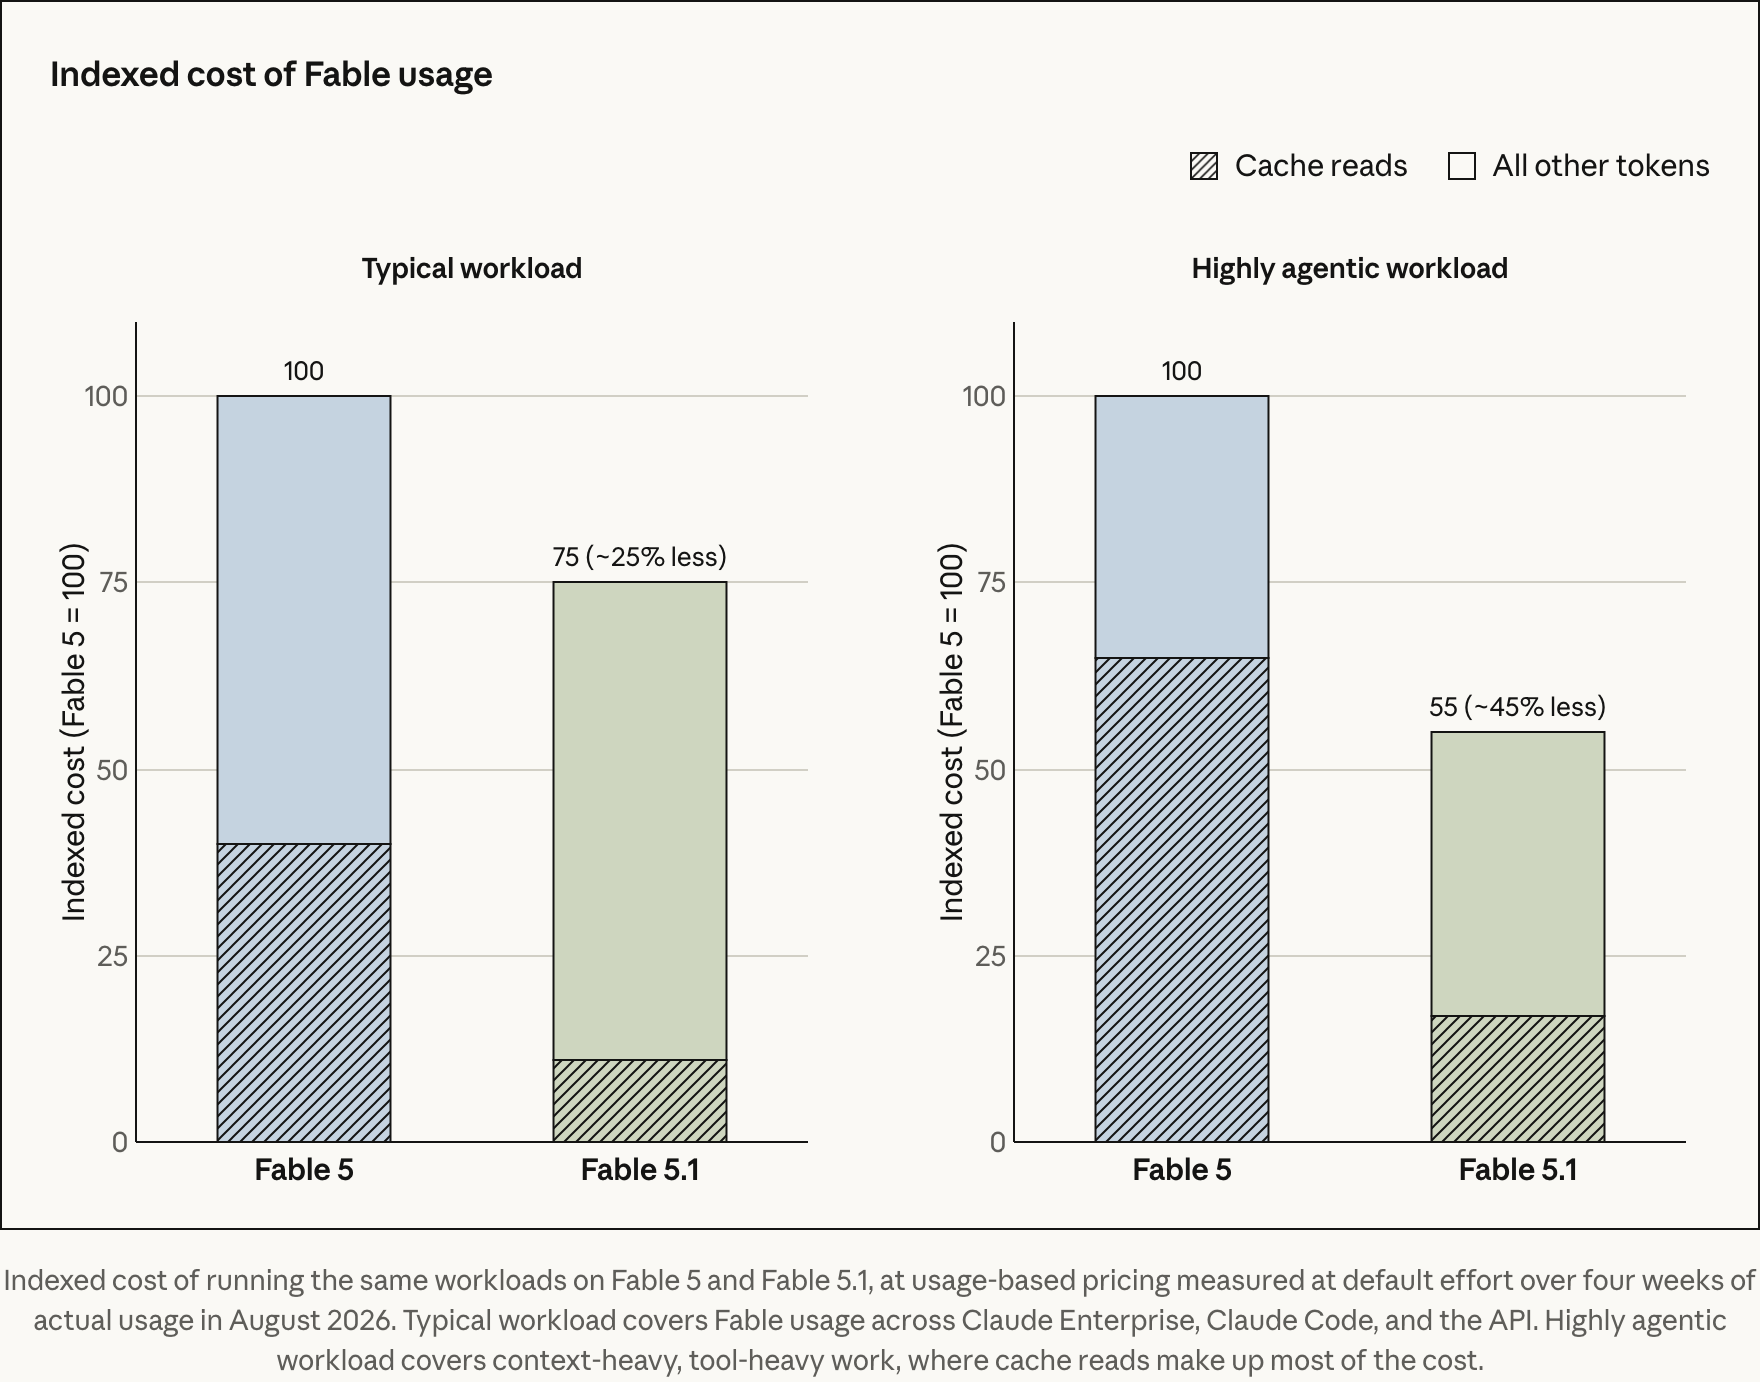
所以帳面上「單價沒降」和實務上「帳單少四成五」可以同時成立。Anthropic 在說明裡把量測條件寫得很清楚:預設 effort 檔位、2026 年 8 月連續四週的真實用量,一般工作負載涵蓋 Claude Enterprise、Claude Code 與 API,重度 agent 工作負載指的是脈絡重、工具呼叫重的情境。
| 費用項目 | Claude Fable 5 | Claude Fable 5.1 | Claude Opus 5 |
|---|---|---|---|
| 輸入 | 10 美元 / 百萬 token | 10 美元 / 百萬 token | 5 美元 / 百萬 token |
| 輸出 | 50 美元 / 百萬 token | 50 美元 / 百萬 token | 25 美元 / 百萬 token |
| 快取寫入(5 分鐘) | 12.5 美元 | 12.5 美元 | 6.25 美元 |
| 快取讀取 | 1 美元 | 0.25 美元 | 0.5 美元 |
| 快取讀取倍率 | 0.1× | 0.025× | 0.1× |
這代表評估模型成本的方法變了。過去比較兩個模型,看輸入輸出單價大致就能排序。現在要先知道自己的工作負載裡快取讀取佔多少,才知道哪個型號實際比較便宜。Fable 5.1 的輸入單價仍然是 Opus 5 的兩倍。可是在快取佔比高的 agent 情境下,兩者的實際差距會被壓到跟帳面數字完全不同。
Fable 5 只拿到 Anthropic 企業支出的一成一
Anthropic 為什麼非改不可,八月的一份資料講得很清楚。
支付平台 Ramp 的經濟研究團隊在 2026 年 8 月 12 日發布的 AI Index 裡,用自家平台的企業支出資料統計了七月的模型使用結構。結果是:Fable 5 只佔企業向 Anthropic 購買 token 的 6%,佔向 Anthropic 支付金額的 11.4%。同一份報告還指出,Fable 5 七月的模型相關支出,大約只有 GPT-5.6 Sol 的 75%。Ramp 首席經濟學家 Ara Kharazian 在報告裡寫下一句很直接的結論:企業願意為 AI 花多少錢,Fable 5 幫大家找到了新的上限。
這句話的份量在於它描述的是已經發生的採購行為,而非市場預測。Fable 5 在 2026 年 6 月 9 日首發,三天後就因為美國政府對 Fable 5 與 Mythos 5 實施出口管制而全面停止服務。管制在 6 月 30 日解除,7 月 1 日才真正對全球開放。Ramp 統計的正是它全面開放後的第一個完整月份。價格是 Opus 4.8 與 Opus 5 的兩倍,企業把預算留給了比較便宜的型號。
Anthropic 在 Fable 5.1 的發表說明裡承認得很坦白,寫的是這次改版針對客戶在價格、資料留存與安全護欄三方面的回饋。三件事都與模型能力無關,全是採購障礙。
效能:科研基準翻倍,但要先看 effort 檔位
能力面的進展是實在的,最大的一塊在科研。
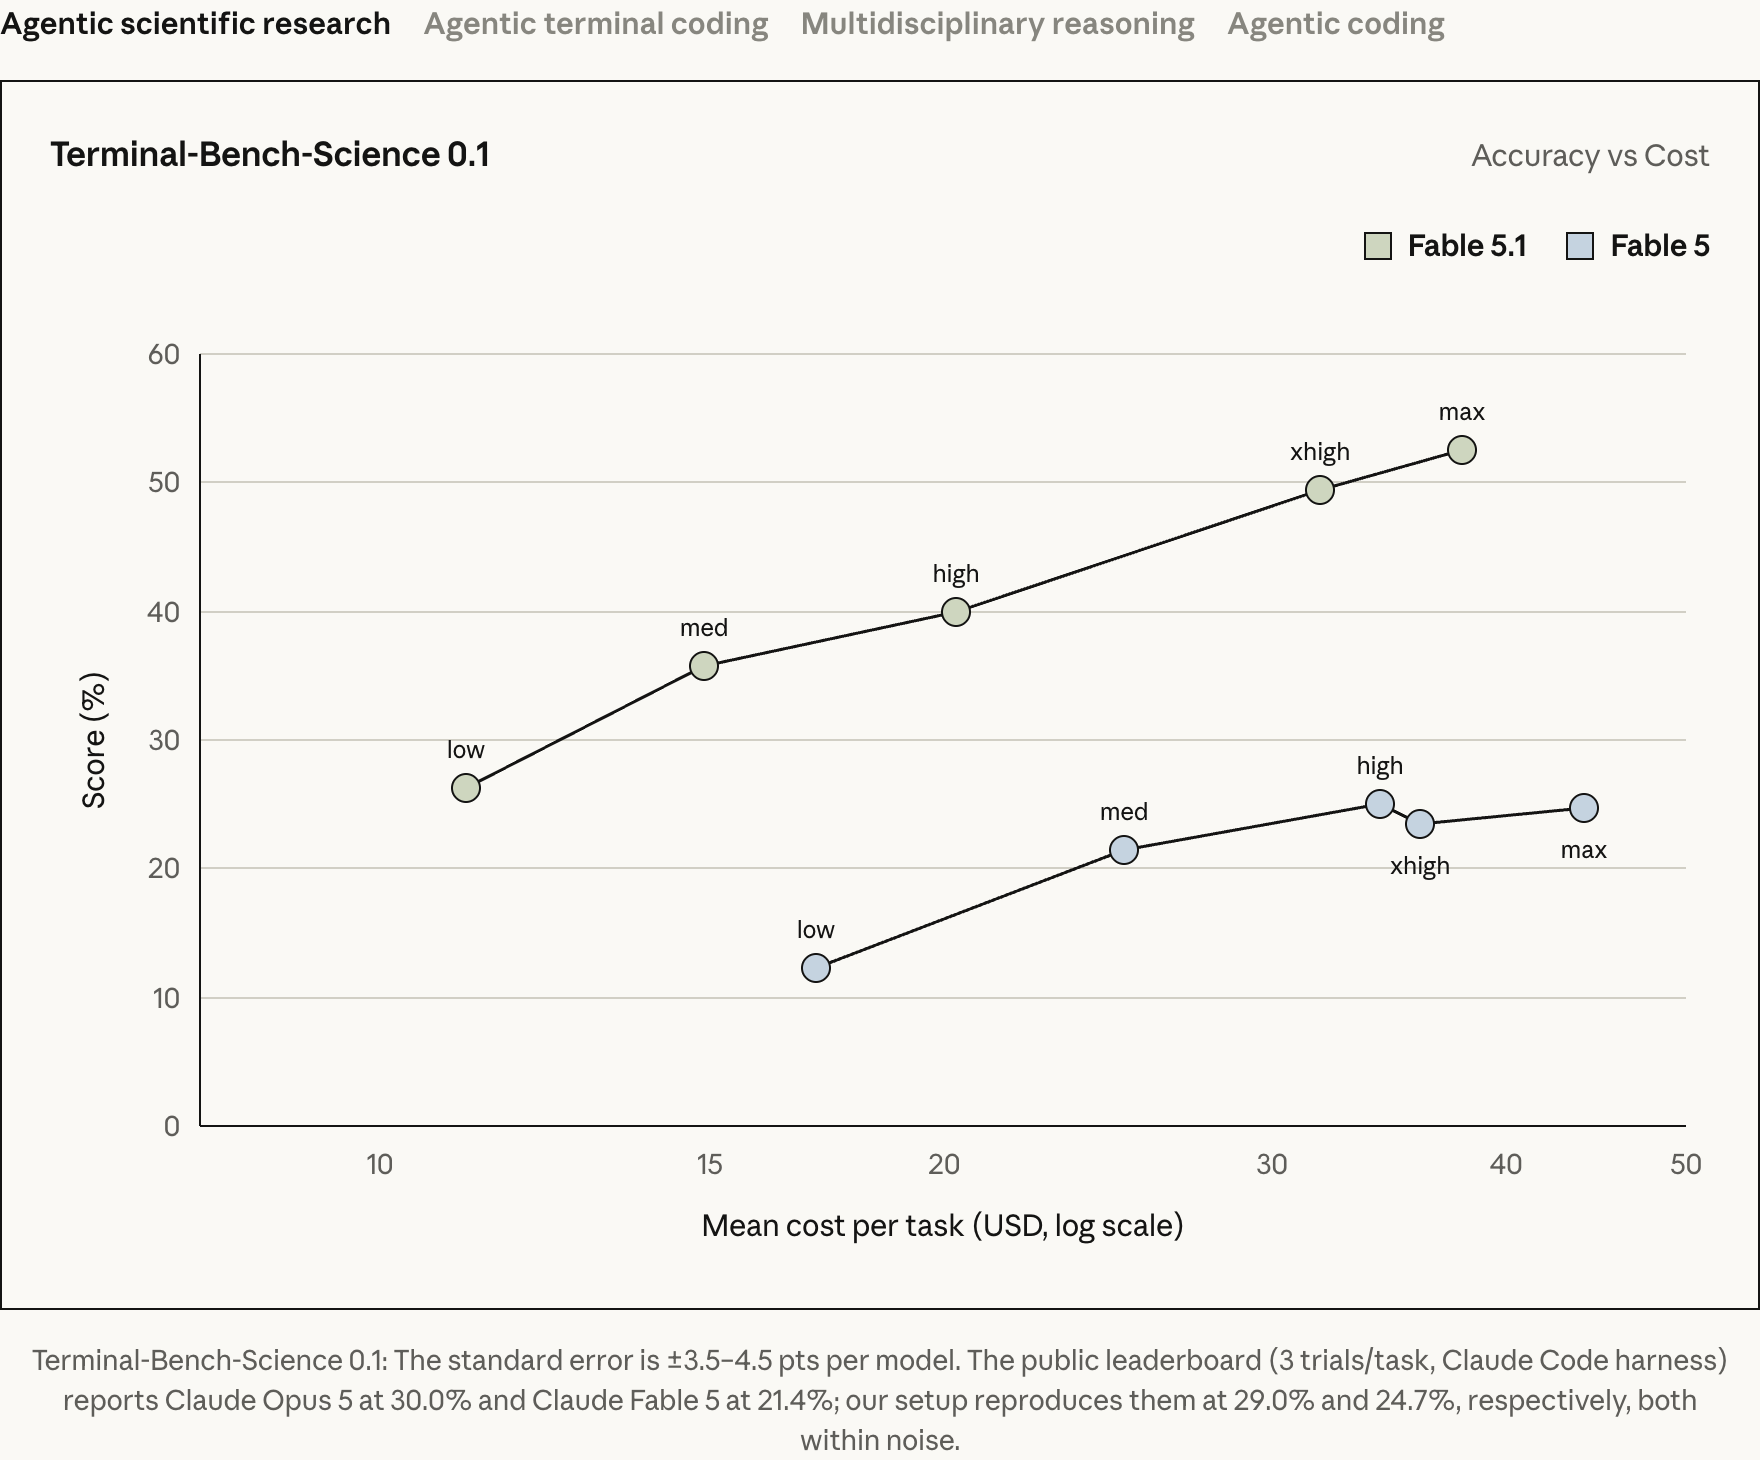
Terminal-Bench-Science 0.1 這個衡量 AI 自主執行科研任務的基準,Fable 5.1 拿到 52.6%,Fable 5 是 24.7%,Opus 5 是 29.0%,GPT-5.6 Sol 是 22.4%。Anthropic 同時在註腳裡揭露,這個基準的標準誤差是每個模型 ±3.5 到 4.5 個百分點。公開排行榜用三次試驗的設定量到 Opus 5 是 30.0%、Fable 5 是 21.4%,跟自家設定的結果在雜訊範圍內一致。願意主動附上誤差區間與對照組,這種揭露方式在模型發表稿裡並不常見。
| 評測項目 | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1(自主科研) | 52.6% | 24.7% | 29.0% | 22.4% |
| Terminal-Bench 4.0(終端程式任務) | 55.8%(Mythos 5.1 為 60.9%) | 42.0% | 52.3% | 37.3% |
| GDPval-AA v2(知識工作) | 1853 | 1723 | 1824 | 1711 |
| AutomationBench(商業流程自動化) | 31.4% | 17.1% | 26.9% | 19.6% |
| CursorBench 3.2.0(程式任務) | 73.4% | 70.5% | 70.0% | 67.2% |
| Humanity's Last Exam(無工具) | 60.9% | 57.8% | 56.6% | — |
| OSWorld 2.0(電腦操作,strict) | 41.7% | 36.1% | 39.6% | — |
獨立機構的排名也對得上。Artificial Analysis 的 Intelligence Index 綜合九項評測,Claude Fable 5.1 在 max 檔位加預設 fallback 的設定下拿到 66 分,排在第一;Claude Opus 5 的 max 檔位是 63 分,Claude Fable 5 是 62 分,GPT-5.6 Sol 的 max 檔位是 61 分。前三名都是 Anthropic 的型號。
排名以外,effort 檔位對實際使用者更有用。Fable 5.1 提供 low、med、high、xhigh、max 五個檔位,在 Claude Code 裡預設 high,在 Claude Cowork 和 Claude.ai 裡預設 medium。Anthropic 的說法是,調到 low 或 med 時,Fable 5.1 的結果已經跟 Fable 5 相當甚至更好,而成本低很多。對照官方的準確度對成本曲線,Fable 5.1 的 low 檔在 Terminal-Bench-Science 上的分數,就已經追平 Fable 5 開到 max 的表現,每項任務的平均成本卻只有大約四分之一。
Fable 5.1 的評測是在正式環境護欄開啟的狀態下跑的。Anthropic 說明,護欄介入的任務在 OSWorld 2.0 上直接記零分,Fable 5 在 AutomationBench 上也有同樣情況,這很可能壓低了兩個型號的分數。所以表格裡的數字偏保守。
跑分看不到的部分,由早期測試的客戶補上。投資公司 Millennium 的資深投資組合經理 Damien 描述了一個案例。他們一段程式碼有個大約百萬分之一發生率的當機,四到五年沒人解釋得出來,包含 Fable 5 在內的模型都沒找到。Fable 5.1 反組譯了外部廠商的函式庫,比對核心傾印檔,把問題追到那個函式庫的錯誤。Jane Street Capital 的量化研究主管 Craig Falls 給的評價是,Fable 5.1 解掉的程式問題比 Fable 5 或 Opus 5 都多,而且在長串多步驟任務裡維持可讀性,不像先前的模型愈跑愈難跟。
Cognition 共同創辦人暨產品長 Walden Yan 的說法最直接連回定價:他們發表當天就把 Devin 裡的 Opus 5 流量轉到 Fable 5.1,理由是測試成績追平或略勝 Fable 5、每項任務成本更低,而有了新的快取讀取價格,Fable 等級的模型對那些原本留在 Opus 上的工作負載終於划算了。
資料留存:30 天沒有取消,只是搬到你自己的雲
第三個採購障礙比價格更棘手。
Fable 5 發表時,Anthropic 要求所有 Mythos 等級模型的使用資料保留 30 天,用來運行需要跨請求視野的安全分類器。對原本享有零資料留存協議的企業,尤其是金融、醫療、政府這類受規範產業,這等於隱私保障一夜之間降了一級。Anthropic 在內部報告裡也承認過,這項政策會不受客戶歡迎,而且對業務有實際風險。
OpenAI 在 8 月 20 日抓住了這個缺口,公布 Private Safety Processing,主張即使使用最強的模型也能維持零資料留存。Bloomberg 同一天報導 Anthropic 正在開發對應的系統。
Anthropic 的答案叫 Enterprise Frontier Safeguards(EFS,企業級前沿安全防護)。核心設計是把資料存在客戶自己控制的雲端基礎架構上,而非 Anthropic 的系統。可以放在 Amazon S3、Azure Blob Storage 或 Google Cloud Storage,用客戶自己管理的加密金鑰與存取政策。安全監控由自動化系統執行,預設不需要 Anthropic 人工審查。被標記的內容要由誰查看,客戶自己決定。
30 天的保留期本身並沒有取消,改變的是保管人。這個區別對法遵團隊很重要:資料主權回到客戶手上,稽核軌跡也在客戶自己的雲帳戶裡。
EFS 是與超過 100 家客戶共同開發的,橫跨金融服務、醫療、製造、電信、法律、零售與公部門。支援範圍包含 Claude Code、Claude Enterprise、Claude Platform、Amazon Bedrock、Claude Platform on AWS、Google Agent Platform 與 Microsoft Foundry。Anthropic 不另外收費,今年秋天開始分階段上線。在 EFS 正式可用之前,符合資格的客戶可以用零資料留存的方式使用 Fable 5 和 Fable 5.1。
科研成果:金星地形圖與蛋白質結合物
這次發表花了不小篇幅展示科研能力,而且兩個主要案例都有外部可驗證的產出。
Fable 5.1 用 NASA 麥哲倫任務三十多年前拍攝的雷達影像訓練神經網路,為金星三分之一的表面產生新的高解析度地形圖。原有地形資料只涵蓋五分之一的表面,解析度落在 10 到 20 公里;新地圖能分辨到 2 到 3 公里的細節,高度精度最多提升 25%。Anthropic 以創用 CC 授權公開發布這份地圖,時間點刻意選在 NASA 的 VERITAS 與 ESA 的 EnVision 任務之前,希望協助這兩個任務挑選觀測目標。
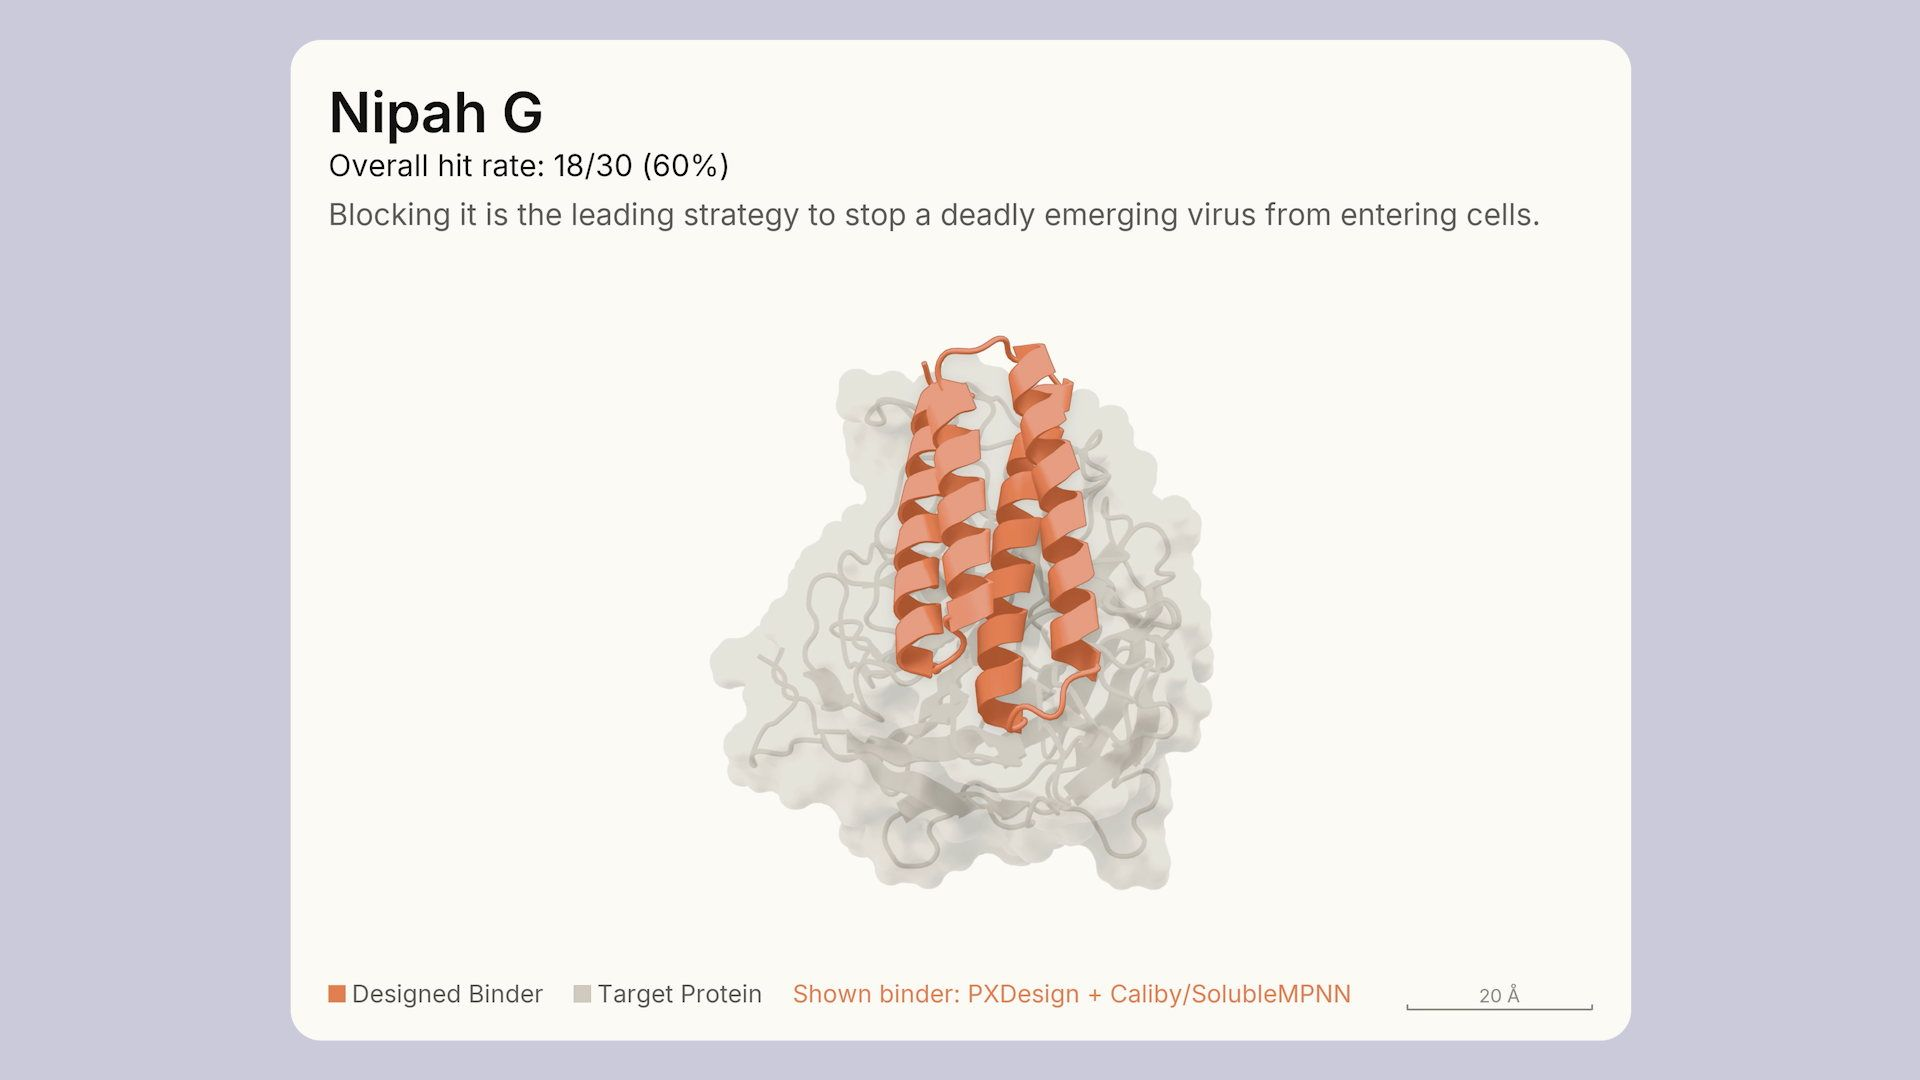
生物方向由 Mythos 5.1 負責。研究團隊給模型接上開源的蛋白質設計與摺疊工具,再把設計結果送到兩家外部機構做實驗驗證。在 EGFR、Nipah G 與 15-PGDH 三個標靶上,模型設計出的結合物親和力比 Adaptyv Bio 蛋白質設計競賽的最佳投稿高出十倍;跨 12 個標靶的命中率接近 50%,而這個領域目前的一般水準是 10% 到 15%。
第三個案例對做機器學習基礎建設的人可能最實用。Mythos 5.1 為七個開源深度學習模型撰寫自訂 GPU 核心並快取中間結果,在 NVIDIA H100 上把推論速度提升 1.4 到 2.5 倍,輸出結果完全一致。換算到全基因組分析,GPU 成本下降 30% 到 60%:Enformer 從三萬美元降到兩萬一千美元,Flashzoi 從一萬四千美元降到七千美元,Evo 2 的 400 億參數版本從一萬八千美元降到八千美元。Anthropic 的說法是,這種最佳化通常要一組效能工程師花好幾週,學術實驗室往往負擔不起,而模型只用公開原始碼幾天就完成。
這些展示當然服務 Anthropic 自己的敘事,但蛋白質設計經過外部實驗驗證、金星地圖可以公開下載,兩者都留下了可以被檢驗的痕跡。
護欄放寬、反蒸餾收緊、輸出加了浮水印
安全面的三項變動,實際影響方向各不相同。
護欄變精準了。生物安全護欄對基礎生物與醫學類的良性提問,誤觸發次數比 Fable 5 剛上線時少了 85%。網路安全護欄的改動對開發者更有感:Anthropic 預期 Claude Code 使用者平均每個工作階段被安全機制打斷的次數,會比 Fable 5 時期減少約 60%。Fable 5.1 現在也開放用來辨識軟體漏洞,也就是防禦性的安全工作,但不能開發漏洞利用程式。滲透測試、漏洞利用生成與二進位漏洞掃描這幾類雙用途任務,仍然會被導向 Opus 系列。
反蒸餾則是收緊。從 9 月 1 日起新註冊的 API 帳號,不能再在多輪對話中手動編輯 Claude 先前的脈絡、同時保留先前的思考紀錄。這封掉了一個公開流傳的蒸餾技巧。既有帳號目前不受影響,但 Anthropic 明說未來的模型發表會套用到所有使用者,少數客戶的自訂整合屆時需要調整。
輸出還多了一層看不見的東西。Anthropic 在 2026 年 7 月與另外 190 個簽署方一起簽了歐盟 AI 法案的 AI 生成內容透明度行為準則。因此 8 月 2 日之後發表的模型,輸出文字都內嵌浮水印。這個浮水印是一個機率性的數值指標,沒有偵測 API 的人看不見,也不含使用者、組織或對話的任何資訊。偵測 API 目前是私人預覽,開放對象是法律要求的機構,例如監管單位、執法機關、媒體、事實查核組織、研究者、教育機構與歐盟公民社會團體。
換不換:三種團隊的判斷依據
收斂成可以執行的判斷,大致是三種情況。
原本就在跑 Fable 5 的團隊:直接換,這是這次改版裡最沒有懸念的一組。同一個價格結構下能力全面提升,快取讀取還便宜了四分之三。API 識別碼是 claude-fable-5-1,在 Claude API、AWS、Google Cloud 與 Microsoft Azure 上同步可用。順手檢查一下 effort 設定,Claude Code 預設是 high,但很多任務跑 med 就夠了。
因為價格而留在 Opus 5 的團隊:先算快取佔比再決定。如果你的工作負載是長脈絡、多工具呼叫的 agent 流程,快取讀取很可能佔掉大半成本,這時 Fable 5.1 的實際帳單可能比帳面單價暗示的接近得多。Cognition 的做法可以當參考:他們從程式碼審查這類工作開始移轉,而不是一次全搬。反過來說,如果你的用量以短提示、單次呼叫為主,快取根本沒發揮空間,Opus 5 的 5 美元輸入單價仍然實在。
因為資料留存而卡住的團隊:可以重新談了,但要問清楚時程。EFS 要到今年秋天才分階段上線,在那之前符合資格的客戶能以零資料留存的方式使用 Fable 5.1。這是過渡安排,採購合約裡值得把兩個階段分開寫。
至於 Mythos 5.1,多數人暫時用不到。它目前只開放給少數美國組織,透過 Cyber Verification Program 與 Life Sciences Verification Program 申請,後者是與美國政府合作建立的。Anthropic 說正在協調擴大範圍。另外,Anthropic 的程式碼漏洞掃描產品 Claude Security 現在也改由 Mythos 5.1 驅動。
常見問題
Claude Fable 5.1 的價格到底降了多少?
輸入與輸出單價完全沒變,仍然是每百萬 token 10 美元與 50 美元。降的是快取讀取,從每百萬 token 1 美元降到 0.25 美元。Anthropic 依據 2026 年 8 月四週的實際用量估算,一般工作負載總成本降約 25%,重度 agent 工作負載最多降約 45%。
Claude Fable 5.1 和 Claude Mythos 5.1 差在哪裡?
兩者是同一個底層模型,差別在安全護欄的鬆緊。Fable 5.1 對所有人開放;Mythos 5.1 的護欄較寬鬆,只提供給通過審核的網路安全與生命科學工作者,目前僅限少數美國組織,需經 Cyber Verification Program 或 Life Sciences Verification Program 申請。
effort 檔位該怎麼選?
Fable 5.1 有 low、med、high、xhigh、max 五檔,Claude Code 預設 high,Claude Cowork 與 Claude.ai 預設 medium。Anthropic 表示 low 與 med 檔的結果已經與 Fable 5 相當或更好,成本卻低很多。除非任務明確需要更長的推理,否則從低檔往上調比一開始就開到 max 划算。
Enterprise Frontier Safeguards 與零資料留存的差別在哪裡?
隱私效果等同零資料留存,但機制不同。30 天保留期沒有取消,改成資料存放在客戶自己控制的雲端儲存空間,使用客戶管理的金鑰;自動化系統負責安全監控,預設不需要 Anthropic 人工審查。EFS 今年秋天起分階段上線,Anthropic 不另外收費。
現有 API 整合會受反蒸餾機制影響嗎?
目前不會。這項限制只套用在 2026 年 9 月 1 日起新註冊的 API 帳號,內容是不能在多輪對話中手動編輯 Claude 先前脈絡並同時保留思考紀錄。Anthropic 已預告未來的模型發表會擴及所有使用者,屆時少數自訂整合需要調整。
權威引用
- Anthropic — Introducing Claude Fable 5.1 and Claude Mythos 5.1
- Anthropic — Developing Enterprise Frontier Safeguards with our customers
- Claude Platform Docs — Pricing
- Ramp Economics Lab — August 2026 Ramp AI Index: Cracks in the AI thesis
- Artificial Analysis — Model Leaderboard
- OpenAI — Offering Zero Data Retention for frontier models
- Bloomberg — Anthropic Plans to Change Data Retention Policy for Advanced AI
Author Insight
我在維運內容與 agent 工作流的過程裡,最常看到的成本誤判就是拿輸入輸出單價直接比模型。實際跑起來,長任務的帳單結構跟直覺差很多:系統提示、程式碼庫脈絡、工具定義會被反覆讀取,這些重複讀取的費用經常比新生成的內容還貴。Anthropic 這次把快取讀取倍率單獨拉到 0.025,等於承認 agent 工作負載的計費模型跟聊天工作負載已經不是同一回事。
我對這次發表的保留在另一個地方。Fable 5.1 的價格改動確實有誠意,但它同時也是一次回應:Ramp 的資料顯示企業用行動投票,把預算給了比較便宜的型號。能力領先與商業可行之間的落差,過去三個月是實實在在存在的。降價之後這個落差會不會消失,要看接下來兩個月企業的實際採購行為,而非發表當天的跑分。
effort 檔位還帶來一項新工作。以前選模型,選完就結束了;現在還要替不同任務挑檔位,而且這個選擇直接反映在帳單上。這件事目前多半靠工程師憑感覺調,我自己也還沒找到夠好的量測方式。
Tenten 自己的雙語內容管線與 agent 工作流就跑在 Claude Code 上,effort 檔位設定與快取策略如何影響每月帳單,是我們每天都在調整的東西。如果你正在評估要不要把既有的 AI 工作流換到 Fable 5.1,或想弄清楚自己的快取讀取佔比,歡迎跟 Tenten 團隊聊聊。
術語表
| 術語 | 說明 |
|---|---|
| 快取讀取(cache read) | 模型重新讀取先前已處理並儲存的輸入內容所產生的費用,通常按輸入單價的固定倍率計算 |
| effort 檔位 | Claude Fable 5.1 提供的五段推理力度設定:low、med、high、xhigh、max |
| Enterprise Frontier Safeguards(EFS) | Anthropic 的企業級前沿安全防護,資料存放在客戶自控的雲端儲存空間,由自動化系統執行安全監控 |
| 零資料留存(zero data retention, ZDR) | 服務供應商不保留客戶提示與模型輸出的協議條件 |
| 蒸餾(distillation) | 用強模型的輸出訓練另一個模型,藉此轉移能力的方法 |
| Terminal-Bench-Science | 衡量 AI 在終端環境中自主執行科學研究任務能力的評測基準 |
| GDPval-AA | 衡量模型處理知識工作任務表現的評測,以分數而非百分比呈現 |
| Adaptyv Bio | 舉辦公開蛋白質設計競賽並提供實驗驗證服務的生技機構 |