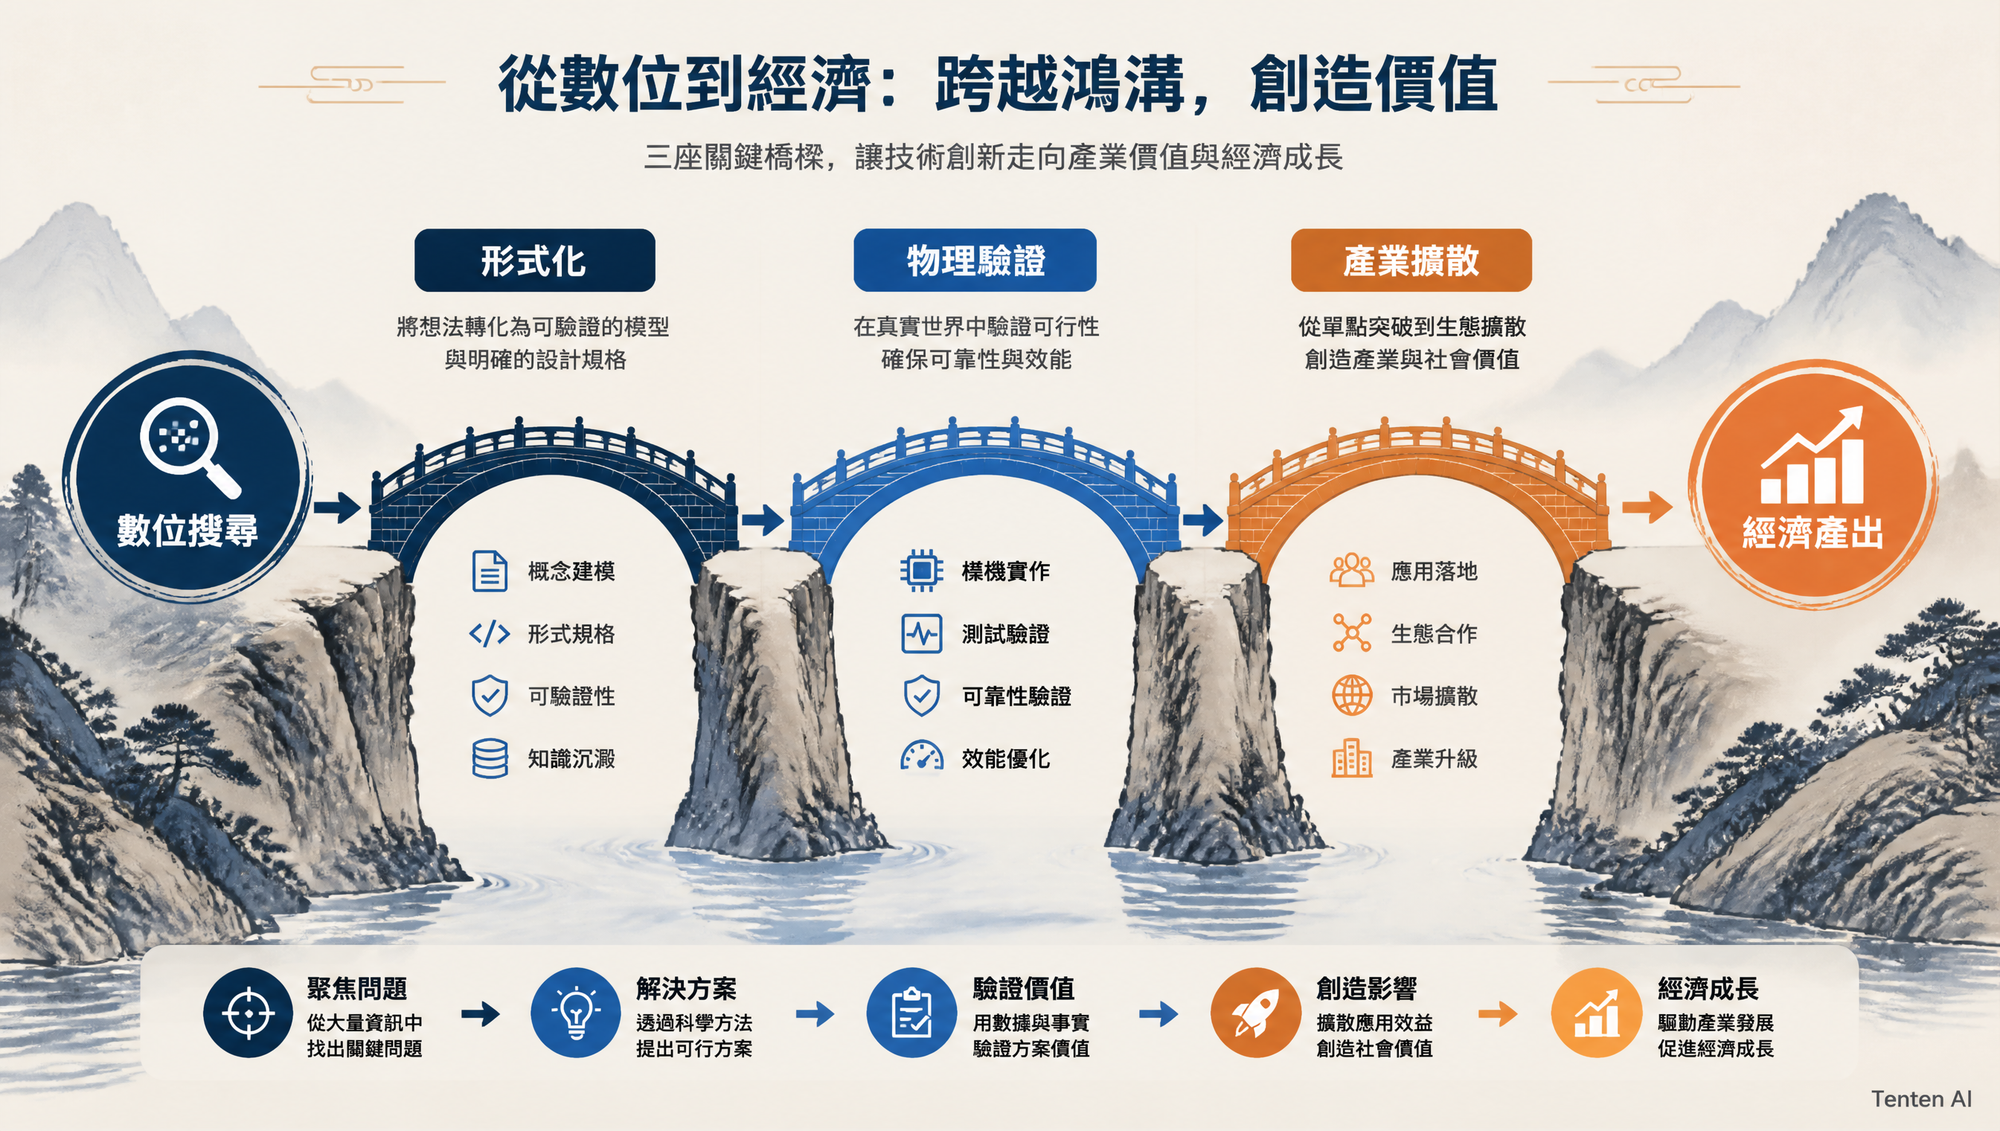
OpenAI 用約 10,000 個 AI agents,在 88 小時內產出 Navier–Stokes 解答;這證明算力能大幅擴張數位研究的搜尋量,卻還不能證明科學家已被 GPU 取代。 從數學證明走到新材料、藥物或能源技術,至少還要跨過問題形式化、物理驗證與產業擴散三道關卡。企業真正該追的指標,是每個可驗證成果的成本,以及成果進入生產的時間。agent 與 token 數只能說明搜尋規模。
萬名 agents 真正證明了什麼
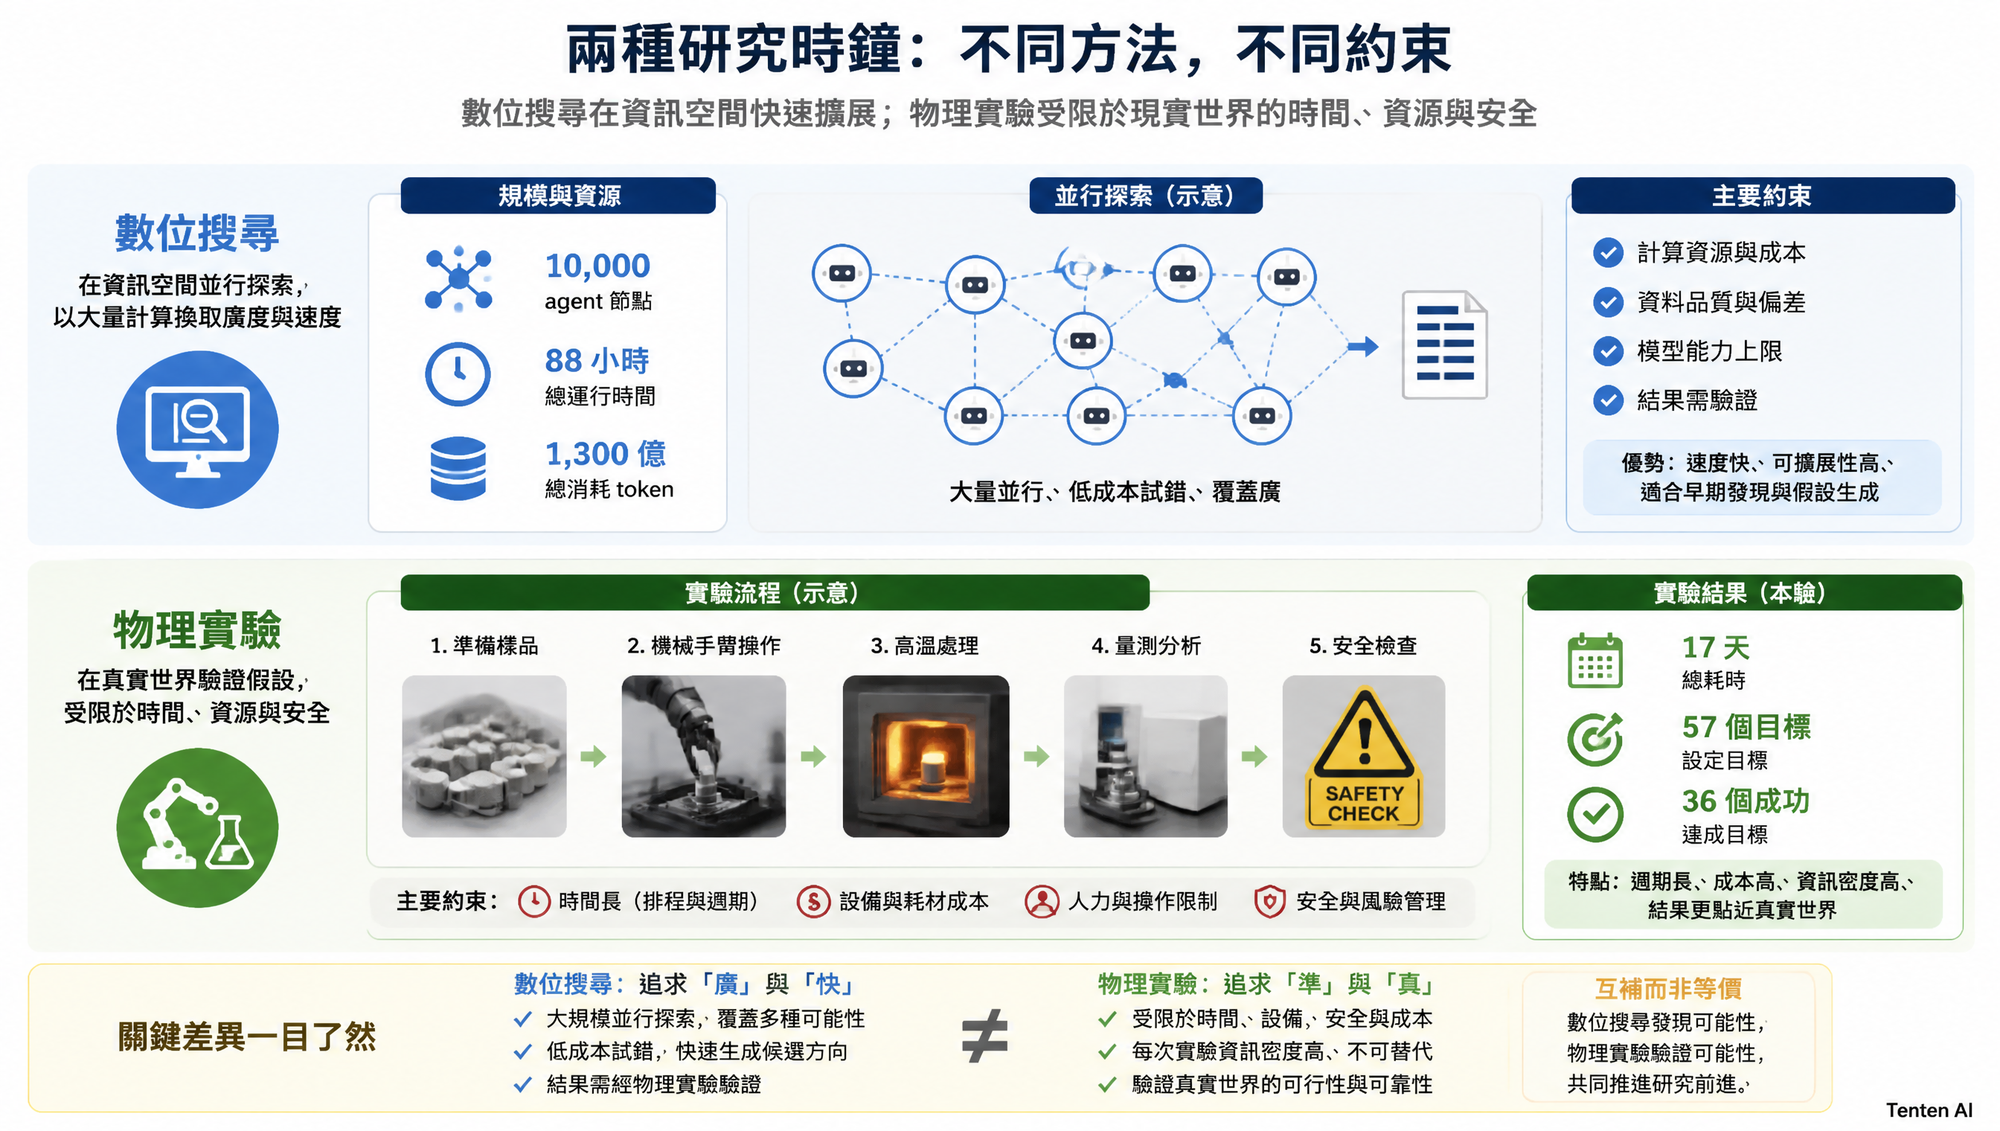
OpenAI 在 2026 年 9 月 8 日公開一份分析證明和 Lean 形式化檔案。公司表示,內部系統先讓近 100 個 agents 花約 50 小時處理 Euler 方程,再把線索交給更大的群組。Navier–Stokes 階段動用約 10,000 個 agents,歷時 88 小時,交換 270 萬則訊息,產出約 1,300 億個 token。GPT-6 Astra 又花 17 小時完成形式化。
這組數字顯示一種新能力:研究單位可以同時探索大量假設,再讓模型整理中間成果。訓練算力提高基礎模型能力,推論算力延長單一任務的思考時間,多 agent 算力則擴大平行搜尋。三者確實形成新的研發規模軸。
不過,Clay Mathematics Institute 截至 9 月 10 日仍把 Navier–Stokes 列為未解。OpenAI 公開的是可供審查的重大主張,還不是獎項機構已接受的結論。Lean 能檢查寫入系統的定義與推導,外部專家仍須判斷形式化命題是否完整對應原題。
| 證據 | 可支持的結論 | 不能直接推出的結論 |
|---|---|---|
| 約 10,000 個 agents、88 小時 | 大規模平行搜尋可壓縮特定數位研究流程 | 所有科學問題都能用相同比例加速 |
| 270 萬則訊息、1,300 億個 token | 協調系統能處理龐大中間結果 | 訊息越多,研究價值必然越高 |
| Lean 形式化花 17 小時 | 已編碼命題可由核心程式逐步檢查 | 物理模型、實驗設計和現實條件都正確 |
| Clay 仍列為未解 | 獨立審查尚未走完 | OpenAI 的證明必然錯誤 |
第一關:研究問題必須能被形式化
數學適合大規模 agent 搜尋,因為目標、符號和檢查規則能寫得相對清楚。程式驗證、演算法搜尋與部分晶體結構預測,也有類似條件。錯誤答案可以被測試、編譯器或形式化工具快速淘汰。
許多科研問題沒有這種乾淨的回饋。藥物是否安全、電池能否撐過數千次循環、核融合材料能否承受長期中子照射,都不能只靠文字或形式證明決定。研究人員仍要選擇問題、定義代理指標,並判斷模型省略了哪些現實因素。
「科研不再依靠天才,只依靠 GPU」因此說得太快。算力降低搜尋成本,領域知識則決定搜尋空間是否值得探索。若目標函數寫錯,更多 agents 只會更快地把資源投入錯誤方向。
第二關:數位答案要走進物理世界
柏克萊的 A-Lab 提供較接近現實的對照。這座自主實驗室結合計算、文獻資料、機器學習、主動學習和機器人,在 17 天內嘗試 57 種無機材料,成功合成 36 種,成功率約 63%。這是自動化科研的具體成果,也揭露它的限制。
A-Lab 未取得的目標包含反應速度太慢、前驅物揮發、材料非晶化,以及零度計算模型的誤差。團隊手動研磨並提高溫度後,又取得兩種材料。實驗站的平均例外率約 3.9%,耗材補充和部分異常仍需人工處理。
這些數據不支持「數千次實驗會自動縮成數十次」的普遍結論。封閉迴路系統能減少盲目嘗試,成效仍依賴設備、感測器、材料特性與回饋品質。軟體 agents 可以快速複製,熔爐、試劑、生物樣本和安全審查卻有真實的時間與產能上限。
第三關:發現不會立即變成 GDP
研究成果要進入國內生產毛額,還得通過工程放大、資本支出、供應鏈、法規與市場採用。新材料在實驗室合成成功,不代表工廠能以穩定良率量產;新藥找到候選分子,也不代表臨床安全與療效已成立。
經濟學家 Nicholas Bloom、Charles Jones、John Van Reenen 與 Michael Webb 研究美國資料後指出,為了維持相近的技術進步速度,投入的研究人力持續增加。以半導體為例,維持摩爾定律所需的研究人數,從 1970 年代初到研究期末增加約 18 倍。AI 若能提高研究生產力,確實可能緩解這個問題。
生產力提升仍有時差。企業必須把發現轉成設備、流程和產品,員工也要學會採用。當實驗與部署環節沒有同步擴充,數位研究的速度越快,待驗證的候選清單反而越長。
三種算力擴張,各自有不同瓶頸
訓練算力改善模型的通用能力,但成本、資料品質和收益遞減會限制每次升級。推論算力可以讓模型搜尋更久,前提是評估器能辨識較好的答案。多 agent 算力擴張平行探索,卻可能產生重複路線、共同偏誤與協調成本。
因此,萬名 agents 不能只看成萬名獨立科學家。它們通常共享模型、資料和提示設計,錯誤也可能高度相關。真正有價值的協調系統,必須鼓勵方法多樣性,保留失敗紀錄,並用外部工具或專家驗證關鍵節點。
| 擴張軸 | 主要收益 | 關鍵瓶頸 | 應追蹤指標 |
|---|---|---|---|
| 訓練算力 | 提高基礎能力 | 資料品質、成本、收益遞減 | 每代模型的可重現能力增幅 |
| 推論算力 | 延長搜尋與修正 | 評估器品質、延遲、單次成本 | 每個通過驗證成果的成本 |
| 多 agent 算力 | 平行探索更多路線 | 重複、相關錯誤、溝通負擔 | 獨立有效路線比例 |
| 實驗算力 | 關閉物理回饋迴路 | 設備、耗材、安全、排程 | 從候選到實驗確認的時間 |
「AI 自我改進」仍不是已證實的正回饋循環
AI 協助研究 AI,已經出現在程式撰寫、資料整理、實驗排程與模型評估。這可以提高研發效率。它和「遞迴式自我改進」仍有差距。
後者需要一連串可重複的封閉迴路:模型提出改進,改進經獨立評估後確實提高能力,新模型再用新增能力產生下一輪提升,而且安全與成本沒有失控。單次研究突破、更多 token 或更快的程式開發,都不足以證明這條循環已經成立。
企業在評估 AI 科研時,應要求逐輪的能力增量、人工介入量、總成本,以及失敗率。沒有這些資料,「自我改進」只是對未來的推測。
哪些產業會先受影響
最先加速的領域,通常具備三個條件:問題能數位化、回饋能自動驗證、試錯成本低。數學、軟體、晶片設計的部分流程,以及有高品質模擬器的工程問題,較接近這個條件。
材料與化學可以透過自主實驗室縮短迴圈,但需要昂貴硬體。藥物、航空、電池與核融合還受到生物安全、長期耐久、極端環境和監管限制。它們會採用更多 agents,速度卻不會只由 GPU 數量決定。
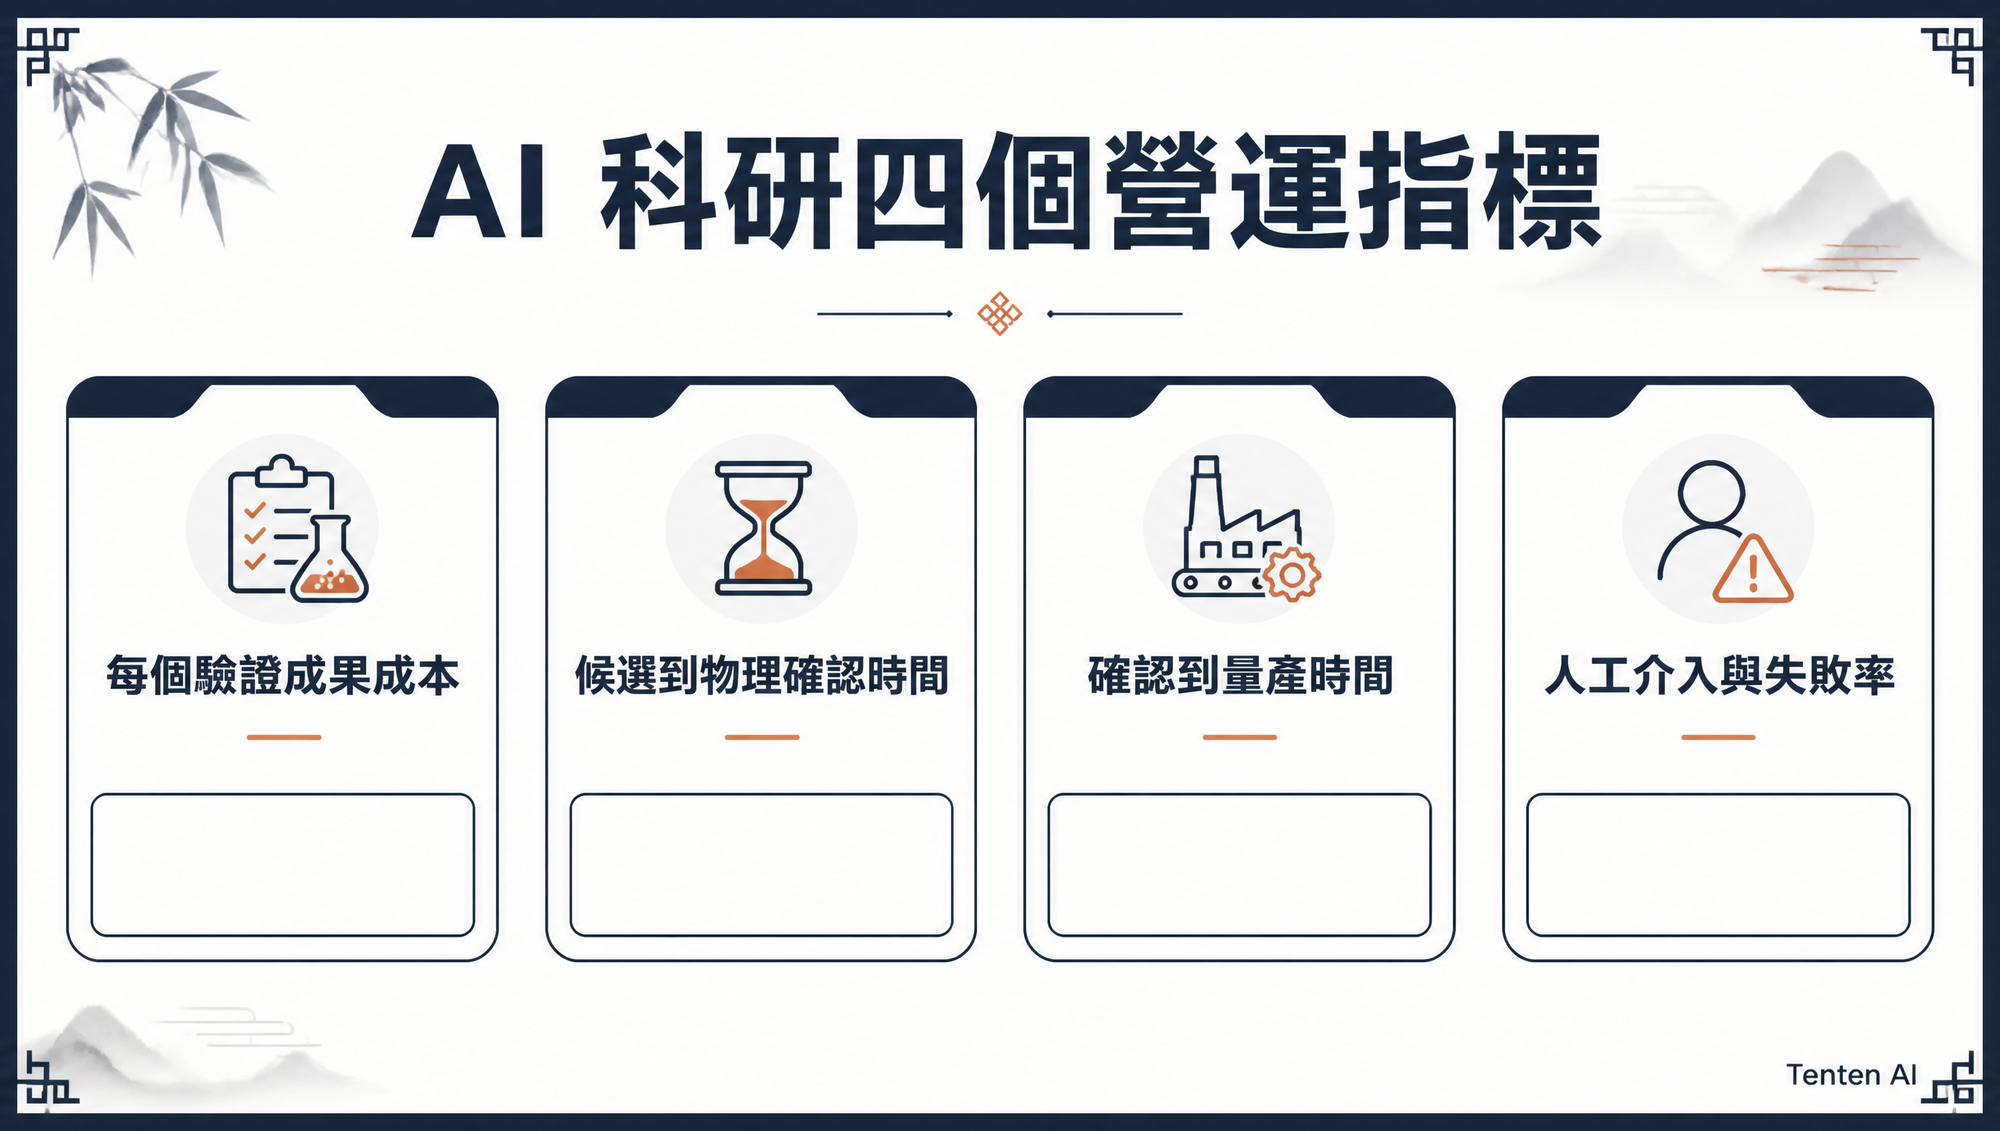
投資人和研發主管可把「每個可驗證成果的成本」設為第一指標,再追蹤「從數位候選到物理確認的時間」與「從確認到量產的時間」。這三個數字比 agent 數和 token 數更接近商業價值。
FAQ
OpenAI 是否已正式解決 Navier–Stokes 千禧年難題?
OpenAI 已公開分析證明與 Lean 形式化,並主張解決官方 C、D 命題。Clay 截至 2026 年 9 月 10 日仍將問題列為未解,獨立審查尚未完成。
10,000 個 agents 是否等於 10,000 位科學家?
不等於。agents 可平行搜尋,但常共享模型、資料與提示,因此錯誤可能相關。人類仍負責問題設定、驗證標準與現實條件判讀。
自主實驗室是否已能取代研究人員?
A-Lab 在 17 天內合成 36 個目標材料,證明自動化封閉迴路有效。它仍有計算與實驗失敗,也需要人工處理設備、耗材和例外。
AI 科研是否會立刻推高 GDP?
不會自動發生。研究生產力可能提高,但成果還要通過實驗、工程放大、資本投資、法規與市場採用,才會反映在經濟產出。
權威引用
- OpenAI:On the Navier–Stokes Millennium Prize Problem
- Clay Mathematics Institute:The Millennium Prize Problems
- Nature:An autonomous laboratory for the accelerated synthesis of inorganic materials
- American Economic Review:Are Ideas Getting Harder to Find?
Author Insight
算力正在變成科研產能,但產能的單位必須是通過獨立驗證的成果。只報 agents、訊息或 token,會把搜尋規模誤當成科學產出。企業若同時投資形式化工具、自主實驗設備和部署流程,才有機會把數位速度變成經濟價值。
術語表
| 術語 | 說明 |
|---|---|
| 多 agent 系統 | 多個模型實例平行或協作完成任務的系統 |
| 形式化證明 | 把定義與推導寫成可由證明助理逐步檢查的程式 |
| 自主實驗室 | 能規劃、執行、量測並依結果調整下一輪實驗的設備系統 |
| 研究生產力 | 每單位研究投入帶來的可驗證知識或技術進步 |